
O czym jest ten film
- Większość programistów używa AI, żeby szybciej pisać kod dziś — i przegapia większą okazję: zbudowanie systemu, który przyspieszy ich pracę jutro i każdego kolejnego dnia.
- Compound Engineering (inżynieria kumulatywna) to proces, w którym każde zadanie jest inwestycją: przegląd kodu uczy system, a poprawka błędu staje się regułą, którą system już nie złamie.
- W przeciwieństwie do zwykłej sesji z AI, gdzie po przekroczeniu limitu kontekstu tracisz wszystko, ta wiedza zostaje zapisana w plikach konfiguracyjnych i działa jak procent składany.
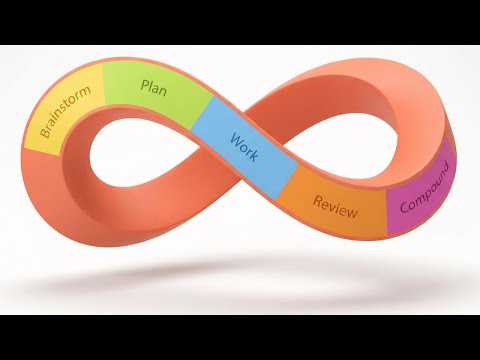
- Proces ma pięć kroków: burza mózgów, planowanie, praca, przegląd i kumulacja — a złoty podział czasu to 80% na planowanie i przegląd oraz 20% na samo kodowanie.
- Wtyczka do Claude Code instaluje się dwiema komendami i daje 27 agentów, 20 komend, 14 umiejętności oraz serwer MCP Context7 z aktualną dokumentacją ponad stu bibliotek.
- Autor demonstruje całą pętlę na własnym blogu (Next.js + MDX): buduje CLI generujące obrazy nagłówkowe artykułów, korzystające z API Nano Banana Pro.
- Plan i kod są recenzowane równolegle przez wyspecjalizowane agenty — w tym recenzenta stylizowanego na DHH — które szukają realnych problemów, a nie po prostu schlebiają.
- Praktyczna przestroga: agent nie widzi plików ignorowanych przez gita (jak
.env), więc trzeba mu jawnie powiedzieć o ukrytych konwencjach projektu. - Krok „compound” zamienia komentarze z recenzji w trwałe zasoby: checklisty przeglądowe, wzorce testów, strategie zapobiegania podobnym błędom.
- Zespół Every, autor wtyczki, deklaruje skrócenie czasu wdrożeń z tygodnia do 1–3 dni; na GitHubie projekt ma ponad sześć tysięcy gwiazdek.
10 najważniejszych takeaways — z kontekstem zastosowania
1.Traktuj każdą sesję z AI jako inwestycję, nie jednorazowy wydatek
Na czym polega: Standardowy schemat to prompt → kod → wdrożenie → czysta karta. W Compound Engineering twoje uwagi z przeglądów stają się domyślnymi ustawieniami na przyszłość, zapisanymi w plikach konfiguracyjnych i stosowanymi automatycznie przy kolejnych zadaniach.
Jak stosować: Po każdym zadaniu zatrzymaj się i zapisz wnioski (nawet ręcznie) do pliku, po który narzędzie sięga przy każdej sesji — zamiast powtarzać te same polecenia w czacie.
Na co uważać: Wiedza zostająca w historii rozmowy przepada przy wyczyszczeniu kontekstu. Jeśli jej nie utrwalisz w pliku, jej nie masz.
2.Dziel czas 80/20: planowanie i przegląd ponad pisanie kodu
Na czym polega: Autor powtarza zasadę całego procesu: 80% czasu na planowanie i przegląd, 20% na kodowanie. Dobry plan sprawia, że pisanie kodu jest praktycznie automatyczne.
Jak stosować: Zanim pozwolisz agentowi wygenerować cokolwiek, dopracuj specyfikację i pozwól narzędziu dopytać o szczegóły. Kod powstaje na końcu, nie na początku.
Na co uważać: Presja „niech już coś napisze” — to ona rodzi przerabianie tego samego błędu po wielokroć.
3.Zacznij od wywiadu, gdy zadanie nie jest w pełni określone
Na czym polega: Komenda /workflows:brainstorm uruchamia rozmowę, w której AI zadaje nieoczywiste pytania, wyłapuje przypadki brzegowe i samo pisze pełną specyfikację — m.in. o wybór mechanizmu (CLI, hook pre-commit), spójność stylistyczną i to, czy obraz ma powstawać z treści artykułu.
Jak stosować: Opisz chęć jednym akapitem i pozwól się wypytać. Wszystkie decyzje i otwarte pytania lądują potem w dokumencie, na którym opiera się plan.
Na co uważać: Wywiad można pominąć tylko przy wąsko zdefiniowanych funkcjach, których ograniczenia i granice znasz na pamięć.
4.Recenzuj plan, zanim powstanie kod
Na czym polega: Przed realizacją można puścić kilka agentów na sam plan. W filmie trzy z nich — w tym recenzent stylizowany na DHH i jeden z twórców procesu — wskazały mocne i słabe punkty, a agent prostoty zasugerował generowanie jednego obrazu zamiast dwóch.
Jak stosować: Po wygenerowaniu planu uruchom jego przegląd, przejrzyj rekomendacje i świadomie rozstrzygnij, które przyjąć. Decyzja należy do ciebie, nie do agenta.
Na co uważać: Zgadzanie się na wszystko bez czytania. Sugestie agentów bywają trafne, ale to ty odpowiadasz za architekturę.
5.Wymieniaj uprzejme „wygląda dobrze” na recenzję z wielu perspektyw
Na czym polega: Standardowe recenzje AI są grzeczne — chcą zadowolić użytkownika. Agenty z omawianej wtyczki są zbudowane i wytrenowane po to, żeby chronić: sześć z nich (bezpieczeństwo, wydajność, architektura, prostota, rozpoznawanie wzorców, perspektywa Agent Native) patrzy na ten sam kod z osobna i raportuje ustalenia według priorytetów.
Jak stosować: Przy każdym pull requeście uruchamiaj zestaw recenzentów zamiast jednego. Raport zwykle wskazuje lokalizację problemu, opis, rekomendację i werdykt „czy można scalać”.
Na co uważać: Na klasyfikację: kwestie krytyczne (P1) blokują scalenie, ważne (P2) warto naprawić od razu, drobiazgi (P3) mogą poczekać.
6.Pamiętaj, czego agent nie widzi w repozytorium
Na czym polega: Podczas demo system założył, że klucz API siedzi w pliku .env.local, podczas gdy autor używa .env. Plik ten trafił do .gitignore, więc model nie mógł wiedzieć, że istnieje — i po cichu przyjął własne założenie.
Jak stosować: Informuj narzędzie o wszystkim, czego nie widać w repozytorium: plikach lokalnych, sekretach, nietypowych konwencjach. Jedno zdanie w stylu „klucze trzymam w .env” oszczędza debugging.
Na co uważać: Agent nigdy nie sygnalizuje, że czegoś nie wie — po prostu dobiera najbardziej prawdopodobną wersję.
7.Domknij pętlę: krok kumulacji po każdym przeglądzie
Na czym polega: Komenda /workflows:compound przegląda wszystkie komentarze — agentów i twoje — oraz wygenerowane dokumenty, wyciąga z nich wzorce i aktualizuje konfigurację. Efektem są m.in. checklista przeglądu kodu, strategie zapobiegania, wzorce testów i ściągi dla recenzentów.
Jak stosować: Po zakończonym przeglądzie zawsze uruchamiaj ten krok. Odtąd daną uwagę podajesz raz — system ją przyswaja i więcej nie musisz jej powtarzać.
Na co uważać: Reguły się nawarstwiają, więc co jakiś czas przejrzyj wygenerowane pliki, żeby nie pracowały przeciw sobie.
8.Zacznij od małej skali kumulacji
Na czym polega: Nie trzeba od razu wdrażać 27 agentów. Autor radzi stworzyć jednego własnego agenta, który zapisuje twój styl recenzowania — np. pięć rzeczy, które najbardziej cię irytują w cudzym kodzie.
Jak stosować: Wypisz swoje najczęstsze uwagi, zamień je w instrukcję dla agenta recenzenta i pozwól zestawowi rosnąć wraz z projektami.
Na co uważać: Nadmiar reguł na starcie utrudnia ocenę, które realnie coś zmieniają. Lepiej dodawać po jednej.
9.Policz tokeny przeciwko ludzkim godzinom
Na czym polega: Tuzin agentów zużywa więcej tokenów niż pojedynczy prompt, ale w całym omawianym procesie autor wyczyścił kontekst tylko raz i skończył na poziomie połowy okna kontekstowego.
Jak stosować: Mierz zużycie przy pierwszych pętlach i porównuj z czasem zaoszczędzonym na przeglądach oraz liczbą unikniętych błędów. Wymieniasz tokeny na ludzkie godziny, mniej awarii na produkcji i szybsze dostarczanie.
Na co uważać: Nie zamykaj sesji bez zapisania wniosków — wtedy wydana „waluta” nie wraca żadnym zyskiem.
10.Zmień pytanie: z „jak to zakodować?” na „czego system ma się tu nauczyć?”
Na czym polega: Sedno zmiany myślenia: przestajesz pytać, jak napisać lub naprawić konkretny fragment, a zaczynasz się zastanawiać, jaka trwała reguła ma wyniknąć z tego zadania.
Jak stosować: Przy każdym zadaniu, także drobnym, zadaj sobie pytanie o wniosek do zapisania — a dopiero potem sięgaj po klawiaturę.
Na co uważać: Nie każde zadanie generuje regułę. Selekcjonuj wnioski, inaczej system zaleje cię truizmami.
Redakcyjne tłumaczenie
Dziś szybciej, a co z jutrem?
Większość programistów używa dziś AI po to, żeby szybciej pisać kod. Przy okazji tracą z oczu znacznie większą okazję: zbudowanie systemu, który przyspieszy ich pracę jutro — i każdego kolejnego dnia.
Istnieje podejście o nazwie Compound Engineering (inżynieria kumulatywna), w którym każde zadanie jest inwestycją. Każdy przegląd kodu czegoś nowego uczy system. Każda poprawka błędu staje się regułą, której system już nie złamie. I w przeciwieństwie do zwykłej sesji z AI, w której po przekroczeniu limitu kontekstu tracisz wszystko, ta wiedza zostaje. Co ważniejsze — pracuje na siebie jak procent składany.
W tym materiale zbuduję funkcję w istniejącym już projekcie, jakim jest mój blog: stworzę generator obrazów, przejdę przez przegląd kodu, wdrożę zmiany, a na koniec pokażę, jak system uczy się na całym tym procesie — i dlaczego w każdej następnej sesji będzie po prostu lepszy. Zaczynajmy.
Czym jest inżynieria kumulatywna
Najpierw zobaczmy, jak większość ludzi pracuje z narzędziami do kodowania z AI. Wysyłasz prompt, narzędzie pisze kod, wdrażasz go — i zaczynasz od zera. Czysta karta.
Inżynieria kumulatywna odwraca ten schemat: każde zadanie ułatwia następne. I nie chodzi o to, że „AI coś tam pamięta”. To proces, w którym twoje uwagi stają się ustawieniami domyślnymi na przyszłość — zapisanymi w plikach konfiguracyjnych i stosowanymi automatycznie do każdego kolejnego zadania.
Pięć kroków procesu
Cały cykl składa się z pięciu kroków.
Pierwszy to burza mózgów, czyli rozmowa z AI w obie strony. Jeśli oglądaliście mój wcześniejszy film, w którym Claude przeprowadza z tobą wywiad, żeby zbudować specyfikację — to jest dokładnie to, tylko lepiej. I to zaledwie pierwszy element całego systemu. Zamiast samemu układać idealny prompt uruchamiający taki wywiad, wystarczy odpalić /workflows:brainstorm i opisać, czego chcesz. Reszta dzieje się sama: Claude zadaje nieoczywiste pytania, wyłapuje przypadki brzegowe i pisze za ciebie pełną specyfikację.
Drugi krok to planowanie. Agenty badają twoje repozytorium, przeszukują internet i tworzą na tej podstawie szczegółowe założenia — zakorzenione w twoim własnym kodzie, a nie w ogólnikach.
Trzeci krok to właściwa praca, w której agenty realizują plan. Jeśli dwa pierwsze etapy zostały zrobione porządnie, ta część jest najłatwiejsza.
Czwarty to przegląd: paczka wyspecjalizowanych agentów sprawdza kod równolegle i zwraca ci wyniki.
No i piąty — ten najważniejszy, serce całego pomysłu: kumulacja. Zapisujesz to, czego nauczyła się dana sesja, i wplatasz z powrotem do systemu. Gdy wracasz do kroku pierwszego i znów przechodzisz plan, pracę i przegląd, efekty zaczynają się sumować. System staje się coraz sprawniejszy i wie o tobie, o twoim projekcie i twoich wymaganiach coraz więcej.
Kluczowa zasada — i pewnie nie tylko tego procesu — brzmi: 80% czasu przeznaczaj na planowanie i przegląd, a zaledwie 20% na samo kodowanie. Przy dobrym planie pisanie kodu odbywa się praktycznie automatycznie.
Instalacja i to, co dostajesz
Zainstalujmy wtyczkę i zobaczmy, co potrafi. W Claude Code (Informacja dodatkowa: Claude Code to działający w terminalu asystent programistyczny od Anthropic.) zajmuje to dwie komendy: najpierw dodajesz repozytorium z wtyczkami, potem instalujesz sam dodatek. Da się to uruchomić także w OpenCode i Codexie, ale tam projekt jest jeszcze na etapie eksperymentalnym.
W ramach jednej wtyczki otrzymujesz 27 różnych agentów, 20 komend, 14 umiejętności, z których agenty mogą korzystać, oraz jeden serwer MCP. Rozkład sił wygląda tak: 14 agentów przegląda bazę kodu z różnych perspektyw, cztery zajmują się researchem, trzy designem, pięć procesami pracy, a jeden dokumentacją. Do tego serwer Context7 MCP daje dostęp do zawsze aktualnej dokumentacji ponad stu bibliotek — nie pracujesz więc na przeterminowanych opisach API.
Krok 1: burza mózgów, czyli wywiad przeprowadzony przez AI
Krok pierwszy jest formalnie opcjonalny, ale moim zdaniem kluczowy. To właśnie tu AI przeprowadza z tobą wywiad i zadaje wszystkie te pytania, o których sam byś nie pomyślał. Można go pominąć i wskoczyć od razu do planowania — ma to jednak sens wyłącznie wtedy, gdy funkcja jest bardzo wąsko określona, a wszystkie ograniczenia i granice masz w małym palcu i chcesz po prostu szybko coś zaplanować. Gdy zadanie wymaga namysłu, jak ma się współgrać z resztą układanki, zaczynasz od burzy mózgów.
Odpalam. Wtyczkę mam już zainstalowaną tymi dwiema komendami. Mój blog to projekt w Next.js z MDX (Markdown rozszerzony o komponenty), w którym wszystko edytuję w plikach tekstowych zamiast w systemie CMS. Zaczynam rozmowę: chcę dodać generowane przez AI obrazy nagłówkowe do publikowanych artykułów — zobaczmy, jak zrobić to najprościej.
System od razu rozeznał mój setup: zna wzorce, wie, co gdzie trafia i jak obrazy są włączane do tekstów. Potem zaczął mnie wypytywać. Przeszedł przez wszystkie etapy wywiadu i zadał sporo dobrych pytań: gdzie umieścić obraz i jak go generować — może CLI, może hook pre-commit, może coś jeszcze innego? Czy wszystkie artykuły mają mieć jeden spójny styl marki, czy raczej styl dopasowany do tematu? Czy obraz ma powstawać na podstawie treści artykułu — na co się zgodziłem, z opcją dorzucenia własnego promptu, jeśli zechcę. Opisałem też pożądany styl wizualny całej marki. Ostatecznie wybraliśmy CLI jako sposób generowania. System wytłumaczył mi wszystkie podejścia i jedno polecił, żebym mógł podjąć świadomą decyzję. Teraz można iść dalej.
Krok 2: planowanie zakorzenione w twoim kodzie
Jeśli burza mózgów się udała, planowanie jest banalnie proste. Zobaczmy, co wygenerował poprzedni etap. Powstał nowy katalog docs z podkatalogiem na burze mózgów i pełnym podsumowaniem: co budujemy, jak będzie używane, co dokładnie zrobi skrypt, dlaczego wybraliśmy to podejście, jakie zapadły kluczowe decyzje i — co równie ważne — jakie pytania pozostały otwarte. System już na tym etapie się uczy i pamięta, co i dlaczego zostało ustalone. Gdyby ktoś pominął burzę mózgów, planowanie wyglądałoby podobnie: krótka charakterystyka funkcji, ewentualnie kilka dopytujących słów i gotowy plan, wciąż oparty o rzeczywisty kod w repozytorium.
Przechodzę do tworzenia planu implementacji. W tym etapie działo się sporo. Wtyczka wzięła świeżo wygenerowany plik z burzy mózgów i od razu wystartowała dwa agenty: pierwszy badał repozytorium, drugi — agent „learnings researcher” — uczył się z dokumentu z zebranymi ustaleniami (im więcej takich dokumentów przybędzie, tym bardziej się przyda). System rozpoznał wzorce w kodzie, zorientował się, skąd co wynikać powinno, i zauważył, że zadanie wymaga zewnętrznego API Nano Banana (Informacja dodatkowa: „Nano Banana” to potoczna nazwa modelu Google do generowania obrazów; wersja Pro to jego nowsza, mocniejsza odmiana.), po czym sięgnął po najświeższą dokumentację Nano Banana Pro i poczynił kilka propozycji. Kolejny agent przeanalizował wszystko, co dotąd powstało, wskazał luki, uzupełnił je i skonsolidował całość w planie. Tak w katalogu docs pojawił się podkatalog plans z planem implementacji: co budujemy, jakie rozwiązanie proponujemy, jaki jest przebieg, uwagi techniczne i kryteria akceptacji — pełna rozpiska od początku do końca.
Dalsza droga prowadzi prosto do realizacji, ale można też puścić dodatkowych agentów, żeby oceniły sam plan. I właśnie to robię.
Przegląd planu: trzy niezależne spojrzenia
Natychmiast równolegle wystartowały trzy agenty. Recenzję prowadził agent stylizowany na DHH (Informacja dodatkowa: DHH to David Heinemeier Hansson, twórca Ruby on Rails, znany z kultu prostoty w programowaniu.), dalej Kieran — jeden z twórców tego procesu — oraz recenzent prostoty kodu. Wszystkie trzy miały coś do powiedzenia: wskazały mocne strony i problemy, oceniły jakość kodu, wyłapały kilka kwestii blokujących, a agent prostoty zaproponował generowanie jednego obrazu zamiast dwóch — co w pełni ma sens.
Dostaję listę rekomendowanych zmian. Przeglądam ją i decyduję, co ma sens, a co nie. Zgadzam się z propozycjami, więc zatwierdzam poprawki. System nanosi je na plan implementacji, a skończywszy, rusza do etapu pracy — z całym dorobkiem poprzednich kroków na pokładzie. Ta część powinna być teraz bardzo łatwa: wszystko ma się wydarzyć automatycznie albo prawie.
Krok 3: praca — najprostsza część
Robota skończona, więc zobaczmy, co zostało zrobione. System założył nową gałąź, rozpisał zadania, a potem wykonywał je po kolei — po drodze wpadał na błędy i od razu je naprawiał. Na bieżąco aktualizował plan implementacji o wykonane kroki i na końcu przygotował commit z podsumowaniem. Na nowej gałęzi powstał skrypt wywoływany z linii poleceń, a raport dokładnie mówi, co zmodyfikowano, jakie zależności dodano i jak uruchamiać: domyślnie na podstawie treści artykułu albo treści wzbogaconej o mój własny, dostrajający prompt. Jest też lista wymaganego setupu.
Jedna rzecz jednak umknęła: system założył plik .env.local, a ja mam po prostu .env. Założył tak, bo nie wie o istnieniu mojego pliku — nie trafił do repozytorium, bo siedzi w .gitignore. Claude tego pliku nie widzi i nie zna jego zawartości. Mówię mu więc wprost, że ma przyjąć, iż klucz API siedzi w .env i że już go tam mam. Skrypt został zaktualizowany.
Następnie system wygenerował obraz testowy, sprawdził, czy pasuje do stylu „sztuka klasyczna spotyka nowoczesną technologię”, i zauważył, że plik jest za duży — 1,7 megabajta. Zajął się tym i przetestował ponownie: nowy obraz jest znacznie mniejszy. Wszystko trafiło tam, gdzie trzeba — treść artykułu została zaktualizowana, obraz wpięty na miejsce. Może nie idealny, ale prompt doszlifuje później. Całość wygląda dobrze i jest gotowa.
Żeby było śmieszniej, po tym etapie jestem na 75% okna kontekstowego, więc tym bardziej warto zacząć świeżo — i przejść do przeglądu.
Krok 4: przegląd kodu — sześć agentów, sześć perspektyw
Puszczam stado agentów na kod i zobaczę, co znajdą. Przegląd zakończony — a tę część zawsze czytam od deski do deski. Mogłem podać numer pull requesta czy gałąź, ale ponieważ jestem na właściwej gałęzi i istnieje dokładnie jeden PR, system sam się zorientował, nad którą funkcją pracujemy, i wystawił do niej sześć agentów: bezpieczeństwo, wydajność, strateg architektury, prostota kodu, rozpoznawanie wzorców i perspektywa „Agent Native”. Każdy z nich patrzy na ten sam kod z innej strony i szuka rekomendacji, poprawek oraz błędów.
Na szczęście tym razem brak ustaleń krytycznych najwyższego priorytetu — nic nie blokuje scalenia. Jest kilka ważnych (m.in. brak timeoutu dla API i brak strukturyzowanego outputu) oraz cztery drobiazgi z kategorii „dobrze byłoby mieć”. Dla każdego ustalenia dostaję szczegóły: gdzie leży problem, na czym polega i co zrobić. Raport pokazuje też, co działa dobrze — warto wiedzieć, co w kodzie jest w porządku — a także, które agenty pracowały i jaki padał werdykt: można bezpiecznie scalać, ewentualnie naprawić ustalenia ważne. Wdrażam poprawki dla kategorii ważnych; drobne zostawiam na później. Wszystko gotowe do commita.
Podkreślę: to nie są generyczne recenzje w stylu „wygląda dobrze”. Każdy agent jest wyspecjalizowany. Zwykłe recenzje AI są grzeczne — chcą cię zadowolić. Te agenty są zbudowane i wytrenowane po to, żeby cię chronić, a nie żeby być dla ciebie miłe. Jeśli problem istnieje, go znajdą.
Test na żywo
Wszystko zbudowane i przetestowane, więc zobaczmy to w akcji. Szukam artykułu bez obrazka nagłówkowego — niech to będzie tekst o konsekwencji, którego identyfikator w adresie (tzw. slug) brzmi „consistency”. Uruchamiam npm run generate image z tym slugiem. Skrypt wygenerował obraz na podstawie treści artykułu, skompresował go, zapisał w zadanych wymiarach i zaktualizował blok metadanych na początku pliku (front matter), tak żeby obraz pełnił rolę nagłówkowego. Sprawdzam: wersja online oraz lokalna — wygenerowany obrazek dla artykułu jest na miejscu. Może nie idealny, ale mi się podoba. Wszystko zaktualizowane, żywe i gotowe do wypchnięcia. Commituję i przechodzę do ostatniego kroku.
Krok 5: kumulacja — moment, w którym system zaczyna zarabiać na siebie
Czas zebrać owoce tego kumulującego systemu. Za każdym przejściem tej pętli moje agenty stają się lepsze — a to pierwszy raz, kiedy je uczę, i skorzystam na tym przy każdej kolejnej okazji. Komenda /workflows:compound przegląda teraz wszystkie komentarze przeglądowe — agentów i moje — a także całe rozmowy i wygenerowane dokumenty. Wyciąga wzorce i automatycznie aktualizuje moją konfigurację. Ten krok wykonuje najcięższą robotę, a ja uwielbiam to, co z niej wynika.
Równolegle ruszają cztery agenty: analizują dokumenty, wyciągają z nich wnioski, klasyfikują je, a na końcu tzw. „prevention strategist” — strateg zapobiegania — odpowiada na pytanie: czego się nauczyliśmy i jak zapobiec podobnym problemom w przyszłości. Powstał cały zestaw plików. Pierwszy dotyczy tego konkretnego rozwiązania i zawiera podsumowanie wykonanej pracy, a co ciekawsze — checklistę do przeglądu kodu, analizę bazy kodu, strategie prewencyjne oraz wskazówki testowania API i CLI. Do tego README z przeglądem zawartości: co zidentyfikowano, na co zwracać uwagę przy przeglądzie kodu. Powstał nawet szablon CLI, wzorce testów z przykładami i ściąga dla recenzentów — do pisania nowych skryptów oraz modernizowania istniejącego kodu.
Stąd właśnie nazwa: inżynieria kumulatywna. Każdy przegląd, który przeprowadzisz, ulepsza następny. Nie łatasz po prostu kodu — uczysz system, żeby budował go razem z tobą. Odtąd daną informację zwrotną podajesz raz, system ją przyswaja i nie musisz powtarzać jej nigdy więcej.
Dlaczego to ma znaczenie
Zespół Every, który stworzył tę wtyczkę (Informacja dodatkowa: Every to amerykańskie wydawnictwo internetowe, znane m.in. z tekstów o AI i produktywności; jego zespół inżynierów stoi za omawianym projektem.), twierdzi, że dzięki temu procesowi wdraża znacznie szybciej i dostarcza znacznie lepszy kod. Funkcje, które wcześniej zajmowały tydzień, dziś są gotowe w jeden, maksymalnie trzy dni. Sama wtyczka ma na GitHubie ponad sześć tysięcy gwiazdek i jest aktywnie rozwijana zarówno przez zespół Every, jak i przez społeczność współtwórców. To więc nie tylko moje odkrycie — to realny proces, który działa na produkcji.
Nie obiecuję, że u ciebie wyniki będą identyczne. Ale jeśli przejdziesz te kroki tak, jak pokazałem, i włożysz czas w burzę mózgów, planowanie i przegląd, każde zadanie ułatwi następne, a zyski będą się nawarstwiać.
Zmiana myślenia i rachunek kosztów
Z tym podejściem wiąże się przesunięcie perspektywy. Przestajesz pytać „jak to zakodować?” albo „jak to naprawić?”, a zaczynasz myśleć: „czego system powinien się nauczyć z tego, co właśnie robię?”.
Jedna uwaga o kosztach. Wystartowanie tuzina agentów zużywa więcej tokenów niż pojedynczy prompt — choć okazało się to łagodniejsze, niż się obawiałem: w całym procesie wyczyściłem kontekst tylko raz i teraz jestem na poziomie połowy okna kontekstowego. Całkiem przyzwoicie. A nawet gdyby koszt był wyższy, to w tej wymianie płacisz tokenami za mniej ludzkich godzin, mniej awarii na produkcji, mniej frustracji przy przeglądach — i po prostu szybsze dostarczanie.
Od czego zacząć
Po pierwsze: zainstaluj wtyczkę, a przy następnej funkcji zacznij od workflows:brainstorm i zobacz, jak równoległy research zmienia twoje planowanie.
Po drugie: zacznij kumulację od małego kroku. Stwórz choćby jednego własnego agenta, który zapisuje twój styl recenzowania — na przykład pięć rzeczy, które najbardziej cię irytują — i pozwól systemowi rosnąć razem z tobą.
Po trzecie: po pierwszym przeglądzie kodu uruchom workflows:compound i patrz, jak twoje uwagi zamieniają się w trwałe reguły. To właśnie wtedy wszystko zaskakuje.
Narzędzia do kodowania z AI przyspieszają cię dziś. Inżynieria kumulatywna przyspiesza cię jutro — i każdego dnia potem. Wtyczka jest darmowa, link znajdziesz w opisie. Twoje AI czeka, aż czegoś się od ciebie nauczy. Tym razem to ty go naucz.