
O czym jest ten film
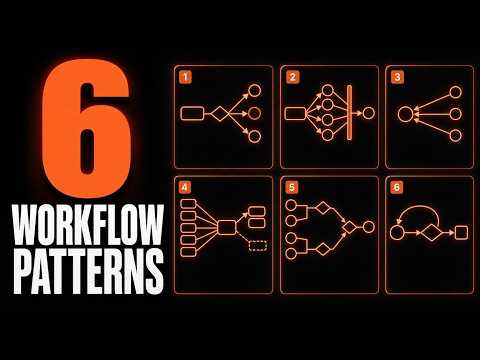
- Inżynierowie Anthropic — twórcy funkcji dynamicznych workflow w Claude Code — opublikowali obszerny przewodnik mistrzowski; autor wydobywa z niego sześć fundamentalnych wzorców projektowych.
- Sedno funkcji to nie samo uruchamianie agentów, lecz zdolność Claude Code do projektowania w locie „harnessu” — maszyny składanej pod konkretne zadanie.
- Powodem istnienia tej funkcji są trzy patologie jednego okna kontekstowego: lenistwo agenta, samouwielbienie i dryf celu, które wychodzą przy ok. 500–600 tys. tokenów rozmowy.
- Rozwiązanie polega na zastąpieniu jednej sesji serią osobnych agentów (domyślnie Sonnet 4.6), z których każdy pracuje we własnym, czystym kontekście.
- Wzorzec „klasyfikuj i działaj”: recepcjonista klasyfikujący wejście, zanim ruszą agenci — np. segregacja skrzynki (błąd/zwrot/lead/spam) z usuwaniem duplikatów.
- Wzorzec „rozprosz i zsyntetyzuj”: równoległe subagenty w czystych kontekstach, każde ustalenie ze ścieżką źródła — research i due diligence.
- Wzorzec „weryfikacja adwersarzyczna”: trzej rzecznicy diabła i kryteria oceny przygotowane przed startem; naturalne zastosowanie to fact-checking tekstów.
- Wzorzec „generuj i filtruj”: nadprodukcja pomysłów redukowana przez sędziego — generator i sędzia muszą być różnymi agentami.
- Wzorce „turniej” (porównania parami w drabince, świeży agent na każdy pojedynek) i „pętla do skutku” (cel zamiast liczby powtórzeń, np. łapanie niestabilnego testu).
- Wzorce można łączyć w łańcuchy; workflow zapisuje się jako plik JavaScript współdzielony jak skill; funkcja jest żarłoczna tokenowo, więc trzeba ustalać budżet — i nie używać jej do drobiazgów.
10 najważniejszych takeaways — z kontekstem zastosowania
1.Dynamiczny workflow to harness sklejany w locie, nie „ozdobne spawnowanie agentów”
Na czym polega: Prawdziwa wartość funkcji nie tkwi w tym, że można uruchomić więcej agentów. Claude Code potrafi w trakcie pracy zaprojektować i złożyć „harness” — coś w rodzaju niewielkiej maszyny budowanej pod konkretny problem. Ta maszyna ma sześć kształtów, które da się zaaplikować niemal wszędzie.
Jak stosować: Zanim napiszesz prompt, ustal, który kształt pasuje do twojego problemu (routing, równoległość, weryfikacja, generowanie, turniej, pętla) — i nazwij go wprost w poleceniu.
Na co uważać: Nie traktuj workflow jako uniwersalnego ozdobnika. Jeśli zadanie spokojnie mieści się w jednej sesji, harness jest zbędnym kosztem.
2.Jedno okno kontekstowe to pamięć krótkotrwała — i ma trzy choroby
Na czym polega: Przy dłuższych zadaniach, po kilkuset tysiącach tokenów, pojawiają się: lenistwo agenta (z piętnastu zadań wykonuje siedem), samouwielbienie (sesja sama przyznaje sobie laurki) i dryf celu (pierwotne ustalenia znikają po kolejnych kompakcjach i streszczeniach).
Jak stosować: Rozcinaj długie zadania na serię osobnych agentów — domyślnie Sonnet 4.6 — z których każdy rozwiązuje wydzielony problem we własnym kontekście.
Na co uważać: Na automatyczną kompakcję: streszczenia wypłukują z historii szczegóły, które decydowały o jakości realizacji celu.
3.Klasyfikuj i działaj: recepcjonista zanim ruszy maszyna
Na czym polega: Lekki klasyfikator rozstrzyga na wejściu, do którego agenta trafia zadanie — zgłoszenie błędu, prośba o zwrot, lead, spam — kwarantannuje wejście i usuwa duplikaty, zanim ktokolwiek zacznie działać.
Jak stosować: Przy segregacji poczty, zgłoszeniach klientów, dokumentach przychodzących. W prompcie wypisz klasy, opisz agenta-klasyfikatora i zasady kwarantanny.
Na co uważać: Klasyfikator ma być prosty — jego rola to decyzja „którym torem”, a nie rozwiązywanie sprawy.
4.Rozprosz i zsyntetyzuj: osobny kontekst na każdą perspektywę
Na czym polega: Zadanie rozpada się na wzajemnie niepokrywające się części, każda trafia do osobnego agenta, a na końcu krok synchronizujący scala wyniki w jedną całość — z cytowaniami.
Jak stosować: Pogłębiony research, due diligence (jeden subagent na podfolder), przeglądy dokumentacji. Każ od każdego agenta ustrukturyzowane streszczenie z dokładną ścieżką źródła przy każdym ustaleniu.
Na co uważać: Na przenikanie się kontekstów — nie pozwól, by jeden agent oglądał kilka części naraz, bo stracisz całą zaletę czystych perspektyw.
5.Weryfikacja adwersarzyczna: najpierw kryteria, potem trzej sceptycy
Na czym polega: Zamiast pozwalać modelowi oceniać samemu siebie, zatrudniasz agentów-rzeczników diabła, którzy odhaczają wynik względem checklisty lub zestawu kryteriów oceny.
Jak stosować: Fact-checking tekstów: ekstraktor wyciąga pojedyncze twierdzenia, każde sprawdzane przez oddzielnego agenta względem źródła, na końcu raport „co się nie obroniło i dlaczego”.
Na co uważać: Kryteria przygotuj przed uruchomieniem — bez nich sceptycy będą oceniać według własnych, nieprzewidywalnych standardów. I nie dopuść, by autor tekstu sam go weryfikował.
6.Generuj i filtruj: z tysiąca pomysłów do trzech schodzi się łatwiej niż z dziesięciu
Na czym polega: Seria agentów nadprodukuje pomysły, a filtr albo sędzia redukuje je do kilku. Nadmiar daje różnorodność, której brakuje przy małej partii propozycji.
Jak stosować: Tytuły, nazwy produktów, pierwsze zdania zimnych maili: generator tworzy np. czterdzieści opcji, sędzia ocenia każdą względem twoich kryteriów.
Na co uważać: Generator i sędzia muszą być różnymi agentami — wypisz to wprost w prompcie. Przy dużych partiach licz też koszt tokenów.
7.Turniej: porównania parami zamiast punktowania „na zimno”
Na czym polega: Ten wzorzec nie dzieli pracy między agentów — organizuje drabinkę. Świeży agent rozstrzyga każdy pojedynek („ta opcja czy tamta i dlaczego”), zwycięzcy awansują do kolejnej rundy aż do finału.
Jak stosować: Ranking dużej liczby elementów, np. pięciu tysięcy CV: każdy pojedynek to osobny agent, deterministyczna pętla trzyma drabinkę, a w kontekście zostaje wyłącznie bieżąca kolejność.
Na co uważać: Każda runda może mieć własne kryteria — zaprojektuj je świadomie. Turniej jest droższy od zwykłego sortowania, więc sięgaj po niego tam, gdzie jakość wyboru naprawdę ma znaczenie.
8.Pętla do skutku: definiuj wynik, nie liczbę powtórzeń
Na czym polega: Zamiast „zrób X dziesięć razy” mówisz „nie przestawaj, dopóki nie osiągniesz konkretnego efektu”; system odpala kolejne próby i nowych agentów, aż dojdzie do celu.
Jak stosować: Niestabilne testy (flaky, padające np. raz na pięćdziesiąt uruchomień): agent bez przerwy tworzy teorie o przyczynie i testuje każdą w izolowanym worktree, bez limitu prób.
Na co uważać: Pętla bez warunku stopu i budżetu potrafi spalić mnóstwo tokenów — jasno określ, co jest sukcesem, i pilnuj limitu.
9.Prawdziwa moc tkwi w składaniu wzorców
Na czym polega: Wzorce łączy się w łańcuchy: rozproszenie → weryfikacja adwersarzyczna → pętla do skutku, wszystko w jednym prompcie.
Jak stosować: Audyt kodu: „rozprosz po agencie na plik, osobny agent próbuje obalić każde ustalenie, pętla trwa do czystego przejścia, zwróć wyłącznie potwierdzone problemy z plikiem i dokładną linią”.
Na co uważać: Nie musisz ręcznie projektować architektury — wystarczą słowa-klucze („rozprosz”, „obalcie”, „zapętlaj do…”). Nadmierna precyzja w tłumaczeniu się modelowi nigdy nie szkodzi.
10.Workflow to plik JavaScript — i bywa po prostu przesadą
Na czym polega: Każdy workflow zapisuje się jako plik JavaScript, który trzyma się w folderze obok skilla (skill.md, workflow.js, kryteria) i współdzieli z zespołem; polecenie /workflows pokazuje działające procesy i pozwala je zapisać.
Jak stosować: Gdy jakiś przebieg się sprawdzi, zapisz go i wersjonuj razem ze skillami, żeby cały zespół korzystał z tego samego.
Na co uważać: Funkcja jest bardzo żarłoczna tokenowo — zawsze komunikuj budżet. Do drobiazgów typu kolor przycisku wystarczy zwykły prompt; im lepsze modele, tym mniej zadań wymaga w ogóle agentów.
Redakcyjne tłumaczenie
Sześć wzorców, które dzielą użytkowników
Między ludźmi, którzy naprawdę rozumieją, jak wycisnąć z dynamicznych workflow maksimum, a tymi, którzy włączają tę funkcję raz i już do niej nie wracają, leży sześć wzorców. Inżynierowie Anthropic — ci sami, którzy ją zaprojektowali i zbudowali — wydali właśnie obszerny przewodnik mistrzowski o tym, jak z niej korzystać. W tym materiale rozbieram go na części, żeby nie musieć czytać całości samodzielnie: przeszedłem przez cały dokument i wyciągnąłem sześć fundamentalnych wzorców projektowych, na których opiera się wszystko inne. Po drodze jest też kilka smaczków o tym, kiedy workflow stosować, a kiedy sobie odpuścić, oraz jak przekazywać je zespołowi.
Większość osób sądzi, że dynamiczny workflow to po prostu bardziej wyszukany sposób uruchamiania agentów. Prawdziwa siła leży gdzie indziej: to zupełnie nowa droga, na jaką Claude Code może projektować i składać w locie tzw. harness — coś w rodzaju niewielkiej maszyny budowanej pod konkretne zadanie, które jej zlecisz. Gdy poznasz sześć kształtów, jakie ta maszyna potrafi przybrać, zastosujesz je w zasadzie w każdym scenariuszu.
Trzy choroby jednego okna kontekstowego
Zanim przejdziemy do samych wzorców, trzeba rozbroić mechanikę, na której stoją — bo to właśnie ona tłumaczy, po co ta funkcja w ogóle powstała. W normalnym trybie zlecasz Claude Code zadanie i działasz w jednym oknie kontekstowym. To w praktyce pamięć krótkotrwała danego zadania i w większości przypadków w zupełności wystarcza. Kłopoty zaczynają się przy dłuższych i bardziej złożonych zleceniach — gdy po pół miliona, sześciuset tysiącach tokenów rozmowy sprawy zaczynają się sypać. Wtedy wchodzą trzy klasyczne patologie.
Pierwsza to lenistwo agenta: dajesz piętnaście zadań, model zapewnia, że wykona wszystkie, a ogarnia siedem.
Druga — upodobanie do własnej pracy. To bolączka najpoważniejsza: prosisz Claude Code, żeby sam audytował siebie i oczywiście wychodzi z tego z laurem. Oceniasz jakość kodu, pytając tę samą, właśnie działającą sesję — a ona będzie stronnicza jak człowiek oceniający własne dzieło: zawsze powie, że wyszło lepiej, niż jest naprawdę.
Trzecia to dryf celu. Na początku sesji masz jasno określony cel, ale po długiej rozmowie, po dziesiątkach automatycznych kompakcji, wywołań narzędzi i streszczeń, detal z samego początku — ten, dzięki któremu model w pełni rozumiał, co ma zrobić i jak — powoli więdnie.
(Informacja dodatkowa: „kompakcja” to automatyczne skracanie historii rozmowy do streszczenia, gdy okno kontekstowe zapełnia się w całości.)
Dynamiczny workflow gasi wszystkie trzy problemy, bo przestaje opierać się na jednej sesji Claude. Zamiast tego uruchamia serię agentów — domyślnie najczęściej Sonnetów 4.6 — z których każdy działa we własnym oknie kontekstowym i osobno rozwiązuje wydzielony problem.
Wzorzec 1. Klasyfikuj i działaj
Zaczynamy od najprostszego wzorca i idziemy w górę. „Klasyfikuj i działaj” (classify and act) to odpowiednik recepcjonistki przy wejściu, która rozstrzyga, do jakiej grupy trafia zadanie albo który agent odpowiada za daną sprawę. Po wejściu stoi bardzo lekki model z prostym promptem systemowym; gdy ten prompt odsiewa właściwego adresata, wyznacza się jedna ścieżka — i tylko ona.
Typowy przypadek: segregowanie skrzynki. Przychodzi e-mail, a AI rozstrzyga: to zgłoszenie błędu? Prośba o zwrot pieniędzy? Prośba o podniesienie planu? Klasyfikacja rozstrzyga, do którego agenta wiadomość trafi.
Inny sposób myślenia o tym wzorcu to kwarantanna: decyzja o przeznaczeniu wejścia zapada w odosobnieniu, zanim cokolwiek ruszy dalej. Najpierw agent-czytelnik i zgłoszenie, a dopiero potem zaufany agent, który podejmuje działanie. Praktyczny prompt wyglądałby tak:
„Zbuduj workflow, który segreguje moją skrzynkę w folderze [nazwa folderu]: uruchom agenta-klasyfikatora, który czyta każde zgłoszenie i kieruje je do obsługi błędów, zwrotów, leadów albo spamu, oraz usuwa duplikaty względem już śledzonych spraw, zanim jakikolwiek agent obsługujący ruszy do działania. [Dopisz], jak ma przebiegać kwarantanna.”
Wzorzec 2. Rozprosz i zsyntetyzuj
Drugi wzorzec polega na wzięciu zadania, rozbiciu go na mikrocząści — dobrane tak, by każda trafiła do osobnego, wzajemnie niepokrywającego się agenta — a potem zebraniu wszystkich pojedynczych wyników i złożeniu ich w jedną całość.
Bardzo praktyczne i powszechne zastosowanie to pogłębiony research. Masz jedno sedno sprawy, którą chcesz zrozumieć — powiedzmy, najlepsze sposoby korzystania z harnessów agentowych. System rozbiera pytanie na wszystkie możliwe perspektywy i na każdą przydziela jednego agenta (domyślnie najpewniej Sonnet 4.6). Wszyscy pracują równolegle, jak subagenty, a na samym końcu zbierasz ich odpowiedzi i składasz jeden zbiorczy wynik. Poza researchem świetnie pasuje do due diligence: finansów, umów, kwestii prawnych — każdy agent wyciąga ze swojej części wszystko, co najważniejsze, do notatki o sygnałach ostrzegawczych. W terminalu dobry prompt wygląda tak:
„Zbuduj workflow, który robi due diligence na data roomie w folderze [nazwa]: rozprosz po jednym subagencie na każdy podfolder, każdy w czystym kontekście, żeby pliki się wzajemnie nie zanieczyszczały; każ każdemu agentowi zwrócić ustrukturyzowane streszczenie z dokładną ścieżką źródła przy każdym ustaleniu. Potem uruchom krok barierowy — zaczekaj, aż wszyscy skończą — i scal wyniki w jednostronicowe podsumowanie due diligence [nazwa pliku], w którym każde twierdzenie odsyła do pliku, z którego pochodzi.”
(Informacja dodatkowa: „krok barierowy” to punkt synchronizacji — czeka, aż wszystkie równoległe agenty zakończą pracę, i dopiero wtedy scala ich wyniki.)
Zwróć uwagę na nacisk położony w tym przykładzie na cytowania i ścieżki źródeł.
Wzorzec 3. Weryfikacja adwersarzyczna
Trzeci wzorzec chciałbym, żeby został z wami na dłużej. Weryfikacja adwersarzyczna łata dziurę zostawianą przez upodobanie modelu do własnej pracy. Zamiast pozwalać Claude Code bezustannie się sobą zachwycać, celowo zatrudniasz trzech sceptyków — rzeczników diabła — którzy oglądają wynik i zestawiają go z checklistą albo zestawem kryteriów oceny. Dodatkowy krok, który warto zrobić jeszcze przed uruchomieniem: przygotuj właściwe kryteria. One pełnią potem rolę quasi-planu, do którego odnoszą się sceptyczni agenci i względem którego odgrywają adwokata diabła.
Naturalne zastosowanie to fact-checking. Jeśli tworzysz cokolwiek przy pomocy AI — bloga, artykuł — i zależy ci na stuprocentowej spójności i poprawności faktów, odpalanie rzecznika diabła na skalę pozwala zawczasu wyłapać problemy i dwuznaczne stwierdzenia. Przykład taktyczny: masz szkic bloga. Z szkicu pracuje ekstraktor, z ekstraktora wyciągasz pojedyncze twierdzenia. Dla każdego trzeba rozstrzygnąć, czy jest faktem — więc odpalasz serię subagentów, a każdy sprawdza jedno twierdzenie i schodzi w swoim temacie tak głęboko, jak trzeba. Gdy wrócą z wynikami — co się potwierdziło, a co obalono — montujesz zweryfikowany raport: co w tym blogu trzeba zmienić. W praktyce:
„Użyj workflow, żeby przejść przez mój post na blogu i zweryfikować każde twierdzenie faktograficzne i techniczne przed publikacją. Niech agent wyodrębní każde twierdzenie jako osobną pozycję; potem dla każdego twierdzenia odpal oddzielnego agenta, który sprawdzi je względem prawdziwego źródła. Dzięki temu sami weryfikatorzy nie podchodzą do sprawy ze stronniczością wobec własnej pracy. Gdy skończysz, zwróć listę twierdzeń, które się nie obroniły, z dokładnym powodem każdej porażki — żebym wiedział, co naprawić — a najlepiej też wskazanie, skąd mogła wyniknąć stronniczość modelu, który tekst napisał.”
Wzorzec 4. Generuj i filtruj
Cała idea czwartego wzorca: uruchamiasz serię agentów, żeby wygenerowały całą masę pomysłów — nazw projektów, czegokolwiek, nad czym brainstormujesz — a potem filtrujesz. Bo zejść z tysiąca pomysłów do trzech jest łatwiej niż z dziesięciu do trzech: po prostu masz większy wybór. Mogę na przykład zapytać: „Jak zatytułować ten film, żeby tytuł komunikował treść, nie będąc clickbaitem? Znajdź zbalansowane pięćset tytułów, które świetnie działały na YouTube w ostatnich pół roku.”
Stosujesz to wszędzie tam, gdzie potrzebny jest smak: pierwsze zdanie zimnego maila, nazwa nowego produktu, miejsce i moment oferty pop-up. Agenci mogą indywidualnie robić research, analizę rynku, mogą dostać podpięte skille — ankiety, scraping, cokolwiek — żeby wrócić z najbogatszym możliwym materiałem, który ty trawisz i redukujesz do kilku pomysłów. A jeśli chcesz podnieść poprzeczkę, wbuduj sędziego w sam workflow: agenci generują pomysły, potem seria sędziów je krytykuje względem przygotowanych przez ciebie kryteriów. Masz wtedy kontrolę jakości nad samymi kontrolerami, a na końcu dostajesz przetestowane, zsyntetyzowane propozycje. Do zastosowania:
„Użyj workflow do zbrainstormowania czterdziestu opcji tytułu i nagłówka wideo na temat [temat]: jeden agent-generator, potem przekaż wszystkie opcje agentowi-sędziego, który oceni każdą względem serii kryteriów. Generator, który wymyśla, i sędzia, który ocenia, muszą być różnymi agentami.”
Może przegiąłem, rozstrzygając za model, ale nadmierne wyjaśnianie się z modelem językowym nigdy nie zaszkodzi.
Wzorzec 5. Turniej
Piąty wzorzec to mój ulubiony: turniej. W przeciwieństwie do wcześniejszych nie dzieli się tu pracy między agentów. Biorzesz pojedyncze pomysły i wysyłasz je do zupełnie świeżych agentów z kontrowersyjnym pytaniem: „wchodzimy w tę decyzję czy nie?”. Agent przechodzi przez wszystkie powody, dla których jedna z dwóch opcji (mogą być trzy, cztery) jest lepsza — i dlaczego. Dobre pomysły i propozycje awansują do kolejnej rundy, aż docierasz do finału. Pojedynki rozgrywają się parami, a na każdym etapie stoi bezstronny agent ze świeżym oknem kontekstowym.
Po co to robić? Bo gdy Claude Code ogląda pięćset decyzji naraz, jego kontekst, pamięć i kompakcje prowadzą do mniej trafnych rozstrzygnięć. Gdy rozbijesz całą przestrzeń decyzji na osobnych agentów, dostajesz też inny sposób prześledzenia, jak dana decyzja zapadła. Zastosowanie łatwo sobie wyobrazić: pięć tysięcy CV. Zamiast przepychać je przez typowy system rekrutacyjny albo jedną sesję Claude Code — gdzie nieuchronnie pojawi się stronniczość, problemy z kontekstem i przeładowanie — rozbijasz stos na konkretne partie: „bierzemy tę osobę czy tamtą? Uzasadnij”. W praktyce możesz mieć tysiąc elementów i kolejne rundy: pierwsza ocenia według kryteriów A, następna według B, aż do finału. Kluczowe zastrzeżenie: każda runda może mieć własne kryteria — nie musisz prowadzić siedmiu, dziesięciu albo pięćdziesięciu rund według identycznego schematu. Przykładowy prompt:
„Użyj workflow, żeby uszeregować każde CV na stanowisko inżyniera backendu, prowadząc turniej porównań parami względem rubryki kryteriów zamiast punktować każde CV «na zimno». Każdy pojedynek to osobny agent porównujący, a deterministyczna pętla trzyma drabinkę — w kontekście zostaje wyłącznie bieżąca kolejność.”
Jeśli chcesz podebrać mi sformułowania: wszystkie prompty znajdziesz w drugim linku pod filmem. Na razie po prostu ustawiamy ton, w jakym ma toczyć się cała drabinka.
Wzorzec 6. Pętla do skutku
Ostatni wzorzec jest bardzo bliski czemuś takiemu jak polecenie /goal. Zamiast mówić agentowi „idź i zrób X dziesięć razy”, mówisz: „nie przestawaj, dopóki nie osiągniesz tego konkretnego rezultatu”. Gdy w danej sprawie pojawiają się nowe ustalenia, proces kręci się dalej: odpalają się nowi agenci, sprawdzają, sprawdzają ponownie i jeszcze raz — aż dojdziesz do zadanego wyniku.
Przykład: bug w platformie, którą skleiłeś na vibe codingu. Pojawia się raz na trzydzieści uruchomień i zwykle trudno go dostrzec — trzeba odświeżać, próbować kolejnych kombinacji, żeby go odtworzyć. Możesz po prostu polecić: badaj i uruchamiaj, dopóki nie dostaniesz buga; gdy go złapiesz, wyśledź, co się dzieje i jak to naprawić. Inne zastosowanie: wyślij taką pętlę na przeszukiwanie wszystkich swoich rozmów — plików JSONL, w których zapisują się sesje Claude Code: „przeglądaj wszystkie te rozmowy pod kątem wszystkich moich wzorców, dopóki nie skompletujesz wyczerpującej, nieduplikatywnej listy wszystkiego, co mogę poprawić, żeby być o tyle lepszym w Claude Code”. Gotowy prompt:
„Zbuduj workflow, który wytropi tzw. flaky test w folderze testów — pada może raz na pięćdziesiąt uruchomień. Niech bez przerwy tworzy teorie o przyczynie i testuje każdą adwersarzyjnie, w osobnym, izolowanym worktree. To w praktyce osobna sesja dla agenta, który zapętla się i odpala kolejne próby bez sztywnego limitu: nie mówimy «sprawdź to dziesięć albo dwadzieścia razy», tylko «sprawdzaj, aż osiągniesz konkretny wynik».”
(Informacja dodatkowa: flaky test to test niestabilny — przechodzi lub pada bez wyraźnej przyczyny; worktree to izolowana kopia drzewa plików repozytorium gita, w której zmiany nie dotykają głównej wersji kodu.)
Składanie wzorców: tu zaczyna się prawdziwa biegłość
To były sześć rdzennych wzorców — ale od samej wiedzy o nich do realnej biegłości prowadzi jedno: układanie ich jeden na drugim. Realistyczny scenariusz: skleiłeś na vibe codingu CRM. Ma ścieżkę onboardingową dla klientów i chcesz ją ulepszyć — przemyśleć porządnie, rozważyć różne kolejności kroków i ich skutki. Najpierw rozpraszasz serię agentów na bazę kodu, żeby wyciągnęły wszystkie spostrzeżenia: co warto zmienić i dlaczego. Gdy spostrzeżenia są na stole, dochodzi wzorzec trzeci — weryfikacja adwersarzyczna: rzecznicy diabła przepytują wszystkie ustalenia. Na to nakładasz pętlę do skutku, np. łączysz ją z /goal: proces trwa, dopóki da się wyciągać kolejne usprawnienia dla konkretnego awatara korzystającego z platformy.
Najlepsze w tym wszystkim: nie musisz niczego projektować ręcznie. Wystarczy używać słów-kluczy we właściwy sposób, żeby dojść do potwierdzonego, satysfakcjonującego wyniku. Wszystko da się spakować w jeden prompt:
„Zbuduj workflow, który audytuje każdy plik w bazie kodu [codebase]: rozprasza po jednym agencie na plik; osobny agent próbuje obalić każde ustalenie względem kodu (weryfikacja adwersarzyczna); i zapętla się, dopóki czyste przejście nie przestanie przynosić nowych problemów. Zwróć wyłącznie potwierdzone problemy, każdy z podaniem pliku i dokładnej linii.”
Dla pewności możesz dorzucić: „/goal: nie przestawaj, dopóki pełne czyste przejście nie znajdzie nowych problemów”. Czy to ostatnie zdanie jest konieczne? Może nie — model i tak by pojął — ale jako dodatkowa warstwa zabezpieczenia śmiało możesz je dodać.
Workflow jako plik JavaScript: zapisywanie i dzielenie się
Workflow można udostępniać bardzo podobnie jak skille. Każdy workflow to w istocie czysty plik JavaScript. Gdy połączysz go z plikiem skilla i ewentualnie zależnymi plikami markdown, otrzymujesz jeden folder: skill.md, plik workflow.js i resztę elementów — na przykład rubrykę kryteriów. A żeby cokolwiek zapisać, wystarczy uruchomić polecenie /workflows: pokazuje ono wszystkie aktualnie działające procesy. Gdy jakiś pracuje, możesz go zapisać — trafia wtedy na dysk jako wspomniany plik JavaScript, gotowy do współdzielenia.
Budżet tokenów i przypadki, w których workflow nie ma sensu
Przewodnik przypomina też, by zawsze komunikować Claude Code budżet tokenowy. Ta funkcja jest bardzo żarłoczna i należy ją oszczędnie stosować — do naprawdę dużych zadań albo takich, które mają wiele warstw złożoności.
Przykład antywzorca: drobiazgi. Jeśli chcesz zmienić kolor serii przycisków w platformie albo dodać pulsowanie po kliknięciu, nie odpalasz przecież drużyny agentów — zwykły prompt załatwia sprawę. I dobrze, bo skoro modele będą coraz lepsze — 4.8, 4.9, 5 — zrobisz coraz więcej coraz mniejszym wysiłkiem. Agenci nie będą potrzebni do wszystkiego. Ale gdy przyjdzie czas na ich siłę, będą pod ręką, a ty użyjesz tych rojów do naprawdę złożonych spraw.
Na koniec
Mam nadzieję, że to rozbiera i odczarowuje cały potencjał, który możesz zostawiać niewykorzystany, nie znając tych wzorców na co dzień. Wszystkie pokazane prompty plus dodatki — na przykład przykładowy folder skilla z workflow w środku — znajdziesz w drugim linku pod filmem: możesz ich użyć, zacząć i powoli podnosić poziom swoich przebiegów.
(Informacja dodatkowa: autor prowadzi płatną społeczność dla wczesnych adopterów z cotygodniowymi modułami o Claude Code; najbliższy moduł na żywo ma dotyczyć dynamicznych workflow — także w zastosowaniach prywatnych, poza biznesowymi, np. przy organizacji podróży.)