
O czym jest ten film
- Chris Raroque, deweloper pracujący głównie w ekosystemie Apple, relacjonuje wizytę na konferencji Microsoft Build w San Francisco — zorganizowanej tam po raz pierwszy, w mniejszym miejscu niż zwykle.
- Prelekcja o budowaniu aplikacji na lokalnych modelach AI zmieniła jego zdanie: jego wrażenie jest takie, że w lokalnej AI Windows wyprzedza Apple.
- Zespół Microsoftu pokazał upscaling wideo w czasie rzeczywistym w całości na urządzeniu: obraz kompresowany jest u nadawcy, a rozscalany dopiero u odbiorcy — to tnie koszty pasma i CDN.
- Kolejna demonstracja: transkrypcja mowy na żywo na kilkuletnim laptopie z niewielką ilością RAM, przy ledwo obciążonym procesorze. Autor przyznaje, że jego aplikacja Lily do nagrywania spotkań lokalnie upadła kiedyś na dokładności i opóźnieniach.
- Windows ML przyjmuje też własne modele (np. z Hugging Face), a pojedynczy interfejs API sam wykrywa dostępny sprzęt i pobiera odpowiedni wariant modelu.
- Ponieważ modele są małe, można je łączyć w stosy: stabilizacja obrazu plus super rozdzielczość albo tłumaczenie na żywo plus napisy — dotąd domena chmury, dziś bezpłatnie na urządzeniu.
- Na stoisku Logitech padła ważna obserwacja: dzięki narzędziom typu Claude Code „każdy jest deweloperem”, więc firmy sprzętowe przeorientowują dokumentację SDK pod agentów AI (plik LLMs.txt).
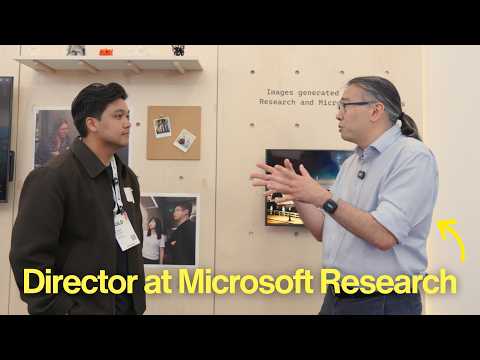
- Najciekawsza rozmowa wyjazdu — z Kenjim Toketą z Microsoft Research o modelu Aurora: pierwszym modelu fundacyjnym systemów Ziemi, prognozującym pogodę i zanieczyszczenia.
- Aurora daje prognozy porównywalne z superkomputerami (dziesięć tysięcy CPU przez godzinę–dwie) w kilka minut na jednym GPU; jest open source, a dotrenowywano ją m.in. pod energetykę i wychwytywanie CO2.
- Wątek osobisty: wyjazd poza bańkę samodzielnych deweloperów — autor odkrywa, że badacze w wielkich firmach pracują w tempie startupów.
10 najważniejszych takeaways — z kontekstem zastosowania
1.Lokalne modele dają radę w czasie rzeczywistym — nawet na starym sprzęcie
Na czym polega: Transkrypcja mowy na żywo działała płynnie na kilkuletnim laptopie z Windowsem, z małą ilością RAM i przy procesorze praktycznie bez obciążenia.
Jak stosować: Zanim założysz, że potrzebujesz chmury albo najnowszego komputera z NPU, przetestuj systemowe API Windows AI na sprzęcie, który już masz.
Na co uważać: To demo przygotowane przez Microsoft — sprawdź własny, realny scenariusz (długie nagrania, wiele aplikacji naraz) zanim podejmiesz decyzję architektoniczną.
2.Upscaling wideo na urządzeniu to policzalna oszczędność
Na czym polega: Wideo kompresuje się już po stronie nadawcy do minimalnej rozdzielczości, a odbiorca odtwarza je i doskaluje lokalnie super rozdzielczością. Mniej pasma, niższe koszty CDN, mniejsze opóźnienia — bez płacenia za model po stronie serwera.
Jak stosować: W aplikacjach wideo rozdziel kompresję transmisji od jakości odtwarzania i przenieś drugą część na urządzenie użytkownika.
Na co uważać: Jakości nie ocenisz po materiale z YouTube, który sam kompresuje i doskaluje obraz — testuj wyłącznie na żywo, na własnym łączu.
3.Małe modele można łączyć w stosy
Na czym polega: Model stacking to uruchamianie wielu lekkich modeli jednocześnie albo łańcuchowo: najpierw stabilizacja obrazu, potem super rozdzielczość; równolegle tłumaczenie i napisy na żywo. Coś, za co wcześniej płaciło się chmurze, dziś działa lokalnie za darmo.
Jak stosować: Projektuj pipeline’y z małych, wyspecjalizowanych modeli zamiast pojedynczego dużego — łatwiej je wymieniać i debugować.
Na co uważać: Każdy element stosu zużywa moc obliczeniową, więc łączny koszt trzeba mierzyć na słabszych konfiguracjach, nie tylko na maszynie deweloperskiej.
4.Własny model plus automatyczny dobór sprzętu
Na czym polega: Do stosu WinML można wpiąć dowolny model z Hugging Face, o ile spełnia obsługiwany standard. Deweloper wywołuje jedno API, a system w trakcie działania sam rozpoznaje najlepszy dostępny układ (NPU, GPU czy CPU) i pobiera odpowiedni wariant modelu.
Jak stosować: Nie pisz osobnych ścieżek dla różnych konfiguracji sprzętowych — oddaj to warstwie systemowej i skup się na logice aplikacji.
Na co uważać: Model musi trafić w obsługiwane standardy, a dostępność zależy od katalogu (Foundry lub zewnętrznego) — zweryfikuj to przed wyborem architektury.
5.Koszt, nie prywatność, przekonuje do lokalnej AI
Na czym polega: W rozmowie na stoisku padło: użytkownicy deklarują troskę o prywatność, ale przy decyzjach decyduje rachunek. Lokalne przetwarzanie to zero opłat za tokeny i niższy łączny koszt działania.
Jak stosować: W rozmowach z klientami czy inwestorami prowadź od oszczędności, a prywatność traktuj jako wzmacniacz argumentu, nie jako główny motor.
Na co uważać: „Lokalnie” nie znaczy automatycznie „taniej” — dolicz koszt sprzętu, utrzymania i czasu pracy nad integracją.
6.Dokumentacja SDK sprzętowego celuje teraz w agentów AI
Na czym polega: Logitech opublikował stronę LLMs.txt — dokument, który wręczasz wprost narzędziu typu Claude Code, żeby nauczyło się korzystać z ich SDK. Kierunek zmiany: skoro każdy może teraz programować, odbiorcą dokumentacji staje się agent, nie tylko zawodowy deweloper.
Jak stosować: Wskaż agentowi kodującemu dokumentację SDK swojego sprzętu i poproś o konkretne dostosowanie — w demie zajęło to około pięciu minut i jedno polecenie.
Na co uważać: Jakość efektu zależy od jakości i kompletności dokumentu przygotowanego pod agenta; nie każde SDK ma już takie pliki.
7.Modele fundacyjne to nie tylko tekst
Na czym polega: Aurora jest modelem fundacyjnym dla systemów Ziemi — prognozuje pogodę, zanieczyszczenie powietrza, burze piaskowe. Trellis zamienia pojedyncze zdjęcie w pełny model 3D. To cała kategoria zastosowań poza LLM-ami.
Jak stosować: Przy szukaniu niszy produktowej rozważ dotrenowanie modelu fundacyjnego z innej dziedziny niż język — dane dziedzinowe bywają mniejszą barierą niż konkurencja na rynku chatbotów.
Na co uważać: Wiele z tych projektów to wciąż badania — dostępność, wsparcie i gotowość produkcyjna bywają ograniczone.
8.Aurora: dokładność superkomputera za ułamek obliczeń
Na czym polega: Dziesięciodniowa prognoza pogody, którą dziś liczy się na około dziesięciu tysiącach procesorów przez godzinę–dwie, w Aurorze zajmuje kilka minut na jednym GPU — przy równej lub lepszej trafności (przykład tajfunu Doksuri z 2023 roku).
Jak stosować: Tam, gdzie prognozy potrzebne są często i tanio — energetyka odnawialna, logistyka, rolnictwo, ubezpieczenia — rachunek opłacalności właśnie się zmienił.
Na co uważać: Sam pretrening pozostaje drogi; zysk pojawia się przy wielu uruchomieniach gotowego modelu.
9.Fine-tuning modelu fundacyjnego zależy od problemu
Na czym polega: Nie ma jednego przepisu „tyle GPU i tyle dni”. Do dotrenowania Aurory potrzeba 10–30 lat danych historycznych (potencjalnie terabajty) i od jednego–dwóch GPU przy wąskim zadaniu do kilkunastu na wiele dni przy dotrenowaniu globalnym.
Jak stosować: Zawęź problem — im mniejszy zakres, tym mniejsze zapotrzebowanie na dane i moc, a trenowanie prowadź do zbieżności, z ciągłym testowaniem i oceną.
Na co uważać: Elastyczność modelu fundacyjnego oznacza też, że koszt szacujesz indywidualnie dla każdego zastosowania — plan budżetu rób po analizie danych.
10.Wracajdo pomysłów, które wcześniej odrzuciłeś
Na czym polega: Aplikacja Lily, nagrywająca spotkania lokalnie, upadła kilka lat temu, bo dokładność i opóźnienia nie były znośne. Dziź to samo zadanie działa na słabszym sprzęcie niż ówczesny komputer autora — i sam rozważa wskrzeszenie projektu.
Jak stosować: Skoro lokalne modele wyraźnie dojrzewają z roku na rok, ponownie oceń pomysły odłożone „na półkę” — bariera technologiczna mogła już zniknąć.
Na co uważać: Przez te lata zmienił się też rynek i konkurencja — zweryfikuj nie tylko technikę, ale i aktualność samego produktu.
Redakcyjne tłumaczenie
Dlaczego pojechałem na Microsoft Build
Ta branża pędzi w zawrotnym tempie. Wielu z was ogląda ten kanał, bo — jak się wydaje — jestem na przedzie zmian: stale testuję najnowsze modele i frameworki agentowe. Ale szczerze: sam też mocno odstaję. Nadążyć za tym wszystkim jest po prostu trudno. Dlatego tak bardzo cieszyłem się na rozmowy z ludźmi, którzy naprawdę siedzą w temacie — żeby sprawdzić, czego nie widzę.
Jeśli śledzicie kanał od dłuższego czasu, wiecie, że eksperymentuję z modelami lokalnymi. Moja aplikacja do liczenia kalorii od początku działała na modelach uruchamianych na urządzeniu. Śledzę też Gemmę 4, właśnie wydaną przez Google jako model otwarty. Sporo rzeczy w AI dzieje się teraz na Windowsie, a ja znam to środowisko słabo — buduję głównie na Apple. Chciałem więc porozmawiać z ludźmi, którzy tworzą na Windowsie: z zespołami Microsoftu i ze startupów, żeby zrozumieć, co mi umyka jako użytkownikowi Maka.
Do San Francisco trafiliśmy dzięki Logitech — jednemu z niewielu partnerów sprzętowych obecnych na konferencji. Dziękujemy za przelot, bilety i dostęp, bez których nic z tego nie moglibyśmy pokazać. Na kanale mało o tym mówiłem, ale przeczuwam, że prędzej czy później sam zacznę zajmować się sprzętem — więc rozmowy o sprzęcie i AI były dla mnie podwójnie ciekawe.
Konferencja od kuchni
Próbowaliśmy wejść na keynote Satyi Nadelli — już o dziewiątej rano sala była pełna po brzegi, a nawet pomieszczenie przepełnień miało się po dziurki w nosie. Obejrzeliśmy transmisję na laptopie, a potem ruszyliśmy na spacer między sesjami. Dopiero później zrozumieliśmy skalę problemu: to pierwsza edycja Build w San Francisco i lokal wyraźnie mniejszy niż zwykle. Większość prelekcji praktycznie nie miała miejsc siedzących, ludzie stali. Wyciągnęliśmy wnioski i na wszystko, co dla nas ważne, zaczęliśmy przychodzić dużo wcześniej. Na jedną prelekcję przyszedłem wyjątkowo wcześnie — o budowaniu aplikacji z lokalnymi modelami AI.
Najważniejszy wniosek z niej? Wrażenie, że w lokalnej AI Windows jest wyraźnie przed Apple — a mówię to jako osoba budująca głównie na ekosystemie Apple. Apple ma swoje modele fundacyjne i z nich korzystałem, ale w większości moich zastosowań to jeszcze nie ten poziom.
Pierwszy „moment magii”: upscaling wideo na urządzeniu
Zespół prowadzący tamtą prelekcję miał też stoisko, więc tam zajrzeliśmy. Okazało się, że jeden z jego członków, Greg, zna mój kanał i rozpoznał mnie — na konferencji tej skali to naprawdę miła rzecz. Greg i jego ludzie poświęcili nam mnóstwo czasu i pokazali kilka demonstracji, które kompletnie odwróciły moje wyobrażenie o modelach lokalnych.
Pierwsza z nich — i szczerze mówiąc pierwszy prawdziwy „moment magii” całego wyjazdu — to upscaling wideo w czasie rzeczywistym. Dla kogoś, kto buduje produkty, to duża sprawa: żeby zrobić to dobrze, zwykle potrzebny jest serwer i płatny, drogi model doskalający. A tu wszystko działa za darmo, na urządzeniu. I to, o ile się nie mylę, na zwykłym laptopie z Windowsem.
Jak to działa? W transmisjach wideo obraz kompresuje się już po stronie nadawcy — liczy się pasmo, opóźnienie, płynność. Materiał „zrzucany” jest więc do bardzo małej rozdzielczości i w takiej postaci leci przez sieć do odbiorcy. Dopiero tam następuje powrót do oryginalnej rozdzielczości, a na to nakłada się super rozdzielczość, która potrafi wyjść nawet poza pierwotną jakość. Skoro film pozostaje skompresowany przez cały czas transmisji, oszczędzasz na transferze — a to oznacza mniej zacięć, niższe koszty CDN i mniejsze wydatki całej organizacji. Efekt: użytkownicy dostają lepszy obraz, a ty płacisz mniej za zasoby.
Patrząc na demo, zakładałem, że liczy się to gdzieś na serwerze. Nie — wszystko lokalnie. Zero opłat za tokeny, nic.
Transkrypcja na sprzęcie sprzed lat — i powrót aplikacji Lily
Kolejna demonstracja, która zmieniła moje spojrzenie, to transkrypcja mowy na żywo. Jeśli śledzicie kanał, być może pamiętacie Lily — aplikację nagrywającą spotkania i przetwarzającą je lokalnie, na urządzeniu. Upadła, bo dokładność i opóźnienia po prostu nie dochodziły wtedy do poziomu; każde jej uruchomienie wyraźnie spowalniało cały komputer. Tym większe było moje zdziwienie, gdy zobaczyłem transkrypcję live na starszym laptopie z Windowsem, bez większej ilości pamięci, przy procesorze ledwo ruszającym ze spoczynku. Demonstracje lokalnej AI zwykle biegną na potężnych maszynach — a to działało na sprzęcie sprzed kilku lat. Ktoś, kto próbował dokładnie tego samego i odpuścił, może być naprawdę pod wrażeniem. I szczerze: zacząłem się zastanawiać, czy nie wrócić do budowania Lily.
Podwórko dewelopera: kilka linii kodu i własne modele
Poza płynnością działania zaskoczyło mnie, jak łatwo Microsoft uczynił to wszystko dostępnym dla twórców aplikacji. Nie jestem przez Microsoft sponsorowany i nie mam żadnego interesu, żeby to mówić, ale moim zdaniem wygrywają tu z Apple. Pokazali, że upscaling obrazu dodasz w kilku linijkach kodu. Najbardziej imponujące było jednak to, jak szeroko otworzyli drzwi dla modeli osób trzecich.
Jeśli z jakiegoś powodu nie chcesz korzystać z ich modelu — przynieś własny. Pobierasz dowolny model z Hugging Face i integrujesz ze stosem WinML, o ile spełnia jeden z obsługiwanych standardów. Potem komunikujesz się bezpośrednio z modelem, a całą resztą — całą maszynerią uczenia maszynowego — zajmuje się warstwa Microsoftu. Możesz też wdrożyć model własnej roboty. Do tego katalog Foundry i kilka innych katalogów, prowadzonych przez Microsoft lub podmioty zewnętrzne.
(Informacja dodatkowa: WinML, czyli Windows Machine Learning, to systemowa warstwa Windowsa do uruchamiania modeli AI bezpośrednio na urządzeniu.)
Zapytałem, czy przy wyborze modelu brany jest pod uwagę sprzęt, na którym ma działać. Odpowiedź: wywołujesz pojedyncze API super rozdzielczości, a w trakcie działania system sam wykrywa najlepszy dostępny układ i pobiera odpowiedni wariant modelu.
Stosowanie modeli: małe sieci łączone w serie
Ponieważ wszystko to jest lekkie i wydajne, upowszechnia się technika zwana model stacking — uruchamianie wielu modeli lokalnych naraz albo łączenie ich w łańcuchy. Dotąd robiło się to w chmurze albo u płatnego dostawcy, a teraz jest zupełnie bezpłatne. Dla kogoś, kto buduje produkt z własnej kieszeni, to ogromna różnica.
Zespół mówi wprost: modele lokalne będą z każdym rokiem lepsze i wydajniejsze, a te API to dopiero początek. Sam niewielki rozmiar modeli nie jest przypadkiem — to właśnie on pozwala układać je w stosy. Weźmy wideo: super rozdzielczość to tylko jedna z możliwości. Zespół badaczy (w tym Luming) pracuje nad stabilizacją obrazu z kamery; gdy model trafi do produkcji, będzie można najpierw ustabilizować nagranie, a dopiero potem je przeskalować — dwa modele jeden za drugim. I o to chodzi: są na tyle małe, że mieszczą się na urządzeniu jednocześnie.
Podobnie na audio: zestawić można tłumaczenie na żywo z napisami na żywo. Interfejs rozpoznawania mowy zamienia głos na tekst w trybie seryjnym (gotowy plik dźwiękowy) albo strumieniowym — na przykład podczas rozmowy czy spotkania. Wszystko to dobrze działa na NPU, ale i na zwykłym procesorze, więc zasięg jest duży, a dostępność — już wkrótce.
(Informacja dodatkowa: NPU to dedykowany układ do obliczeń neuronowych, montowany w nowszych komputerach z Windows.)
W efekcie da się poskładać stabilizację, super rozdzielczość, rozwijane modele kompresji (pomagające opóźnieniom i płynności klatek), a do tego tłumaczenie i napisy. Na końcu tej drogi masz film automatycznie przetłumaczony, opatrzony napisami i o lepszej — odbieranej jako lepszej — jakości obrazu. Tak Microsoft reklamuje swoje Windows AI APIs: „inteligencja bez liczników”.
Na marginesie jednej z rozmów padło coś, co utkwiło mi w głowie: ludzie deklarują, że zależy im na prywatności, ale przy decyzjach wygrywa koszt. Na początku myślałem: „po co sobie zawracać głowę, biorę najlepsze dostępne narzędzie”. Nie — naprawdę warto ścigać w dół łączny koszt działania. I mam przeczucie, że lokalna AI będzie właśnie z tego powodu następnym wielkim etapem.
Microsoft Research: Trellis i pierwsze spotkanie z Aurorą
Kolejny przystanek: Microsoft Research — grupa, która bierze najświeższe badania firmy i pokazuje, jak przełożyć je na realne zastosowania. Zobaczyliśmy sporo ciekawostek, między innymi model Trellis: podajesz mu jedno zdjęcie, a on generuje z niego kompletny model trójwymiarowy. Najbardziej intrygująca była jednak Aurora.
Najlepiej wytłumaczę to tak: znasz modele fundacyjne pokroju Sonneta czy Opusa, które generują tekst. Aurora to również model fundacyjny — tyle że prognozuje systemy Ziemi: pogodę, zanieczyszczenie powietrza. To było moje pierwsze spotkanie z modelem fundacyjnym tego rodzaju i sama rozmowa była fascynująca. Niestety, ze względu na charakter pracy tych ludzi nie mogliśmy jej nagrywać. Zespół był jednak bardzo uprzejmy: obiecał rozesłać kilka maili i sprawdzić, czy wrócimy następnego dnia na porządne, rejestrowane spotkanie o Aurorze. I dopowiedzmy od razu — udało się. Ta rozmowa czeka dalej w tym materiale i była chyba najciekawszą ze wszystkich na wyjeździe.
Logitech: dokumentacja SDK pisana dla agentów
Po przerwie ruszyliśmy do Logitech — firmy, dzięki której w ogóle mogliśmy tu być. Poprosiłem o rozmowę z kimś pracującym na styku oprogramowania i sprzętu i takiego człowieka faktycznie znaleźli: Paul z zespołu SDK, czyli warstwy, na której inni mogą budować na sprzęcie Logitech.
Paul powiedział coś, co moim zdaniem jest naprawdę ważne: rynek odbiorców SDK sprzętowych zmienia się radykalnie przez AI coding. Ale najpierw zabawa, bo przy tym stoisku spędziliśmy zdecydowanie za dużo czasu. Korzystam z linii MX — myszy MX Master 4 i klawiatury mechanicznej MX — a jest jeszcze konsola kreatywna, której przyciski mapuje się pod własne akcja. Paul podpiął swoją pod terminal: jeden przycisk przełącza model w Claude Code, drugi porządkuje okna terminala. Podobno to zasługa kogoś innego, ale gdy przyszliśmy, mysz była tak skonfigurowana, że każdy przycisk odpalał bardzo konkretny teledysk — kolejny użytkownik czekała miła niespodzianka. Są też gotowe mapowania pod aplikacje typu VS Code, przygotowane we współpracy z Microsoftem. Spędziliśmy tam z godzinę i było po prostu świetnie.
Wróćmy jednak do sedna. Kiedyś SDK Logitech było skierowane do dużych deweloperów zewnętrznych — na konferencjach typu tej firma przekonywała giganty pokroju Adobe, żeby budowali na ich sprzęcie. A ponieważ pojawiły się narzędzia w rodzaju Claude Code, obraz się odwrócił: dziś w praktyce każdy jest deweloperem. Więc Logitech chce sięgać po ludzi takich jak ja i wy. Przykład: opublikowali stronę LLMs.txt — dokument, który wręczasz wprost agentowi kodującemu, a ten uczy się z niej, jak korzystać z ich SDK. Innymi słowy: piszą dokumentację z założeniem, że ludzie oddadzą ją swoim agentom. I według Paula każda firma sprzętowa posiadająca SDK zaczyna tak myśleć. Dla budowniczych to naprawdę ekscytujące, bo sprzęt właśnie ma stać się dużo bardziej dostępny. Jeśli korzystasz ze sprzętu Logitech — a wiem, że wielu z was korzysta — gorąco polecam wskazać Claude Code na ich SDK i kazać mu przygotować własne dostosowanie. Spora część tego, co pokazaliśmy, powstała w jakieś pięć minut, jednym poleceniem.
(Informacja dodatkowa: LLMs.txt to rosnący standard dokumentu-instrukcji dla modeli językowych i agentów — odpowiednik robots.txt, tyle że skierowany do AI.)
Paul dodał jeszcze tło własnych decyzji: pracuje tam od mniej niż roku i na początku zadanie brzmiało „jak przyciągnąć więcej deweloperów”. Wtedy stawiali na Node.js, bo wydawał się przystępniejszy. W ostatnich miesiącach nastąpił zwrot: mniej focusu na języki programowania, więcej na optymalizację pod konsumpcję przez AI.
Aurora w akcji: demonstracje przed rozmową
Do nagrywalnej rozmowy doszło dzięki uprzejmości Heather i kilkunastu e-mailom — mogliśmy usiąść z Kenjim Toketą, dyrektorem ds. inkubacji badawczych, i porozmawiać o Aurorze. Zanim oddam mu głos, opiszę demonstracje, które nam zaprezentował. Wersja skrócona: Aurora prognozuje pogodę równie trafnie jak używane dziś systemy — z tą różnicą, że tamte wymagają ogromnej mocy obliczeniowej, a Aurora nie.
Pierwsza: prognoza temperatury z Aurory zestawiona ze standardową prognozą liczoną na superkomputerach. Ta druga zajęłaby godzinę lub dwie na tysiącach procesorów; Aurora liczy ją w kilka minut. Druga: tajfun Doksuri z 2023 roku, który niestety narobił mnóstwo szkód. Niebieska linia pokazywała faktyczną trasę burzy — i to za nią podążała Aurora, podczas gdy oficjalna prognoza służb meteorologicznych nieco odbiegała od rzeczywistości. Aurora wyliczyła też uderzenie na ląd na dzień czwarty; oficjalne modele mówiły o jednym dniu później. Co więcej, oficjalna prognoza skłaniała się ku Tajwanowi zamiast ku północnym Filipinom. To skrajny przykład, ale zespół przetestował model na wielu huraganach i Aurora radzi sobie naprawdę dobrze.
Trzecia: sieć dotrenowana pod zanieczyszczenie powietrza — tlenki azotu. Elektrownie spalinowe wypluwają ich mnóstwo; na mapie widać dobowy rytm dwutlenku azotu, czyli w praktyce emisje ze spalania paliw kopalnych. Czwarta: burza piaskowa na Bliskim Wschodzie. To ciekawe wyzwanie, bo nie wystarczy przewidzieć wiatru — trzeba wyliczyć, jak piasek zostaje podniesiony, przeniesiony kilka mil i w końcu zrzucony. Za tym stoi skomplikowana fizyka, której Aurora jakoś się nauczyła, i robi prognozę wielodniową, choć zwykle da się patrzeć dobę naprzód.
Na koniec architektura. Na wejściu zasilasz model danymi początkowymi; te są tłumaczone na przestrzeń ukrytą — wszystkie zmienne lądują w jednej, wspólnej reprezentacji. Potem pracuje blok transformera Swin, który w gruncie rzeczy jest modelem wizji komputerowej, bo dane to szereg przekrojów, coś jak serie obrazów. Model przesuwa stan o sześć godzin do przodu, a dekoder mapuje wynik z powrotem na kulę ziemską. I tak w kółko. Ciekawe, że w samym sercu prognozowania pogody leżą algorytmy widzenia maszynowego.
Rozmowa z Kenjim Toketą o Aurorze
Im więcej Kenji pokazywał, tym mocniej utwierdzałem się w czymś, co widziałem przez cały tydzień: zadania, które jeszcze niedawno wymagały ogromnej infrastruktury AI, schodzą do ułamka mocy obliczeniowej. Oto rozmowa.
Chris: Większość moich odbiorców to ludzie budujący produkty. Jakie zastosowania Aurory — być może po dotrenowaniu — wchodzą w grę dla takiej osoby albo dla firmy? Macie przykłady, o których możesz opowiadać?
Kenji Toketa: Są branże, w których pogoda ma kapitalne znaczenie. Energetyka na przykład: farmy wiatrowe, fotowoltaika — musisz rozumieć, czy będzie pochmurno, czy wietrznie. Współpracujemy ze szwajcarską firmą BKW, która eksploruje Aurorę w różnych scenariuszach. Jest też niezwykły projekt ze startupem stąd, z San Francisco, o nazwie Terradot — zajmuje się usuwaniem dwutlenku węgla z atmosfery. Okazuje się, że skały wchłaniają CO2, tylko bardzo powoli; jeśli się je rozdrobni, proces można mocno przyspieszyć. Terradot rozszerzył Aurorę o własny koder i dekoder tak, żeby modelować wchłanianie CO2 na konkretnym polu w Brazylii i liczyć to w przód, prognozowo. Robimy to razem z naszym laboratorium AI for Good — to fascynujące rozszerzenie daleko poza prognozowanie pogody. Ciekawa jest też branża finansowa, choćby rozumienie ryzyka związanego ze zmianami klimatu; handel detaliczny, który chce wiedzieć, co przyniesie kolejny sezon; produkcja żywności i oczywiście rolnictwo. Nasi partnerzy z Uniwersytetu Cambridge badają z kolei, jak Aurorą wspierać rolników w Afryce — tam, gdzie prognozy pogody nigdy nie były dostępne tak jak w Stanach.
Chris: Ile mocy obliczeniowej pochłania dzisiejsza prognoza pogody? Jakoś przyjąłem, że to rzecz powszechna — wpisujesz w wyszukiwarkę i już. A ty mówiłeś, że w rzeczywistości jest bardzo wymagająca.
Kenji: Dzisiejsze prognozy liczy się na wielkich superkomputerach. Bierze się prawa fizyki opisujące atmosferę i modeluje się je krok po kroku — co kilka sekund albo minut. To bardzo kosztowne obliczeniowo. Prognoza dziesięciodniowa, taka jak w telewizji, może zająć godzinę czy dwie na dziesięciu tysiącach procesorów. Służby meteorologiczne w każdym kraju liczą to codziennie i to one dostarczają prognozy, z których korzystamy wszyscy. W przypadku Aurory dużo inwestuje się w pretrening, ale samo uruchomienie prognozy to kilka minut na jednym GPU — przy równej lub lepszej trafności i tysiące razy szybciej. To zaczyna zmieniać myślenie o wykorzystaniu danych pogodowych w różnych zastosowaniach.
Chris: Bardzo mnie zaskoczyło, że Aurora jest open source. Jej wytrenowanie na pewno dużo kosztowało — dlaczego udostępniać taki model wszystkim?
Kenji: Gdy zaczynamy od badań i chcemy je opublikować, kluczowe jest, żeby po recenzjach inni mogli zobaczyć, co zrobiliśmy, i odtworzyć to. Powtarzalność badań buduje zaufanie — i pozwala całej dziedzinie iść naprzód razem.
Chris: A gdyby ktoś chciał Aurorę dotrenować pod siebie? Pytam maksymalnie konkretnie: ile mocy i ile danych potrzeba, żeby zacząć fine-tuning i realnie z tego korzystać?
Kenji: To zależy od zadania. Zasadniczo im więcej danych, tym lepiej — mówimy o dziesięciu, dwudziestu, trzydziestu latach danych historycznych, co może dawać wiele terabajtów. Sam fine-tuning wykonuje się na GPU: przy wąskim, konkretnym zadaniu wystarczą jeden–dwa; przy dotrenowaniu globalnym, na dużych zbiorach — kilkanaście układów na kilka dni albo parę tygodni. Decyduje rozmiar problemu. Do tego trzeba trenować do zbieżności wyników — ciągle trenować, testować, oceniać.
Chris: Czyli bardzo indywidualnie — nie ma jednej odpowiedzi w stylu „tyle GPU i tyle dni”.
Kenji: Po części wynika to z elastyczności samego modelu fundacyjnego.
Chris: Jest coś, o czym chcesz powiedzieć ludziom, a o czym się za mało mówi? Może apel: potrzebujecie więcej świetnych inżynierów nad konkretnymi problemami?
Kenji: Potrzebujemy ludzi, którzy będą pracować razem, jako społeczność. Aurora jest open source — każdy może wnieść swój wkład. W ten sposób podnosimy poziom badań nad AI, zwłaszcza w naukach o przyrodzie, pogodzie i klimacie, które dotyczą nas wszystkich. Chcemy mieć pewność, że stosowanie AI realnie służy społeczeństwu.
Chris: Dziękuję za poświęcony czas.
Kenji: Dziękuję, że wróciliście. Robimy to, co lubimy — wstajemy rano, bo to ekscytująca nauka, ale też dlatego, że widzimy zastosowania.
Chris: Ta wczorajsza rozmowa była chyba najciekawszą częścią wyjazdu. Odblokowała mi cały obszar: dlaczego nikt o tym nie mówi?
Kenji: Aurora to tylko jeden z naszych projektów w AI for Science. Modelujemy też białka czy strukturę atomową cząsteczek…
Chris: Dzięki wielkie.
Kenji: Mamy mnóstwo innych rzeczy w toku.
Zamiast podsumowania: wyjście z bańki
Sporo spraw nie trafiło do tego materiału — wiele świetnych rozmów nie dało się nagrać. Ta konferencja wiele dla mnie znaczyła i chciałem dać jej porządne opracowanie, bo dawno nie czułem się tak poza swoim żywiołem — i zapewne było to widać. Nauczyłem się mnóstwo o modelach lokalnych i o sieciach dalekich od LLM-ów, o których zwykle rozmawiamy — Aurora to najlepszy przykład. Miałem pogłębione rozmowy z ludźmi z AMD i Nvidii i mogłem zapytać o rzeczy w stylu: jak w ogóle wygląda optymalizacja pod sprzęt?
A czego żałuję, że nie udało się przekazać? Że każda osoba, z którą rozmawiałem, była tak zaangażowana i tak bystra. Jeśli oglądaliście mojego vloga z San Francisco, wiecie, że dużo mówiłem o wychodzeniu z bańki. Ale i to była wciąż bańka: cały mój świat to samodzielni deweloperzy, twórcy aplikacji, ostatnio założyciele startupów. Tym razem rozmawiałem z badaczami i ludźmi budującymi sprzęt w gigantycznych firmach — działającymi w skali i z dostępem do rzeczy, których ja i większość startupów nigdy nie dotkniemy. Otworzyło mi to oczy: muszę rozmawiać z większą liczbą takich ludzi. Zawsze zakładałem, że wielkie korporacje działają zbyt powoli — i szczerze mówiąc, w dużej mierze nadal tak jest. Ale spotkani ludzie pracowali niemal w godzinach startupowych i poruszali się w zawrotnym tempie, po prostu dlatego, że ich to pali i że branża pędzi naprzód.
To było zupełnie inne doświadczenie niż każda konferencja, na której wcześniej byłem. Zaplanowałem kolejne wyjazdy — i po wsparciu, jakim obdarzyliście ostatniego vloga z San Francisco (serdecznie dziękuję), chcę nadal zabierać was ze sobą. Spodziewajcie się więcej materiałów z terenu. Wielkie podziękowania dla Logitech, bez których nic z tego by nie było, dla wszystkich w Microsofcie, którzy usiedli z nami przed kamerą, i dla Briana, który znowu wszystko nagrał. Do zobaczenia w następnym materiale.