
O czym jest ten film
- Google opublikowało 51-stronicowy artykuł o kodowaniu z AI — według Cole’a Medina najczytelniejsze zebranie praktyk i terminologii, na które zbiega cała branża; kilka osób przesłało mu link z uwagą, że tekst mógłby wyjść spod jego pióra.
- SDLC (software development life cycle) to pełna droga od pomysłu do produkcji: wymagania, projektowanie, implementacja, testy, wdrożenie, utrzymanie — znacznie więcej niż samo pisanie kodu.
- W cyklu napędzanym przez AI implementacja skróciła się z 1–3 tygodni do minut lub godzin; nowe wąskie gardło to jakość specyfikacji i walidacja — dlatego asystenci dziesięciokrotnie przyspieszają inżyniera, ale nie cały biznes.
- Kodowanie z AI to spektrum, nie przełącznik: vibe coding → ustrukturyzowane kodowanie z AI → inżynieria agentowa (specyfikacje, automatyczne ewaluacje, bramki CI, samodzielna iteracja agenta).
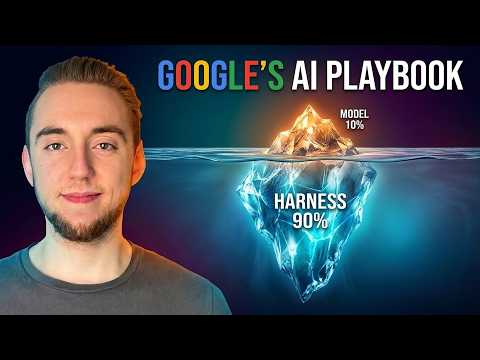
- Agent to model plus harness; model odpowiada za ledwie ok. 10% systemu — reszta to instrukcje, narzędzia, kontekst, guardraile, hooki, przepływy pracy i obserwowalność. Anthropic pisał, że harness znaczy tyle co model; Google idzie dalej.
- Model „fabryki”: inżynier projektuje system, a agent produkuje kod i dokumentację w pętli planuj → buduj → weryfikuj; całe kodowanie jest delegowane, różni się tylko dojrzałość systemu.
- Planowanie i kodowanie warto rozdzielić na dwie sesje: plan trafia do agenta kodującego jako czysty artefakt, co chroni przed przeładowaniem kontekstu i skrzywieniami; człowiek przegląda wynik (np. pull request) przed wdrożeniem.
- Kontekst statyczny (chude reguły ładowane zawsze) kontra dynamiczny (skille i konwencje ładowane na żądanie); skille pozwalają jednemu agentowi-generaliście wcielać się w specjalistów — branża odchodzi od złożonych systemów wieloagentowych.
- Dwa tryby pracy inżyniera: dyrygent (plik po pliku) i orkiestrator (całe repozytoria, równolegli agenci). Cole częściowo się nie zgadza — przy dojrzałym harnessie można zostać orkiestratorem na stałe.
- Ekonomia tokenów: vibe coding to niskie nakłady początkowe, ale ogromne koszty operacyjne; inżynieria agentowa — odwrotnie, docelowo 3–10 razy tańsza i niezawodniejsza.
10 najważniejszych takeaways — z kontekstem zastosowania
1.Wąskim gardłem przestało być pisanie kodu — teraz to specyfikacja i walidacja
Na czym polega: AI skraca implementację z tygodni do godzin, ale zbieranie wymagań na początku oraz testy i walidacja na końcu wciąż wymagają człowieka. Stąd paradoks znanych statystyk: asystent dziesięciokrotnie przyspiesza inżyniera, ale nie dziesięciokrotnie cały biznes.
Jak stosować: analizując proces developmentu, mierz czas osobno dla specyfikacji, implementacji i walidacji — oszczędności szukaj tam, gdzie etap nadal jest ręczny. Warto też śledzić narzędzia wspierające pisanie wymagań i walidację; zdaniem Cole’a to pole na kolejne wielkie platformy.
Na co uważać: szybko wygenerowany kod przy słabej specyfikacji oznacza szybsze produkowanie niewłaściwych rozwiązań — tempo nie zastąpi jakości wymagań.
2.Traktuj kodowanie z AI jako spektrum i dobieraj tryb do zadania
Na czym polega: między vibe codingiem a inżynierią agentową rozciąga się całe continuum (w środku: ustrukturyzowane kodowanie z AI). Nie zawsze potrzebujesz najwyższego poziomu — czasem swobodny prompt wystarczy.
Jak stosować: dla prototypów, MVP i jednorazowych skryptów świadomie zejdź do vibe codingu; wszystko, co ma trafić na produkcję i być utrzymywane, prowadź z pełnym systemem: specyfikacjami, ewaluacjami i bramkami CI.
Na co uważać: vibe coding ma wysoki profil ryzyka — nadaje się do kodu jednorazowego, nie do systemów, na których opiera się firma. Poziom dobiera się do zadania, a nie „awansuje” raz na zawsze.
3.Model to 10 procent — inwestuj w harness
Na czym polega: na wynik pracy agenta składa się model (ok. 10%) oraz harness: instrukcje, reguły, narzędzia, serwery MCP, guardraile, hooki, przepływy pracy, testy i obserwowalność (ok. 90%). Modelu nie kontrolujesz — harness projektujesz sam, pod własną bazę kodu.
Jak stosować: zanim zmienisz model na nowszy, zrób przegląd otoczki: jakie reguły, skille, testy i bramki masz. Badania na Terminal Bench 2.0 pokazują, że sama warstwa reguł i workflowów potrafi wynieść model spoza pierwszej trzydziestki do czołowej piątki.
Na co uważać: harness to inwestycja początkowa i zasób żyjący w kontroli wersji — traktowany „przy okazji” rozjedzie się z kodem i straci na wartości.
4.Rozdzielaj sesję planowania od sesji kodowania
Na czym polega: agent planujący nagromadza mnóstwo kontekstu i nabiera skrzywień; kontynuowanie w tej samej sesji pogarsza jakość pracy. Plan powinien trafiać do agenta kodującego jako czysty artefakt.
Jak stosować: każde zadanie — naprawa błędu, nowa funkcja — prowadź w dwóch krokach: najpierw sesja planująca na bazie specyfikacji, potem świeża sesja kodująca z guardrailami, sandboxem, testami i ewaluacjami.
Na co uważać: „wszystko w jednej rozmowie” wydaje się wygodne, ale sprzyja przeładowaniu okna kontekstu i gorszym decyzjom pod koniec zadania.
5.Człowiek zostaje w pętli: przeglądaj wyniki przed wdrożeniem
Na czym polega: bez własnej kontroli efektów nawet autonomiczny system dryfuje w stronę vibe codingu. Minimalna forma to pull request przechodzący przez człowieka.
Jak stosować: ustal stały punkt kontroli — np. obowiązkowy przegląd PR-a przed zaliczeniem testów i wdrożeniem; przy wyższej stawce dołącz drugiego agenta-recenzenta i model-sędziego (LLM-as-a-judge).
Na co uważać: przegląd nie może być formalnością; zdecyduj, które decyzje (architektura, bezpieczeństwo, dane) zawsze wymagają człowieka — i trzymaj się tej listy.
6.Po każdym incydencie doszlifuj system, nie tylko kod
Na czym polega: „mindset ewolucji systemu”: gdy agent utknął albo musiał ingerować, robisz retrospekcję — co poprawić w regułach, przepływach i guardrailach, żeby problem nie wracał. System dojrzewa jak baza kodu.
Jak stosować: kończ trudne zadania pytaniem do agenta: „co w naszej warstwie AI można ulepszyć, by ten błąd był mniej prawdopodobny?”. Wnioski zapisuj w harnessu pod kontrolą wersji.
Na co uważać: bez tego nawyku każdy problem wraca w kółko — niezawodność bierze się z powtarzalnych ulepszeń, nie z pojedynczych łatek.
7.Statyczny kontekst trzymaj chudy, wiedzę specjalistyczną ładowuj dynamicznie
Na czym polega: kontekst statyczny (reguły, prompt systemowy) jest w każdej sesji — pewny, ale zajmuje okno i kosztuje. Dynamiczny (skille, konwencje, wyszukiwanie w kodzie) agent pobiera na żądanie — taniej i skalowalnie, ale może o niego nie sięgnąć.
Jak stosować: w promptach systemowych zostaw tylko podstawowe reguły i zabezpieczenia; całą wiedzę specjalistyczną pakuj w skille i dokumenty podciągane przy konkretnych zadaniach lub fragmentach repozytorium.
Na co uważać: agent może pominąć dynamiczny kontekst w chwili, kiedy powinien go użyć — warto obserwować, czy skille faktycznie się ładują (modele radzą sobie z tym coraz lepiej, ale kontrola nie zawadzi).
8.Jeden generalista zamiast armii specjalistów
Na czym polega: skille pozwalają lekkiemu agentowi-generaliście wcielać się w specjalistów dzięki stopniowemu odsłanianiu wiedzy. Branża odchodzi od skomplikowanych systemów wieloagentowych pełnych subagentów-ekspertów.
Jak stosować: zanim dobudujesz kolejnego subagenta, sprawdź, czy nie wystarczy skill (workflow) dla istniejącego agenta — na przykład rola planisty albo recenzenta kodu.
Na co uważać: prostota nie zwalnia z guardraili — niektóre deterministyczne akcje lepiej trzymać w hookach niż w promptach, a krytyczne integracje wymagają osobno kontrolowanych procesów.
9.Dyrygent i orkiestrator — ale z roli dyrygenta można „wyrósć”
Na czym polega: Google proponuje przełączanie się między trybem pracy plik po pliku (dyrygent) a trybem zadań obejmujących całe repozytoria (orkiestrator). Cole jest sceptyczny: przy wystarczająco niezawodnym harnessie można pozostać orkiestratorem na stałe.
Jak stosować: model dwóch trybów traktuj jako pomoc dydaktyczną — najbardziej przydatną dla zespołów klasycznych inżynierów stawiających pierwsze kroki z agentami. Głębszy debugging czy wstępna eksploracja naturalnie wymagają zejścia na poziom pojedynczych plików.
Na co uważać: nie przeskakuj do pełnej orkiestracji, dopóki reguły i przepływy nie są sprawdzone — ale też nie przywiązuj się do mikromanagementu, gdy system już dojrzał.
10.Licz nakłady i koszty operacyjne: harness zwraca się na tokenach
Na czym polega: vibe coding ma niskie nakłady początkowe (CAPEX), ale wysokie koszty operacyjne (OPEX) — miliony tokenów spalane na iterowanie po kodzie niskiej jakości. Inżynieria agentowa zaczyna się drogo (własny czas albo mały wysunięty zespół), ale potem skaluje się znakomicie.
Jak stosować: oszacuj miesięczne zużycie tokenów w trybie „bez systemu” i porównaj z kosztem zbudowania harnessu — próg opłacalności przychodzi szybko, a docelowo system jest 3–10 razy tańszy i niezawodniejszy.
Na co uważać: to inwestycja pod powtarzalny proces — przy projektach jednorazowych się nie zwróci; wtedy świadomie zostań na niższym poziomie spektrum.
Redakcyjne tłumaczenie
Pięćdziesiąt jeden stron, które czyta się jak kompendium branży
Google opublikowało nowy, obszerny materiał o kodowaniu z pomocą AI — i jest naprawdę dobry. Dokument liczy 51 stron i robi wrażenie syntezy niemal wszystkiego, o czym Cole Medin mówi na swoim kanale. W zeszłym tygodniu kilka osób przesłało mu link z komentarzem, że tekst wygląda tak, jakby mógł wyjść spod jego pióra. To najczytelniejsze spięcie tego, na co branża właśnie zbiega: wspólnych najlepszych praktyk i wspólnego słownika dla pracy z asystentami kodowania.
Całość z pewnością warto przeczytać (link znajdziemy w opisie filmu), ale 51 stron to spora lektura — dlatego właśnie powstaje ten materiał: żeby wszystko rozebrać szybko i konkretnie. Autor dodaje przy tym, że nawet osoby czujące się pewnie w inżynierii agentowej mają powód, by wrócić do podstaw. Z prawdą starej szkoły: rozumiesz coś naprawdę dopiero wtedy, gdy potrafisz to komuś dobrze wytłumaczyć. Wyrobione z czasem instynkty warto zamieniać w jasny model mentalny i precyzyjną terminologię. Kolejność wątków Cole lekko przestawia względem oryginału — jego zdaniem tak będzie czytelniej — i oprowadza nas po własnym diagramie.
SDLC, czyli od pomysłu do produkcji
Pierwsze pytanie, na które trzeba odpowiedzieć: czym w ogóle jest SDLC? Osoby bez technicznego tła mogą nie znać tego skrótu, a tymczasem w branży krąży już termin „AI-driven SDLC”. Skrót pochodzi od software development life cycle — cyklu życia oprogramowania. Mówiąc prosto: to droga od pomysłu aż do produkcji. Zaczyna się od zbierania wymagań, kończy na przeglądzie, wdrożeniu i utrzymaniu. To znacznie więcej niż samo pisanie kodu, które stanowi wyłącznie środek tej drogi.
W klasycznym cyklu kilka dni pochłaniają spotkania z interesariuszami i przygotowanie przez produkt menedżera dokumentu wymagań (PRD) wraz z całą wstępną dokumentacją. Potem parę dni projektowania, a najwięcej czasu — tygodnie — zajmuje implementacja: inżynier pisze właściwy kod. Na końcu zwykle tydzień testów, przeglądu, wdrożenia i utrzymania. Oczywiście to uogólnienie — w każdej firmie wygląda to trochę inaczej.
Wąskie gardło przesunęło się na początek i koniec
W wersji napędzanej przez AI początek i koniec cyklu prawie się nie skróciły. Nowym wąskim gardłem jest jakość specyfikacji. To bardzo trafna diagnoza: sporo pracy nadal musi wykonać człowiek — zebranie wymagań na starcie i walidacja na mecie. Przyspieszył środek. Implementacja, która zajmowała od tygodnia do trzech, trwa teraz minuty albo godziny — to kilkadziesiąt razy szybciej, zwłaszcza że agenci potrafią samodzielnie iterować, opierając się na własnych testach i ewaluacjach.
Stąd bierze się znany paradoks statystyk: asystent dziesięciokrotnie przyspiesza pracę inżyniera, ale nie dziesięciokrotnie wydajność całej firmy — bo pozostałe etapy inżynierii oprogramowania dławią proces. Cole przewiduje, że część kolejnych firm wartych ponad miliard dolarów powstanie na platformach przyspieszających zbieranie wymagań i walidację: środek mamy w dużej mierze rozwiązany. Mimo to warto wyeliminować implementację z grona wąskich gardeł — to wciąż daje sporą oszczędność czasu. I właśnie na tym skupia się artykuł Google: jak przyspieszyć całą resztę cyklu.
Spektrum, nie przełącznik
Pierwsza duża teza: kodowanie z AI to spektrum, nie przełącznik. Większość ludzi myśli o tym zero-jedynkowo — albo „vibe codujesz”, albo uprawiasz inżynierię agentową. Tymczasem to continuum, a jego pozycja zależy od dojrzałości naszego systemu (o systemie i harnessie za chwilę).
Na jednym końcu vibe coding: wysyłasz prompt bez większego planowania, a weryfikacja sprowadza się do stwierdzenia „wygląda, że działa” — dotykasz aplikacji, kiwasz głową i przechodzisz do kolejnej iteracji. W środku spektrum ustrukturyzowane kodowanie z pomocą AI: dokładniejsze prompty, więcej sprawdzania wyników na własne oko. Na drugim końcu inżynieria agentowa: kompletny, zaprojektowany zestaw zasobów i przepływów pracy dla asystenta — specyfikacje, automatyczne ewaluacje, bramki CI. Agent dostaje narzędzia do samodzielnej iteracji i wykrywania błędów, zanim ingerować musi człowiek. I właśnie tu tkwi prawdziwa moc.
Czy zawsze potrzebujemy inżynierii agentowej? Nie. Czasem vibe coding wystarczy — na proof of concept czy MVP. Cole przyznaje, że dawniej zbywał vibe coding, dziś widzi dla niego autentyczne zastosowania. Sedno jest takie, że spektrum nie opisuje twojej osobistej „ewolucji” — to kwestia dobrania narzędzia do zadania. Inżynieria agentowa zwykle jest właściwym celem, bo to ona daje naprawdę niezawodny kod.
Tabela trzech poziomów
Google dopełnia ten obraz tabelą, która robi sprawy konkretnymi: dla każdego poziomu spektrum pokazuje kilka wymiarów. Pierwszy to intensywność specyfikacji, czyli jak szczegółowo komunikujemy z góry, czego chcemy. Przy vibe codingu — swobodne prompty w naturalnym języku, opis na wysokim poziomie. W środku spektrum — więcej detali, ale wciąż bez formalnego procesu tworzenia specyfikacji czy dokumentacji architektonicznej. W inżynierii agentowej — powtarzalny proces i specyfikacje zaprojektowane równie starannie jak sam kod.
Drugi wymiar: weryfikacja. Przy vibe codingu — „czy to w ogóle działa”, bez żadnego głębszego zanurzenia. W ustrukturyzowanym kodowaniu — więcej ręcznych testów i oględzin kodu. W inżynierii agentowej — pełny proces: agent sam iteruje z testami i bramkami CI/CD, oceniają modele-sędziowie, a code review prowadzi się osobno, z udziałem człowieka i drugiego agenta. Wreszcie profil ryzyka: przy vibe codingu wysoki — do zaakceptowania wyłącznie dla kodu jednorazowego. Jeśli zależy ci na maksymalnej pewności, potrzebujesz systematycznej weryfikacji na każdym etapie, i to właśnie zapewnia inżynieria agentowa.
Harness: model to 10 procent, reszta to twoja robota
Skoro inżynieria agentowa to zwykle właściwy kierunek — jak się do niej zabrać? Co właściwie odróżnia ją od vibe codingu? Odpowiedź spina się w jednym pojęciu: harness. To zbiór kontekstu, reguł, narzędzi i przepływów pracy, które wnosisz do asystenta kodowania — warstwa, którą kontrolujesz. Kluczowa teza Google: duży model językowy, na którym działa asystent, to zaledwie 10 procent systemu. Tylko tyle znaczy. Cała reszta — instrukcje, narzędzia, kontekst, guardraile, orkiestracja, obserwowalność — to owe 90 procent.
I to jest naprawdę dobra wiadomość, bo model jest tym, czego nie kontrolujemy, natomiast harness tworzymy sami — pod konkretne bazy kodu, architektury i stacki technologiczne. Branża wyraźnie zbiega w tym punkcie. Kilka tygodni wcześniej Anthropic opublikował artykuł o najlepszych praktykach pracy z Claude Code (Cole omawiał go na kanale) z nagłówkiem brzmiącym: harness znaczy tyle, co model. Google — i sam Cole — idzie o krok dalej: nie tylko znaczy tyle, co model, lecz znaczy więcej, bo model to tylko te 10 procent. Wniosek: skup się na reszcie.
Zestaw elementów otoczki u obu graczy jest niemal identyczny. W Claude Code to globalne reguły, hooki (deterministyczne akcje uruchamiane w konkretnych momentach cyklu pracy), skille — czyli spakowane workflowy — sposoby przeszukiwania kodu, serwery MCP i subagenty. Cole nazywa te elementy „prymitywami”: przydają się w pracy z każdym asystentem kodowania. W artykule Google pada zwięzła definicja: agent to model plus harness. Towarzyszący jej diagram rozkłada całość na warstwy — to stąd pochodzi liczba 10 procent. Model w środku wciąż się liczy, bo jest mózgiem i rozumowaniem systemu, ale otaczająca go warstwa to ogromna sprawa: instrukcje, serwery MCP, guardraile i hooki. Wyżej leży infrastruktura testowa — ewaluacje, dzięki którym agent może sam iterować. A na samej górze warstwa dla człowieka i produkcji: obserwowalność, tracing, skalowanie — bez tego trudno wynieść to, co produkuje asystent, do rzeczywistej eksploatacji.
(Informacja dodatkowa: „harness” dosłownie znaczy „uprząż” — w branży AI tym słowem opisuje się całą zaprojektowaną otoczkę wokół modelu: reguły, narzędzia, procesy i zabezpieczenia, w które model zostaje „zaprzęgnięty”.)
Fragment sponsorowany: Better DB
(Informacja dodatkowa: poniższy akapit to płatna sekcja sponsorska, zachowana z oryginalnego materiału.)
Sponsorem odcinka jest Better DB — open source’owa platforma samostrojącego się cache’owania i obserwowalności dla agentów AI, kompatybilna z Valkey i Redis. Temat odcinka — cykl rozwoju oprogramowania z AI — nie zostawia wiele miejsca na narzędzia do niezawodności i monitoringu, czyli na końcowy etap cyklu, a Better DB jest dobrym przykładem rozwiązania budowanego z myślą o AI: monitorowanie bazy danych na produkcji, sugestie zmian i ulepszeń oparte na żywych danych produkcyjnych oraz semantyczny cache pomagający skalować.
Najciekawsza funkcja to właśnie semantyczny cache. Pytanie o stolicę Francji nie znajduje się jeszcze w pamięci, więc trafiamy na pudło i odpowiedź musi policzyć model. Ale kolejne, podobne pytanie trafia już w cache — nie musi brzmieć identycznie, bo dopasowanie odbywa się przez podobieństwo znaczeniowe, jak w klasycznym RAG. Odpowiedź przychodzi dużo szybciej. Dzięki serwerowi MCP można podpiąć asystenta kodowania bezpośrednio do Better DB: pytać o kondycję systemu, dostawać propozycje ulepszeń i od razu je wprowadzać — łatwo jest więc poprawiać system z pomocą AI. Do tego dashboard pokazujący wydajność agenta i cache’u na realnych danych użytkowników. Platforma jest open source, a start nie kosztuje nic — link w opisie filmu. Autor poleca ją do skalowania wdrożonych agentów i panowania nad kosztami na produkcji.
Fabryka: planuj, buduj, weryfikuj
W inżynierii harnessu pojawia się metafora fabryki. Zamiast pisać kod czy dokument wymagań ręcznie, inżynier odpowiada za zaprojektowanie systemu — tworzy harness — a to agent produkuje kod i dokumentację. To większa inwestycja z góry niż vibe coding, bo trzeba przygotować specyfikacje i guardraile. W zamian dostajemy powtarzalny proces: planujemy razem z agentem, agent buduje, a na końcu czekają bramki jakości — testy i ewaluacje — z pętlą, w której agent samodzielnie poprawia wynik, aż dojrzeje moment, w którym człowiek przegląda i wdraża.
W tym modelu całe kodowanie delegujemy na asystenta — także w inżynierii agentowej. Spektrum nie opisuje więc tego, ile piszemy ręcznie, a ile ufamy maszynie, lecz tego, jak dojrzały system zbudowaliśmy. (Google bywa tu zresztą powtarzalne: „fabryka” to w praktyce ten sam zestaw elementów, który omówiono już przy harnessie — kontekst i reguły, testy i bramki jakości, workflowy, guardraile i hooki.)
Ważny punkt tego obrazu: miejsce samego developera. Na początku definiujemy specyfikacje, kontekst i wymagania, a następnie używamy ich w pracy agenta planującego. W inżynierii agentowej każde zadanie — naprawa błędu czy nowa funkcja — zaczyna się od osobnego planu. Zaprojektowane przez nas guardraile i środowisko piaskownicy (sandbox) służą natomiast agentowi kodującemu.
Dwie sesje: plan jako artefakt
I tu kluczowa rada: rozdziel te role na dwie osobne sesje. Agent planujący nagromadza mnóstwo kontekstu — a przepełnione okno szkodzi jakości (tzw. context rot, degradacja rozumowania przy nadmiarze informacji) — do tego nabiera skrzywień. Dlatego plan przekazujemy dalej jako czysty artefakt: trafia do świeżej sesji agenta kodującego, a dopiero tam odbywa się testowanie, weryfikacja i iteracja. W tym miejscu do pętli wchodzi też człowiek. Bez własnego przeglądu wyników dryfujemy prosto w stronę vibe codingu — nawet przy mocno autonomicznym systemie. Minimalna forma kontroli to pull request na końcu: w inżynierii agentowej to na ogół człowiek powinien go przejrzeć, zanim uzna testy za zaliczone i ruszy dalej w stronę produkcji. W całym tym przepływie działają guardraile: limity tokenów, polityki bezpieczeństwa — wszystko zaprojektowane z góry.
Ewoluuj system jak kod
Najciekawsza cecha całej konstrukcji: można ją ulepszać w czasie, dokładnie tak, jak ewoluuje baza kodu. Cole nazywa to „mindsetem ewolucji systemu”. Za każdym razem, gdy asystent się potknie — iteruje dłużej, niż byśmy chcieli, albo musimy interweniować przed wdrożeniem — nie poprawiamy tylko błędu i nie idziemy dalej. Zamiast tego robimy z agentem małą retrospekcję: gdzie można doszlifować workflowy, reguły, dowolny element warstwy AI, żeby ten problem był mniej prawdopodobny w przyszłości? Każde kolejne przejście przez proces czyni go niezawodniejszym. Harness jest wart poświęcenia czasu — to przecież owe 90 procent.
Trafiają się na to twarde dane. Terminal Bench 2.0, jeden z największych benchmarków — ten, którego wyniki pokazuje się przy każdej premierze modelu — bywał podstawą badań, w których model spoza pierwszej trzydziestki wspiął się do czołowej piątki wyłącznie dzięki warstwie reguł i przepływów pracy. LangChain zyskał w ten sposób 13,7 punkta — a to mniej więcej różnica między Sonnetem a Opusem. Z odpowiednim systemem Sonnet potrafi pracować jak Opus.
(Informacja dodatkowa: Sonnet i Opus to modele rodziny Claude od Anthropic; Opus jest flagową, droższą i wydajniejszą wersją.)
Kontekst statyczny i dynamiczny
Jeśli harness jest najważniejszą częścią inżynierii agentowej, to najważniejszą umiejętnością jest projektowanie jego poszczególnych komponentów — reguł, workflowów i guardrailów. Google robi tu rozróżnienie, które bardzo podoba się Cole’owi: kontekst statyczny kontra dynamiczny. Sedno sprawy to zarządzanie kontekstem, bo kontekst to najcenniejszy zasób pracy z asystentami — ze względu na koszty i na unikanie degradacji. Nie chcemy wypełniać okna modelu po brzegi: modele duszą się od nadmiaru informacji dokładnie tak samo jak ludzie.
Kontekst statyczny to reguły, podstawowe guardraile i prompt systemowy — ładowane do sesji za każdym razem, gwarantowanie. To daje pewność: agent nie musi tej wiedzy szukać. Cena: okno kontekstu jest zajęte od samego początku. Dlatego statyczny zestaw powinien być chudy — jakieś minimum reguł i zabezpieczeń na start, reszta niech czeka na zewnątrz. Wszystko inne trafia do kontekstu dynamicznego: agent sam sięga po te informacje, gdy ich potrzebuje. Może mieć na przykład skill do planowania, ładowany w chwili rozpoczęcia pracy nad planem, albo konwencje opisujące konkretny fragment repozytorium, podciągane dopiero wtedy, gdy na tym fragmencie pracuje. To wydajne i skalowalne — nic nie jest upychane do okna z góry. Ryzyko: agent może nie sięgnąć po ten kontekst wtedy, gdy powinien — nie załaduje skilla albo nie wykona wyszukiwania, choć byłoby to optymalne. Na szczęście modele coraz lepiej radzą sobie z dynamicznym kontekstem i coraz trafniej sięgają po niego we właściwych momentach.
Jeden agent, wiele ról
Stąd rosnąca waga skillów. Google ujmuje to tak: zamiast wpychać całą wiedzę specjalistyczną do promptu systemowego, skille pozwalają agentowi pozostać lekkim generalistą, który na żądanie wciela się w rolę specjalisty — dzięki stopniowemu odsłanianiu wiedzy w miarę potrzeby. Wniosek jest głębszy, niż się wydaje: naprawdę wystarczy nam jeden agent do wszystkiego, a specjalizujemy go skillami, czyli workflowami. Kiedyś zbyt wiele osób budowało skomplikowane systemy wieloagentowe — całe armie wyspecjalizowanych subagentów. Branża od tego odchodzi: jeden generalista, dzięki dynamicznemu kontekstowi, może w danej sesji stać się recenzentem kodu albo planistą. Trzymaj się prostoty — do większości inżynierii agentowej naprawdę wystarczy jeden agent.
Dyrygent czy orkiestrator
Przedostatni wątek: twoja własna rola. Google proponuje model dwóch trybów, między którymi porusza się inżynier pracujący z asystentem. Dyrygent — tak wyglądała praca z AI u samych początków generatywnej ery: autouzupełnianie w edytorze, sterowanie każdym ruchem, działanie w pojedynczych plikach. Orkiestrator — to, na czym skupia się dziś niemal wszyscy: agent dostaje duże zadania obejmujące całe bazy kodu, czasem nawet kilka, a my przeglądamy rezultaty zamiast zmian w pojedynczych plikach; agenci pracują równolegle, a my skalujemy swoją wydajność.
I to jest jedyny fragment artykułu, z którym Cole nie do końca się zgadza. Google twierdzi, że chcemy przełączać się między oboma trybami — że wciąż jest czas i miejsce na mikromanagement asystenta na poziomie pojedynczego pliku. Cole jest sceptyczny: gdy zbudujesz wystarczająco niezawodny harness i zaufasz swoim regułom i przepływom, możesz pozostać orkiestratorem na stałe. Przyznaje jednak, że argumenty mają sens: przy głębszym debugowaniu czy wstępnej eksploracji i tak schodzi się na poziom plików, bo właśnie wtedy warto być blisko agenta i prowadzić go ręcznie. Jego zdaniem to raczej kwestia „wyrastania” z roli dyrygenta niż wiecznego przeskakiwania między rolami — choć jako model mentalny dwutrybowość jest użyteczna, zwłaszcza dla organizacji pełnej tradycyjnych inżynierów stawiających pierwsze kroki w inżynierii agentowej. Przynajmniej dopóki system nie dojrzeje.
Ekonomia tokenów: tanie wejście kontra tani bieg
Na koniec rama kosztowa — zdaniem Cole’a znakomicie poprowadzona. Vibe codingu nie zawsze trzeba unikać, ale nadmierne oparcie się na nim drogo kosztuje. Na początku — gdy wprowadzasz asystenty u siebie lub w firmie — vibe coding wychodzi taniej: niskie nakłady początkowe, bo nikt nie musi poświęcać czasu na zaprojektowanie harnessu. Problem w tym, że koszty operacyjne są potem bardzo wysokie: bez systemu, który pilnowałby twoich workflowów i konwencji, spalasz miliony tokenów na iterowanie po kodzie niskiej jakości.
Inżynieria agentowa zaczyna się od wysokich nakładów: musisz poświęcić czas z góry — w większej organizacji zwykle tworzy się mały, wysunięty zespół inżynierów, który buduje harness, a potem skaluje go na całą firmę. Ale potem system skaluje się znakomicie: wyniki asystentów są coraz lepsze, a fundament budujesz raz i stopniowo doszlifowujesz. Próg opłacalności przychodzi bardzo szybko — warto po prostu zainwestować i zbudować system od razu. Docelowo inżynieria agentowa jest trzy do dziesięciu razy niezawodniejsza i tańsza niż vibe coding, bo nie spalasz milionów tokenów.
Puenta
To tyle — kompletny, wysokopoziomowy obraz nowego cyklu rozwoju oprogramowania napędzanego przez AI. Warto budować harness i w niego inwestować: to zaprojektowany zasób, który żyje w kontroli wersji dokładnie tak samo jak kod. Cole zaprasza do komentowania, które wątki rozwinąć w kolejnych materiałach — to jego chleb powszedni — i przypomina o łapce w górę oraz subskrypcji.