
O czym jest ten film
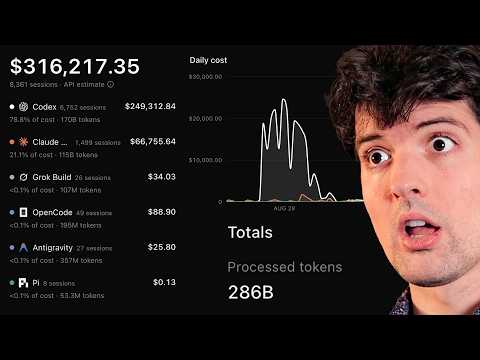
- Sam Altman obiecywał, że AI stanie się 10-krotnie tańsze rok do roku — a Theo notuje wzrost własnych wydatków z ok. 800–1000 dolarów rocznie (2025) do nawet 1000 dolarów dziennie (2026).
- Krótka odpowiedź filmu: AI faktycznie staniało, tylko mierzymy koszt złymi miarami.
- Trzy właściwe wymiary kosztu: cena tokena, liczba tokenów zużywanych na zadanie oraz koszt uzyskania danego poziomu inteligencji.
- Topowe modele realnie zdrożały 5–10 razy (GPT-5 → GPT-6 Astra), ale dolna półka oferuje dziś zdolności, które rok temu były premium — GLM 5.3 Flash kosztuje ok. 1/20–1/30 ceny GPT-5.
- Niska cena tokena bywa iluzją: modele marnotrawne (Gemini 3.8/3.5 Flash, Sonnet 5) potrafią wychodzić drożej w przeliczeniu na zadanie niż drożsi konkurenci.
- Przy zadanym poziomie inteligencji ceny spadają lawinowo: DeepSeek V4 Flash daje wynik GPT-5 za ok. 1/20 ceny; O1 preview za 15 dolarów → Grok-3 mini za 16 centów w kilka miesięcy.
- Każdy kolejny „poziom inteligencji” tanieje szybciej niż poprzedni — tempo spadków przyspiesza.
- Czwarty wymiar: zmienił się sam sposób użycia — od autouzupełniania funkcji po godzinne, samodzielne zadania od końca do końca.
- Paradoks Jevonsa: rachunki rosną, bo używamy modeli znacznie intensywniej, a nie dlatego, że drożeją — wydatek idzie w parze z produktywnością.
- Theo rozlicza się ze swojej prognozy sprzed dwóch lat („AI przestanie się poprawiać”) — w miejscu stanęły wtedy benchmarki, nie modele.
10 najważniejszych takeaways — z kontekstem zastosowania
1.Cena tokena to najgorsza możliwa miara kosztu AI
Na czym polega: Porównania typu „model X kosztuje 50 dolarów za milion tokenów” mówią bardzo mało. Realny rachunek składa się z trzech elementów: ceny tokena, liczby tokenów pochłanianej przez zadanie i kosztu osiągnięcia danego poziomu inteligencji. Model tani per token potrafi wychodzić drożni w przeliczeniu na gotową pracę.
Jak stosować: Zanim wybierzesz model, zmierz koszt na własnym, powtarzalnym zadaniu — pełny przebieg z wejściem, wyjściem i ewentualnymi powtórzeniami — zamiast porównywać cenniki.
Na co uważać: Na pozorny fatalny wzrost cen u topowych modeli — to tylko jeden z trzech składników równania, i to najmniej mówiący.
2.Góra półki podrożała, ale dół zlotniał i zdolniał
Na czym polega: Najdroższe nowości zdrożały 5–10 razy, ale równolegle pojawiły się bardzo zdolne modele za ułamek dawnej ceny. GLM 5.3 Flash przy ok. 1/20–1/30 ceny GPT-5 wygrywa z nim w dużej części realnej pracy agentskiej.
Jak stosować: Rozdziel zadania krytyczne (tam, gdzie najwyższa jakość realnie poprawia wynik biznesowy) od całej reszty — resztę przenieś na dolną półkę, która dziś daje ubiegłoroczne możliwości premium.
Na co uważać: Na wnioskowanie o całym rynku z cennika jednego, najdroższego modelu — oba końce półki zmieniły się jednocześnie.
3.Efektywność tokenowa potrafi zjeść całą przewagę cenową
Na czym polega: Gemini 3.8 Flash wyglądał na ponad 10 razy tańszy od Astry i Fable, ale przez marnotrawstwo tokenów różnica w koszcie zadania topniała do mniej niż 3x. Sonnet 5 wychodził w praktyce drożej niż Astra.
Jak stosować: Przy wyborze modelu pytaj o zużycie tokenów na typowe zadanie, nie tylko o stawkę. Jeśli vendor nie podaje takich danych — zmierz je sam na próbie kilkudziesięciu zadań.
Na co uważać: Na promocyjne cenniki: niska stawka przy wysokim zużyciu może dać wyższy rachunek niż droższy, ale oszczędny model.
4.Różne typy zadań wymagają różnych optymalizacji
Na czym polega: Przy masowym przetwarzaniu wejścia (np. skategoryzowanie 800 tys. tokenów) dominuje koszt tokenów wejściowych — szukaj najtańszego wejścia. Przy pracy agentskiej nad kodem kluczowe stają się cache’owanie, niezawodność i oszczędność tokenowa.
Jak stosować: Sklasyfikuj swoje obciążenia według profilu (duże wejście vs. wiele kroków agentskich) i optymalizuj każdą klasę osobno, innym modelem.
Na co uważać: Na jeden „firmowy standard” dla wszystkich zadań — optymalny model do masowej analizy tekstu i do agentów programistycznych to zwykle dwie różne pozycje z cennika.
5.Odwróć perspektywę: ile dziś kosztuje zeszłoroczny poziom inteligencji
Na czym polega: Zamiast pytać „ile inteligencji dostanę za dolara”, ustal poziom zdolności (np. wynik GPT-5) i sprawdź, ile kosztuje on dziś. Odpowiedź: DeepSeek V4 Flash daje porównywalny wynik za ok. 1/20 ceny — nawet z naliczeniem gorszej efektywności.
Jak stosować: Przy planowaniu budżetu odrysuj wykres „koszt danego poziomu zdolności w czasie” dla swoich rzeczywistych zadań — pokaże realny trend, zamiast astronomicznych liczb z cennika topowych nowości.
Na co uważać: Porównania utrudnia wymiana benchmarków — stare testy się nasycają, więc „podobny wynik” trzeba weryfikować na wspólnych, aktualnych punktach pomiaru.
6.Poziomy inteligencji tanieją coraz szybciej
Na czym polega: Dane Artificial Analysis pokazują lawinę: poziom poniżej 10 punktów — z 60 centów do 2 centów na zadanie; O1 preview za 15 dolarów pobity przez Grok-3 mini za 16 centów w kilka miesięcy; kolejne progi osiągają stabilny wynik za pojedyncze centy.
Jak stosować: Nie przepłacaj za bycie na samym szczycie przez cały czas — dziś drogi poziom zdolności potrafi potanieć o rząd wielkości w ciągu kwartału. Tam, gdzie to możliwe, czekaj na dojrzenie poziomu.
Na co uważać: Na chwilę tuż po premierze nowego progu — wtedy ceny wyglądają najgorzej, a spadek przychodzi szybko; skale na wykresach bywają logarytmiczne, co zniekształca wrażenie.
7.Rosnące rachunki to głównie wzrost zużycia, nie cen
Na czym polega: To wariant paradoksu Jevonsa: modele staniały i poprawiły się na tyle, że opłaca się ich używać tam, gdzie wcześniej nie było to sensowne — więc łączny wydatek rośnie. Więcej tokenów na zapytanie to oznaka sukcesu, nie porażki.
Jak stosować: Budżetuj i monitoruj zużycie (liczbę zadań, długość przebiegów), a nie tylko stawki. Analizuj rachunek razem z miernikami wykonanej pracy — wtedy wzrost wydatków często okazuje się spadkiem kosztu jednostkowego.
Na co uważać: Na argument „AI zdrożało, bo patrz na mój rachunek” — bez rozdzielenia ceny od wolumenu prowadzi do błędnych decyzji zakupowych.
8.Mały model z dobrymi narzędziami wyprzedaje ubiegłoroczne czołówki
Na czym polega: GLM 5.3 Flash ma mniej „wbudowanej wiedzy” niż GPT-5, ale lepsze widzenie, lepszą obsługę narzędzi i znacznie lepszą pracę agentską rozciągniętą na godziny. Z dostępem do wyszukiwarki w zadaniach wiedzy wygrywa różnicą rzędu wielkości.
Jak stosować: Inwestuj w jakość otoczki — wyszukiwanie, MCP, dobrze opisane narzędzia — zamiast automatycznie sięgać po największy model. Mały silnik z porządnym przybornikiem często zrobi więcej za grosze.
Na co uważać: Na testy „wiedzy bez narzędzi”, które faworyzują duże modele i nie mówią nic o realnej pracy z toolcallingiem.
9.Nasycenie benchmarków udaje plateau — zmień metrykę, zanim ogłosisz koniec postępu
Na czym polega: Theo nagrał kiedyś materiał „AI nie będzie się już poprawiać”, bo GPT-4, 4-turbo i 4o nie poprawiały wyników w ówczesnych testach. W rzeczywistości testy były przesycone — potrzebne były nowe, a postęp ruszył z kwitowanej energią.
Jak stosować: Gdy dwa pokolenia technologii dają identyczne wyniki, sprawdź najpierw, czy miara nie jest „zapchana” — poszukaj trudniejszych testów albo zbuduj własny, odpowiadający twoim zadaniom.
Na co uważać: Na własne przedwczesne wnioski o stagnacji — w tym przypadku kosztowały autora sporo wiarygodności.
10.Obietnica „10x taniej” się spełniła — ale dla starych zadań
Na czym polega: Zadania, do których używano AI rok temu, rzeczywiście staniały o rząd wielkości. Rachunki rosną, bo te same i większe budżety idą na nowe, trudniejsze, dłuższe zadania, które dawniej w ogóle nie wchodziły w grę.
Jak stosować: Rozdziel w raportowaniu koszt „utrzymania dotychczasowych procesów” (ten spada) od kosztu „nowych możliwości” (ten rośnie, bo rośnie zakres pracy) — to ucina spory o „drożejące AI” w zarodku.
Na co uważać: Na porównywanie rachunku sprzed roku z dzisiejszym jeden do jeden — to zestawienie dwóch różnych zakresów pracy, nie dwóch cen tej samej usługi.
Redakcyjne tłumaczenie
„Inteligencja zbyt tania, by ją mierzyć” — a rachunek rośnie
„Inteligencja zbyt tania, by ją mierzyć” — to ma być kolejny etap rozwoju AI. Tak przynajmniej zapowiadał Sam Altman w lipcu 2025 roku. Tyle że przez cały 2025 rok moje osobiste korzystanie z AI zamknęło się kwotą rzędu 800–1000 dolarów, a w 2026 roku bywają dni, w których spokojnie przepalam 1000 dolarów na tokeny. Zamiast tanieć, inteligencja jakby drożeje — zwłaszcza teraz, gdy modele pokroju Fable czy Astry kosztują więcej za token i przy tym generują ich więcej, więc koszty, które widzą realne firmy, mocno puchną. Rachunek za AI idzie w górę i w górę, bez śladu zatrzymania.
Co się więc stało? Dlaczego nie zbliżamy się do obiecanej granicy? Dlaczego inteligencja nie tanieje? Mam wrażenie, że rok temu płaciłem za zapytanie kilka centów, a dziś potrafię zapłacić dziesiątki, jeśli nie setki dolarów. Gdzie popełniono błąd? Dlaczego firmy tyle liczą? Miało być taniej.
Skąd wziął się ten materiał
Odcinek zainspirował Primagen. (Informacja dodatkowa: ThePrimeagen — znany programista i streamer.) Wyszukał on realną obietnicę Altmana: AI ma stawać się 10 razy tańsze rok do roku. I przyznał, że jest zdezorientowany — liczył na te dziesięciokrotność, tymczasem wyszła Astra i jest znacznie droższa. Co poszło nie tak? Mam na to sporo przemyśleń.
Wersja skrócona: jednak staniało. Tylko mierzymy to źle. Wersja rozszerzona, czyli reszta filmu — zaraz po przerwie na sponsora.
Przerwa na sponsora: Railway (skrót)
Zaznaczam od razu, że jestem stronniczy: Railway kocham od lat i prawie zostałem ich czwartym pracownikiem — zamiast tego założyłem własny startup, a wkrótce potem kanał na YouTube. Znam tę drużynę i wiem, co budują. Railway od lat stawia najprostszą w obsłudze chmurę dla programistów: od bazy danych po CDN, da się na niej postawić kompletną aplikację od zera. Prawdziwa magia zaczęła się jednak wtedy, gdy pojawiły się narzędzia dla agentów — CLI i MCP. Dzięki temu moje agenty same wdrażają i utrzymują pełne aplikacje, a ja nie muszę o tym myśleć. Moja chmura Lakebed stoi w całości na Railway: agenty przygotowały mi środowisko produkcyjne, staging, a nawet osobne środowisko do testów jednego konkretnego pull requesta. Gdy mam pytania o infrastrukturę albo pomysł na ulepszenie, mówię o tym Claude’owi albo Codexowi — podłącza się przez MCP, stawia środowisko, sprawdza zmianę, wdraża przez merge do głównej gałęzi i jeszcze samo weryfikuje efekt. Na dashboard nie zaglądałem od tygodni, bo po prostu nie muszę. Cały nasz wewnętrzny pipeline wideo — łącznie z materiałem, który właśnie oglądacie — kosztuje mnie na Railway mniej niż 50 dolarów miesięcznie przy sporym wolumenie.
Trzy wymiary, w których trzeba liczyć koszt
Dobrze, wracamy. Żeby wyjaśnić, dlaczego AI naprawdę tanieje, trzeba wejść w liczby i przypomnieć sobie, jak modele właściwie działają. Zacznijmy od kosztu tokena — i od razu uczciwie zaznaczmy, że dane pochodzą z serwisu Artificial Analysis.
Gdy patrzy się na ceny modeli w czasie, pierwsze wrażenie jest przerażające. GPT-5 w wariancie medium kosztowało 10 dolarów za milion tokenów wyjściowych. GPT-6 Astra — 50 dolarów za milion na wyjściu i 10 na wejściu. To wzrost o 5–10 razy na tokenach wejściowych i wyjściowych. Koszmar. Dokładna odwrotność obietnicy: miało być dziesięciokrotnie taniej, jest dziesięciokrotnie drożej.
Ale sprawa ma warstwy, bo cena tokena to jedna z najgorszych miar kosztu. Brać trzeba pod uwagę trzy rzeczy. Pierwsza: tak, koszt tokena — wrócę do niego za chwilę. Pozostałe dwie są ważniejsze. Druga: ile tokenów pochłania wykonanie danego kawałka pracy. Trzecia: jakie typy pracy model w ogóle potrafi wykonać — czyli, mówiąc obrazowo, ile inteligencji dostajemy za dolara. Mamy więc koszt tokena, tokeny na zadanie i koszt danego poziomu inteligencji: ile trzeba wydać, żeby dostać rozwiązanie problemu na określonym poziomie zdolności.
Góra podrożała, ale dół zlotniał i zdolniał
Tak, cennik na samym szczycie wzrósł. Ale bądźmy szczerzy: mamy też opcje tanie i przy tym świetne. Weźmy GLM 5.3 Flash — jedną z moich ulubionych premier w ogóle. Standardowo 15 centów za milion tokenów na wejściu i 50 centów na wyjściu, a do tego w wielu miejscach wyprzedaż z połową ceny, czyli realnie 7 i 25 centów. To mniej więcej jedna dwudziesta–trzydziesta część ceny GPT-5. I za tę ułamkową stawkę GLM 5.3 Flash w sporej części realnej pracy agentskiej zostawia GPT-5 daleko w tyle.
Czyli patrząc wyłącznie na czołówkę — tak, token podrożał. Ale wystarczy spojrzeć gdzie indziej, by zobaczyć modele bardzo zdolne i jednocześnie dużo tańsze niż kiedykolwiek. Szczyt półki oszalał, ale i podłoga zrobiła krok naprzód. Obie strony odnotowały realny postęp.
Tani token to jeszcze nie tanie zadanie
Cena tokena to jednak tylko drobny kawałek wzoru. Posłużę się zabawnym przykładem: Gemini 3.8 Flash.
Na wykresie cen wygląda jak okazja: 3,75 dolara za milion tokenów wyjściowych — mniej niż połowa ceny GPT-5 i mniej niż jedna dziesiąta Astry i Fable. Ale przestawmy się na koszt zadania w indeksie inteligencji i nagle różnica mocno topnieje, bo 3.8 Flash zużywa do pracy mnóstwo tokenów. Model komicznie tani w przeliczeniu na token, ale marnotrawstwo zbliża go do konkurencji: różnica spada z ponad 10-krotnej do niecałych 3-krotnej. Jeszcze gorzej wypadał 3.5 Flash — tak łakomy na tokeny, że doszedł ponad połowy kosztu 5.6 Soul, choć ten jest w cenniku nieporównanie droższy. I perełka: Sonnet 5 wychodził w praktyce drożej niż Astra, bo po prostu pali tokeny jak smok.
To są dwa pierwsze wymiary: cena tokena i liczba tokenów potrzebnych do rozwiązania zadania. Przy czym różne zadania rządzą się tu inaczej. Jeśli polega ono na wchłonięciu 800 tysięcy tokenów i jakiejś kategoryzacji, koszt wyjścia ma znaczenie drugorzędne — dominuje wejście, które płacisz zawsze, niezależnie od wszystkiego. W takim wypadku słuszną strategią jest model najtańszy pod kątem tokenów wejściowych. Przy agentskiej pracy deweloperskiej nagle ogromnie rośnie waga cache’owania, niezawodności i oszczędności tokenowej.
Koszt kontra inteligencja — i odwrócenie perspektywy
Ale nawet to nie jest właściwy sposób patrzenia, bo dotąd rozmawialiśmy tylko o kosztie. Chcemy patrzeć na koszt względem inteligencji. Na takim wykresie widać, ile kosztował przebieg i jak model wypadł w testach. Artificial Analysis dorysowują linię granicy Pareto — najlepszy model przy danym poziomie wydatków. GPT-6 Astra zajmuje sporo punktów na tej granicy; Fable wisi daleko po drogiej stronie. Zauważ jednak: przy zadanym poziomie inteligencji koszt potrafi spaść ogromnie. Jeśli wystarcza ci wynik 45–46, zapłacisz 82 centy za zadanie. Chcesz wejść na półkę pięćdziesiątek? Trzy dolary 26 centów. Kilka punktów więcej — trzy razy wyższy rachunek.
Nawet to jednak nie jest najlepsze ujęcie. Chcę je odwrócić. Zamiast pytać, ile inteligencji dostaniesz za dolara, ustalmy poziom inteligencji i sprawdźmy, ile kosztuje on w czasie. Weźmy możliwości GPT-5: ile dziś trzeba wydać na ten sam poziom, wybierając tańsze opcje?
Namierzenie tego zajęło mi więcej czasu, niż się spodziewałem, bo w ciągu ostatniego roku wymieniliśmy niemal wszystkie benchmarki — stare po prostu się nasyciły. W końcu trafiłem na to, że DeepSeek V4 Flash wypada mniej więcej na poziomie GPT-5 w trybie high: kilka wspólnych testów dawało zbliżone wyniki. Co ciekawe, V4 Flash wyprzedza go w paru miejscach, jak Humanity’s Last Exam czy benchmark tempa halucynacji, ale w ogólnym indeksie inteligencji wyszło mniej więcej na remis. I teraz kluczowa rzecz: DeepSeek V4 Flash jest 21 razy tańszy od GPT-5 na wejściu i 55 razy na wyjściu. Nie znalazłem dobrych liczb dla różnic w efektywności, ale nawet gdyby DeepSeek był trzykrotnie mniej wydajny, bilans i tak wychodzi około 20-krotnie na plus. Jeśli celem było potaniecie inteligencji o jeden rząd wielkości, ten cel wykonaliśmy z ogromnym zapasem. Jesteśmy na 20x.
Lawinowe spadki w danych Artificial Analysis
(Informacja dodatkowa: Artificial Analysis to niezależny serwis śledzący ceny, szybkość i wyniki modeli językowych; „indeks inteligencji” to ich syntetyczna miara zdolności modelu.)
Na szczęście proces ten śledzą już nasi znajomi z Artificial Analysis. Weźmy poziom poniżej 10 punktów inteligencji: kiedyś zadanie na tym poziomie kosztowało 60 centów, a między listopadem 2022 a lipcem 2024 cena zeszła do 2 centów.
Potem wyniki między 10 a 20 punktami. Na początku to było drogie: O1 preview potrafił kosztować do 15 dolarów za zadanie, bo model był po prostu bardzo kosztowny. Ale spadek przyszedł błyskawicznie. We wrześniu 2024 ten poziom kosztował 15 dolarów, a już w lutym 2025 Grok-3 mini osiągał podobne — a właściwie lepsze — wyniki za ułamek tej ceny. To, co kiedyś było dolarami, dziś liczy się w groszach: 16 centów za wynik wyższy niż O1 preview, który zdobył ledwo 11 punktów, podczas gdy Grok-3 mini miał cztery więcej. W ciągu kilku miesięcy cena spadła więc o niemal 99 procent.
Ktoś na czacie rzucił trafną uwagę: „Spadki za każdym razem przychodzą szybciej”. I właśnie tu robi się naprawdę ciekawie. O1 preview i O1 były droższe, niż powinny, ale zaraz po nich przyszła lawina. Potem poziom dwudziestu punktów: O3 pierwszy przekroczył 20, a między kwietniem a sierpniem tego samego roku GPT-5 mini zdobył — no dobrze, praktycznie identyczny — wynik 20–21. Zamiast 1,55 dolara płacisz 26 centów. Następnie DeepSeek 3.2 oddał ten sam wynik za 10 centów, a dziś Ling-3 flash robi to za 4,7 centa.
A modele przecież wciąż mądrzeją. Poziom trzydziestu punktów otworzyła wersja 5.2 od 1,90 dolara za zadanie — i niedługo później zeszło to dosłownie do 3 centów. Czterdziestki i pięćdziesiątki: Opus 4.7 wszedł w ten prog mocno, wynikiem 41 w indeksie, przy 3,85 dolara za zadanie.
Przy okazji zabawna prawidłowość: nowy model otwierający nowy poziom inteligencji wcale początkowo nie jest dużo droższy. Przy O1 ten nowy poziom kosztował wyraźnie więcej, kolejny już mniej więcej tyle samo, następny minimalnie drożej. Nawet gdy pojawia się nowy poziom inteligencji, koszt nie skacze mocno w górę. I uwaga na odczyt wykresów: osie są wykładnicze, skala kosztów logarytmiczna — na samej górze jest 16 dolarów, a w połowie wysokości dolar. Miej to z tyłu głowy.
A teraz spojrzenie na dzień dzisiejszy — jedno z najzacieklejszych pól bitwy w historii dużych modeli. Opus 4.7 dał istotny skok: 41 punktów w indeksie. Niedługo potem 5.6 Tera — wynik wyższy za niemal połowę ceny. Następnie GLM 5.3 — jeszcze wyżej, za mniej niż jedną trzecią. I wreszcie GLM 5.3 Flash — praktycznie ten sam wynik za jedną setną ceny. Więc choć teraz może boleć, bo właśnie dokonaliśmy kolejnego takiego skoku, to przy zadanym poziomie inteligencji ceny spadają masowo — znacznie więcej niż dziesięciokrotnie rok do roku.
Czwarty wymiar: zmieniło się to, jak używamy modeli
Gdy mówiłem o trzech rzeczach, trochę oszukałem, bo jest jeszcze jeden element. W miarę jak modele mądrzały, zmieniał się sposób ich użycia. Kiedyś model autouzupełniał nam pojedynczą funkcję w kodzie. Dziś dostaje zrzut ekranu z bugiem i sam doprowadza zmianę do wdrożenia. Potrafią o wiele więcej, pracują od końca do końca i rzadziej wymagają naszej ingerencji, bo lepiej trzymają się zadania.
Tak, nasze rachunki rosną — nie zamierzam nikogo przekonywać wbrew faktom, że jest inaczej. Ale nie dlatego, że drożeje token. Dlatego, że rośnie zużycie. Korzystamy z tych modeli o wiele więcej: pracują dłużej, biorą na siebie większe zadania, wykonują pracę, przy której dawniej musieliśmy bez przerwy interweniować. To, że generujemy wielokrotnie więcej tokenów na zapytanie, jest oznaką sukcesu — bo modele stały się tańsze, lepsze i bardziej zdolne.
Paradoks Jevonsa, czyli czemu „taniej” oznacza „droższy rachunek”
(Informacja dodatkowa: paradoks Jevonsa — obserwacja z XIX wieku: gdy korzystanie z jakiegoś zasobu staje się tańsze i efektywniejsze, całkowite wydatki na ten zasób rosną, a nie maleją.)
To w gruncie rzeczy klasyczny paradoks Jevonsa. Gdy energia parowa potaniała, a węgiel stał się dostępny, zaczęliśmy wydawać na nie znacznie więcej — bo nagle opłacało się sięgać po nie tam, gdzie wcześniej nie było to sensowne. Nasze rachunki nie rosną dlatego, że modele są droższe. Rosną, bo znacznie intensywniej korzystamy z drogich modeli. To naprawdę takie proste.
I tu robi się najciekawiej. Ktoś na czacie napisał: „Wyobraźcie sobie inteligencję Fable 5.1 w cenach GLM 5.3 Flash”. To się wydarzy. Na pewno się wydarzy — bo wcześniej trochę kręciłem. Porównywałem bowiem stawki 5.3 Flash ze stawkami GPT-5 i to zestawienie było nieuczciwe. Nie wobec GPT-5 — wobec GLM 5.3 Flash, bo nie oddawało mu sprawiedliwości. 5.3 Flash to o niebo lepszy model niż GPT-5. Za wszystko wolałbym pracować na GLM 5.3 Flash niż na czegokolwiek na GPT-5, bo 5.3 Flash ma w sobie cały postęp, jaki branża zrobiła przez ostatni rok. Lepiej widzi, lepiej obsługuje wywołania narzędzi, a przede wszystkim komicznie lepiej radzi sobie z pracą agentską rozciągniętą na godziny zamiast sekund. GLM 5.3 Flash to nie tylko tańszy sposób na osiągnięcie poziomu GPT-5 — to po prostu lepszy model w każdym praktycznym wymiarze. Jedyne, czego mu brakuje w porównaniu z GPT-5, to trochę więcej wiedzy bez sięgania do wyszukiwarki. Ale dajcie obu dostęp do wyszukiwania i zmierzcie je w dowolnym teście wiedzy — 5.3 Flash zmiótłby GPT-5 z różnicą rzędu wielkości, po prostu dlatego, że umie szukać i umie korzystać z narzędzi, więc dochodzi do lepszych rozwiązań nawet przy „mniejszym mózgu”. Małe modele z dobrymi narzędziami miażdżą ubiegłoroczne najmądrzejsze modele — nawet gdy te również dostają narzędzia — bo w tej dziedzinie poczyniliśmy ogromny postęp. I takich usprawnień będzie przybywać.
A mówi to człowiek, który niedawno twierdził, że osiągnęliśmy szczyt.
Rozliczenie z własnej prognozy
Dwa lata temu nagrałem materiał — jeszcze w czasach blond włosów i wąsa — pod tytułem „AI nie będzie się już poprawiać”, bo miałem wrażenie, że trochę utknęliśmy w miejscu. Na wykresie widać było GPT-3.5, potem GPT-4, jego pośrednią wersję i 4o — bez istotnego postępu w testach, na które wtedy patrzyliśmy. Ale to nie modele stanęły w miejscu. To testy były przesycone; potrzebowaliśmy nowych.
Pomyliłem się jak mało kto. Nigdy w życiu nie opublikowałem gorszej prognozy i wyciągnąłem lekcję. Śmiejcie się ze mnie, ale z tej wersji mnie sprzed dwóch lat, dobrze? Morał jest taki: wciąż dopiero uczymy się mierzyć te poziomy inteligencji. Rozwój poszedł dalej, niż kiedykolwiek przypuszczałem, szybciej, niż się spodziewałem, i taniej, niż umiałem sobie wyobrazić. Kłopot w tym, że wszystko jest tak tanie i tak zdolne, że po prostu sypiemy tym pieniędzmi na prawo i lewo. Wydajemy mnóstwo, bo to mnóstwo jest tego warte. I to nie jest porażka.
Puenta: drożeje rachunek, nie inteligencja
„Inteligencja zbyt tania, by ją mierzyć” — nie, to nie dzieje się dokładnie tak, jak Sam Altman to sugerował. Ale wcześniejsza obietnica, inteligencja dziesięć razy tańsza, została nie tylko spełniona — wykonaliśmy ją z ogromnym nadwyżkowym zapasem. Zadania, do których używaliśmy AI rok temu, rzeczywiście staniały o pełny rząd wielkości. Różnica polega na tym, że dziś bierzemy się za rzeczy większe i trudniejsze. I, moim zdaniem, to jest znacznie ciekawsze.
Mimo wszystko — faktem jest, że można uzbierać 1500 dolarów wydatków dziennie, i nie chcę tego bagatelizować. Tylko powiem tak: z GPT-5 nie byłoby to możliwe. Nie dlatego, że było taniej, ale dlatego, że nie dałoby się wykonać aż tyle pracy. Wydatki na modele idą w parze z produktywnością, którą z nich czerpiemy — a tej nam przybywa.
Chyba powiedziałem wszystko, co miałem. Mam nadzieję, że teraz lepiej widać, dokąd płyną nasze pieniądze. I spokojnie: będzie jeszcze taniej, nawet jeśli w tej chwili tak nie wygląda. Trzymajcie głowy wysoko i czekajcie z niecierpliwością na wszystko, co jeszcze potanieje i nabierze zdolności. Ja jestem podekscytowany i mam nadzieję, że wy też. Do następnego razu — pa, nerdzy.