
O czym jest ten film
- Rok wędrówek między Lovable, Claude i Codex zostawia po sobie stertę plików, reguł i umiejętności, które nie potrafią ze sobą współpracować.
- Nawet najmocniejsze modele ignorują reguły, zgłaszają gotowość, gdy zadanie wcale nie jest skończone, i błyskawicznie wypalają limity tokenów.
- Główny winowajca to ciągła migracja między dostawcami modeli połączona z kompulsywnym instalowaniem modnych repozytoriów z GitHuba.
- Zaległe pliki — na przykład stary Obsidian z tysiącem nieaktualnych notatek — potrafią przepełnić okno kontekstowe jeszcze przed wysłaniem pierwszego promptu.
- Audyt nie wymaga gotowego mega-promptu: wystarczy opisać modelowi, co ma przejrzeć i względem jakich kryteriów ocenić.
- Zamiast armii subagentów czytających całą historię rozmów model pisze skrypt przeszukujący surowe logi JSONL pod kątem słów kluczowych i wywołań narzędzi.
- Raport z audytu punktuje obszary problemowe: martwe hooki dźwiękowe, nieużywane skille, sprzeczne reguły między Claude i Codex, gigabajty śmieciowych plików.
- Połączenie raportu z zadaniem cyklicznym daje system, który sam się porządkuje i nie puchnie z czasem.
- Dwa studia przypadków — Sarah z kilkoma firmami i Beth z agencją kampanii — sprowadzają się do jednego przepisu: ujednolicony agents.md plus zagnieżdżone pliki instrukcji dla każdego biznesu czy klienta.
- Na koniec pada trzystopniowy filtr decyzyjny przed każdym importem nowości: uniwersalność, zakres użycia i utrzymanie.
10 najważniejszych takeaways — z kontekstem zastosowania
1.Audyt zaczyna się od jasnego opisu, nie od mega-promptu
Na czym polega: Współczesnym modelom nie trzeba podsuwać skomplikowanego gotowca — wystarczy wyjaśnić, co dokładnie ma zostać zbadane (umiejętności, reguły, pliki instrukcji, ustawienia, wtyczki, podpięte narzędzia, agenci, projekty) i względem jakiego punktu odniesienia.
Jak stosować: Wklej prompt w duchu: „Nonstop przeskakuję między Claude i Codex. Przejrzyj moje środowisko w obu i powiedz, co działa, co jest balastem, a czego brakuje — projekt po projekcie”.
Na co uważać: Nie każ modelowi czytać wszystkich plików po kolei w kontekście — okno kontekstowe wypali, zanim dojdziesz do wniosków. Liczy się oszczędna metoda skanowania.
2.Historię rozmów przeszukuj skryptem, nie subagentami
Na czym polega: Zamiast zlecać subagentom czytanie setek rozmów od deski do deski, prosisz model o napisanie krótkiego skryptu, który w surowych logach JSONL wyszukuje sygnały frustracji, prośby o zmianę kierunku i faktyczne wywołania narzędzi.
Jak stosować: Dodaj do promptu: „Napisz skrypt, który przejrzy moje logi i wskaże, których narzędzi i skillów prawie nie używam, które reguły są przestarzałe oraz co mam skonfigurowane w jednym narzędziu, a czego brakuje w drugim”.
Na co uważać: Skrypt tylko zbiera dane. Interpretację zostaw modelowi, ale raport zweryfikuj własnym okiem — zanim coś usuniesz, upewnij się, że plik naprawdę jest martwy.
3.Raport zamów w formie strony internetowej
Na czym polega: Zamiast czytać wyniki audytu jak kolejny plik markdown, prosisz o wersję wizualną — stronę z podziałem na obszary i punktacją.
Jak stosować: Jedno zdanie wystarczy: „Przedstaw wyniki jako stronę internetową, z punktacją każdego obszaru i listą rekomendacji do kliknięcia”.
Na co uważać: Wizualizacja nie zastępuje myślenia — łatwiej w niej dostrzec absurdalną rekomendację, ale nadal trzeba ją przejrzeć krytycznie, zanim cokolwiek skasujesz.
4.Włącz przegląd w harmonogram — system będzie się sam czyścił
Na czym polega: Jednorazowy audyt nic nie da, bo bałagan wraca. Dopiero cykliczne zadanie (np. w Codex albo przez polecenie typu /schedule), które generuje raport i automatycznie usuwa rzeczy nie wymagające Twojej zgody, zamienia warsztat w samooczyszczający się organizm.
Jak stosować: Ustaw cykliczne zadanie i określ progi bezpieczeństwa, np. „usuń pliki nieużywane od siedmiu miesięcy, chyba że są oznaczone jako kluczowe”.
Na co uważać: Automatyzuj tylko zmiany o małym zasięgu szkód. Wszystko, co dotyczy ważnych danych albo reguł, którymi żyje Twój biznes, przechodź ręcznie.
5.Zanim zainstalujesz nowe repo — sprawdź, czy nie wystarczy odwołanie
Na czym polega: Większość modnych repozytoriów „rozwiązujących problem numer jeden Claude” nie rozwiązuje żadnego zasadniczego problemu, a na dodatek wcale nie trzeba ich instalować — model może sięgnąć do nich na żądanie.
Jak stosować: Zamiast pobierać skilla, napisz w prompcie: „Przy tym konkretnym zadaniu zajrzyj do tego repozytorium i skorzystaj z jego metody”.
Na co uważać: Każda zainstalowana umiejętność to dług: nachodzi na inne, wysyła sprzeczne sygnały i przestaje być aktualizowana. Stos skilli szybko zamienia się w cmentarzysko, które niezauważalnie spycha agentów na manowce.
6.Jeden agents.md zamiast osobnych plików dla każdego dostawcy
Na czym polega: Claude rozpoznaje już plik agents.md na równi z claude.md, a podobny format używa Gemini. To pozwala prowadzić jeden zestaw instrukcji, reguł i umiejętności dla wszystkich narzędzi, zamiast utrzymywać trzy rywalizujące ze sobą wersje.
Jak stosować: Wyobraź sobie diagram Venna z trzema okręgami: to, co wspólne dla wszystkich dostawców, trzymaj w jednym ujednoliconym agents.md; resztę przypisz do konkretnego środowiska tylko wtedy, gdy dana funkcja istnieje wyłącznie u jednego dostawcy.
Na co uważać: Kilka plików instrukcji ładowanych naraz na starcie sesji to prośba się o sprzeczne polecenia. Przed unifikacją wywal wszystko, co jest przeterminowane.
7.Globalny CLAUDE.md dziedziczy się w każdej sesji — ostrożnie z nim
Na czym polega: Globalny plik instrukcji jest wczytywany przy każdym uruchomieniu, niezależnie od projektu. Instrukcje odziedziczone „po cichu” trzeba ręcznie nadpisywać — pod warunkiem, że w ogóle pamiętasz, że tam są.
Jak stosować: Jeśli już go masz, przeglądnaj go podczas audytu i zostaw tylko reguły naprawdę uniwersalne. Resztę przenieś do plików projektowych.
Na co uważać: To właśnie globalne instrukcje są częstym źródłem sygnałów, których model tak naprawdę nie słucha. Objaw: zadanie wykonuje się inaczej, niż się umówiłeś, a Ty nie wiesz dlaczego.
8.Foldery per biznes czy klient z zagnieżdżonym agents.md
Na czym polega: Zamiast jednego tygla, tworzysz katalog na każdą linię biznesu (albo klienta), a w każdym z nich zagnieżdżony plik instrukcji. Globalny agents.md pełni wtedy rolę wieży kontroli lotów: wskazuje właściwy folder, a model dopiero w nim doczytuje szczegóły.
Jak stosować: Na starcie sesji ładowany jest tylko zewnętrzny plik; po wejściu do folderu fitnessu czy klienta B model czyta jego zagnieżdżoną wersję — z treścią, stylem scenariuszy, regułami specyficznymi dla tej roboty.
Na co uważać: Zagnieżdżanie działa tylko przy uczciwym rozdzieleniu kontekstów. Jeśli trzymasz wszystko w jednym katalogu, aktywa klienta A będą wyciekać do klienta B.
9.Wiedzę ekspercką zrzuć z głowy dyktowaniem, zamiast budować skille
Na czym polega: Największym marnotrawstwem jest wiedza ukryta — to, co czyni Cię dobrym w zawodzie — której nigdy nie przelałeś do plików. Godzina dyktowania „jak robię to, co robię” daje więcej niż dziesiątki pobranych skilli.
Jak stosować: Nagraj monotematyczny wykład z pamięci (np. „jak od zera powstaje mój lejek sprzedażowy, krok po kroku”), a potem każ modelowi zamienić go w proste pliki playbooków, do których AI odwołuje się przy odpowiednich zadaniach.
Na co uważać: Pliki playbooków trzeba utrzymywać — przy zmianie procedury zaktualizuj i je. Warto też sięgać po agentów czytających dokumentację (np. przewodniki Claude czy OpenAI), żeby konfiguracja trzymała się aktualnych dobrych praktyk.
10.Trzy pytania przed każdym importem nowości
Na czym polega: Zamiast działać odruchowo na widok nowego modelu czy repo, przepuszczaj każdą nowość przez filtr: (1) Czy będzie potrzebna przy większości zadań? Czy bez niej robiłbym dzisiejszą robotę gorzej? (2) Czy przydaje się tylko czasami — a więc nie jest elementem globalnym? (3) Kto i kiedy to utrzyma?
Jak stosować: Przy pytaniu pierwszym sprawdź często tanszą opcję: każ AI przejrzeć dany skill i przenieść do Twojej konfiguracji tylko tę jedną instrukcję, która realnie coś wnosi. Wiele skilli sprowadza się ostatecznie do pojedynczego zdania.
Na co uważać: Im lepsze modele, tym mniej skillów i regułów potrzebujesz — smok rośnie w siłę, a smycz może być coraz krótsza. Kto tego nie porządkuje wyprzedzająco, ten zamiast zbierać korzyści z nowych modeli będzie w kółko z nimi walczyć.
Redakcyjne tłumaczenie
Chaos, który narasta po cichu
Jeśli od dłuższego czasu budujesz albo po prostu użytkujesz własny „system operacyjny AI”, to niemal na pewno jest on w chaosie — i najprawdopodobniej nie ma to nic wspólnego z Twoją niedbałością. W ciągu ostatniego roku mogłeś wędrować od Lovable do Claude, stamtąd do Codex, żeby w końcu wrócić do Claude. Po drodze instalowałeś każdą umiejętność i każde akurat modne repozytorium z GitHuba. Wszystko to kumulowało się w tle, aż w końcu masz przed sobą stertę zasobów, które nie potrafią ze sobą współpracować. Do tego dochodzi to, że nawet modele z absolutnej czołówki ignorują Twoje reguły, oświadczają, że zadanie jest skończone, choć nie jest, a limity tokenów znikają w mgnieniu oka. W tym materiale pokażę, jak z tego chaosu zrobić porządek.
Jak wygląda typowy „system operacyjny AI” po roku wędrówek
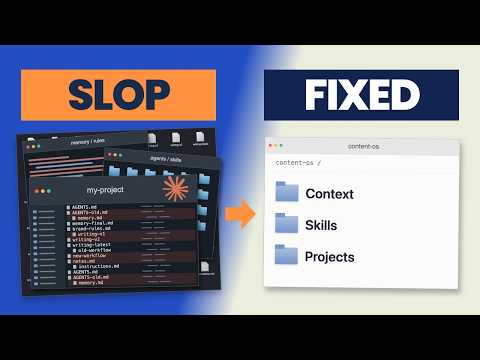
Kilka miesięcy temu termin „system operacyjny AI” (AIOS) zrobił zawrotną karierę. Ja jednak, po dziesiątkach rozmów z założycielami firm, widzę wciąż ten sam schemat. Oto hipotetyczny, ale całkiem realistyczny obraz takiego systemu — i to jeszcze wersja „czystsza”. Znajdziesz w nim cały szereg plików agents.md, kilka plików pamięci o nazwach „pamięć numer 1”, „pamięć numer 2”, „finalna”, a wreszcie „prawdziwa pamięć”. Do tego zlepek różnorodnych plików markdown, na przykład soul.md — pamiątka po OpenClaw albo Hermes, narzędziach z innej epoki. I wszystko to mieszka w jednym wielkim tyglu.
Sedno problemu: mnóstwo niedokończonych konstrukcji. Budujesz system operacyjny dla treści, dla premier produktów, dla wzrostu — żaden nie doprowadzony do końca. Za chwilę przejdę do konkretnych przykładów z rozmów z założycielami i tego, co chcieli zbudować. Ale przez samą liczbę nowości zrzucanych na rynek co tydzień, przez niekończące się listy trendujących repozytoriów, które odciągają uwagę od tego, co naprawdę się liczy i co zarabia na siebie, zostaje Ci imperium plików — de facto system operacyjny AI, w którym panoszy się śmieciowy potwór.
(Informacja dodatkowa: „slop” — pojęcie pojawiające się dalej w tekście — to żargonowe określenie masowo generowanych, niskiej jakości treści AI; soul.md to nazwa pliku osobowości stosowana w niektórych otwartych agentach, np. OpenClaw czy Hermes.)
Przyczyna: bezustanna migracja między dostawcami
Największym winowajcą jest ciągłe przenoszenie się od dostawcy do dostawcy. Jesteśmy w tym względzie notorycznie niewierni: nie mam żadnych sentymentów do Claude ani Codex — a gdyby któregoś dnia Gemini obudził się jako model, z którego da się realnie korzystać, przeniósłbym się bez mrugnięcia. Zawsze idę tam, gdzie traktują mnie najlepiej, i domyślam się, że większość z Was jest podobna.
Problem w tym, że takie wędrówki zostawiają po sobie graty: testy uruchamiane bez patrzenia, co właściwie robią; tymczasowe wersje plików, których nikt nigdy nie usuwa. Efekt? Mocno przeładowana infrastruktura. Możliwe, że masz gdzieś Obsidiana sprzed kilku miesięcy — z czasów, gdy było to modne — i teraz leży odłogiem, a znaczna część notatek w środku dawno straciła aktualność. Tak dochodzisz do setek, jeśli nie tysięcy plików żyjących poza Claude i Codex — a do tego jeszcze pliki pamięci i reszta rupieci w samych folderach tych narzędzi. Gdy się to wszystko sumuje, okno kontekstowe jest przepełnione, zanim wyślesz pierwszy prompt.
Realnie powinniśmy umieć przejść od takiego stanu do wzorcowego — wyłącznie promptami i przeglądem tego, co już posiadamy.
Audyt bez gigantycznego promptu
To jest moment, w którym spodziewałbyś się, że wrzucę wielki, kompleksowy prompt do przeprowadzenia audytu. W praktyce nie jest Ci on potrzebny. Współczesnym modelom wystarczy jasno wyjaśnić, co dokładnie ma zostać zbadane, względem jakiego punktu odniesienia i jakiej ramy — resztę ogarną same. W gruncie rzeczy wystarczy powiedzieć coś w stylu:
„Nieustannie przeskakuję między Claude i Codex. Przejrzyj moje środowisko w obu narzędziach i powiedz, co działa, co jest balastem, a czego brakuje. Uwzględnij umiejętności, reguły, pliki instrukcji, ustawienia, wtyczki, podpięte narzędzia, agentów — oraz każdy projekt traktowany jako osobny system.”
Niuans, na który warto zwrócić uwagę: skrypt zamiast subagentów
To sekcja, której warto się przyjrzeć, bo jest subtelniejsza, niż mogłoby się wydawać. Standardowo poprosiłbym Claude albo Codex o rozpędzenie zespołu subagentów, które przejrzałyby wszystkie nasze dotychczasowe rozmowy od początku do końca i przeanalizowały używane narzędzia czy napotykane trudności. Tyle że rozmów może być setki, jeśli nie tysiące — a koszt takiej operacji urósłby błyskawicznie.
Dlatego proszę o coś innego: o napisanie krótkiego skryptu. Skrypt może wyszukiwać słowa kluczowe, które zwykle towarzyszą mojemu opieraniu się na Claude albo frustracji; może też przejrzeć pliki JSONL, czyli surowe logi rozmów — pokażę na ekranie, jak w ten sposób precyzyjnie wychwycić, które narzędzia były wywoływane, a które nie. (Informacja dodatkowa: JSONL to format dziennika, w którym każdy wpis zapisany jest jako osobna linia JSON; w takiej formie Claude Code i Codex trzymają historię sesji.)
Dalej każę modelowi wskazać, czego prawie w ogóle nie używam, które reguły są przestarzałe i co mam skonfigurowane w jednym narzędziu, a czego brakuje w drugim — to szczególnie ważne, jeśli chcesz być niezależny od dostawcy i zachować swobodę przeskakiwania od Claude do Codex i dalej, do dowolnego innego modelu. Punkty czwarty i piąty dotyczą tego, które ustawienia, automatyzacje, zadania cykliczne i elementy projektów raczej Cię hamują, a które pchają do przodu. I jeszcze jedno: zamiast czytać raport jak zwykły plik markdown, poproś o wersję w formie strony internetowej. Element wizualny pozwala przejrzeć całość i upewnić się, że to, co model każe usunąć, faktycznie ma sens.
Raport po trzydziestu minutach
Po około pół godzinie dostaję raport: przebieg wszystkich wpisanych przeze mnie wiadomości i dziesięć najpilniejszych zmian — a patrząc na nie teraz, sam się niektórych dziwię. Mam na przykład osiem martwych hooków dźwiękowych, czyli drobnych skryptów odpalających dźwięk. To relikty z czasów, gdy zaczynałem pracę z Claude Code i chciałem, by po zakończeniu zadania rozlegał się sygnał — bo zdalnego sterowania i porządnych powiadomień wtedy po prostu nie było. Nigdy nie wiesz, co jeszcze kryje się w prehistorycznych warstwach Twoich narzędzi.
Na podstawie wszystkich rozmów w Codex i Claude raport zalecił, by wszystkie reguły dotyczące pisania — w tym usuwanie charakterystycznych „ai-izmów” i stylistycznej papki — trzymać w jednym współdzielonym pliku, który oba narzędzia mogą ładować. Niżej na liście: cała masa losowych śmieciowych plików, zajmujących pewnie gigabajty, jeśli nie terabajty. Raport punktuje też każdy obszar, więc od razu widać, gdzie dokładnie leży problem.
System, który sam się sprząta
Obiecuję: jeśli zrobisz taki przegląd raz, a potem ustawisz harmonogram — zadanie cykliczne w Codex albo polecenie typu /schedule — żeby raport generował się regularnie i automatycznie naprawiał większość rzeczy nienaruszających Twojej zgody (na przykład usuwał martwe pliki nieużywane od siedmiu miesięcy, przy założeniu, że nie są krytyczne), dostaniesz system, który przynajmniej sam się czyści: nie puchnie z czasem i nie zbiera kurzu.
W dalszej części raportu widać każdą rzadko używaną umiejętność — wiele z nich, jak sam widzę, dotyczy Obsidiana, bo od dawna przestałem go używać. Starsze mechanizmy „refleksji” nad rozmowami bywają pomocne, ale gorzej podpowiadają, co usunąć, a co dodać.
Osobna sprawa: reguły. Jeśli jesteś mniej techniczny albo masz mało czasu na Claude Code, a przy tym oglądasz filmiki, kopiujesz transkrypcje i każesz Claude robić to za Ciebie, prędzej czy później odkryjesz, że Twoje reguły w Claude i Codex są ze sobą sprzeczne. Wtedy zlecając komuś zadanie, możesz dostać rezultat inny, niż się spodziewałeś. Resztę raportu da się przejrzeć szybko — i w większości warto się pogodzić z tym, żeby system mógł przyciąć całą tę konstrukcję. W ten sposób usuwasz nadmiar informacji i szumu, który najpewnie jest źródłem Twoich problemów.
Niskie ryzyko, duża nagroda: porządki konfiguracji
Ciekawa nowość w aplikacji Claude Desktop: po takim przeglądzie (na przykład z użyciem mojego promptu) dostajesz rekomendację wykonania niskoryzykownych porządków konfiguracji. Możesz ją przejrzeć i powiedzieć: „Zrób wszystko oprócz tego, tego i tego”. Możesz też po prostu puścić z automatu — w dziewięciu przypadkach na dziesięć, gdy testowałem ten prompt, proponowane zmiany mają znikomy zasięg potencjalnych szkód.
I jeszcze jedna ważna rzecz: jeśli spojrzysz na zużycie kontekstu, to mimo skanowania obu środowisk, wszystkich reguł i umiejętności — tylko dlatego, że zrobiliśmy to nieco oszczędniejszą metodą — wykorzystaliśmy ledwie jedną trzecią dostępnego okna kontekstowego.
To jednak był strzał jednorazowy. Problem wróci, jeśli za każdym razem nadstawisz karku na te same pułapki.
Higiena nawyków, nie tylko plików
Jedno jest posprzątać warsztat, a drugie — posprzątać nawyki. Jeśli łapiesz się na FOMO, jeśli ciągle czujesz, że musisz wiedzieć o każdej zmianie o jeden procent w działaniu skilli, że musisz obejrzeć ten filmik na YouTube i natychmiast podmienić konfigurację — ten fragment jest dla Ciebie.
Zobaczysz komunikaty w stylu: „przestań robić to, zacznij robić tamto”. Albo: „wklej tę jedną rzecz do Claude i już nigdy nie trafisz na limity” — i przy okazji rozwiązemy głód na świecie oraz pokój na Ziemi. Albo mój prywatny antybohater, bo na niego łapie się najwięcej osób: „to repo rozwiąże problem numer jeden Claude, Codex czy Geminiego”. A jak się przyjrzysz, zwykle nie rozwiązuje ono żadnego zasadniczego problemu. Często w ogóle nie musisz go instalować: wystarczy fragment promptu — „sięgnij do tego repozytorium przy wykonaniu tego konkretnego zadania”. Nie musisz pobierać skilla i dokładania go do stosu pozostałych, które i tak leżą na cmentarzysku.
Efekt wygląda tak: piętrzysz umiejętności, z których każda osobno jest pomocna, ale wszystkie razem, po pierwsze, nachodzą na siebie; po drugie, wysyłają sprzeczne sygnały; po trzecie, i tak nie aktualizujesz ich do najnowszych wersji. Z czasem o nich zapominasz — a skoro o nich zapominasz, zaczynają niezauważalnie prowadzić Twoich agentów w złą stronę.
Jeden stopień błędu — żeglarska analogia
Krótka analogia, żeby to osadzić. Wyobraź sobie, że płyniesz na wschód — powiedzmy z Nowego Jorku do Glasgow — i z jakiegoś powodu źle nastawisz kurs, o jeden stopień. Jeden stopień sam w sobie to zdaje się nic. Ale na końcu rejsu lądujesz w zupełnie innym miejscu.
Tak samo kusi ciągłe uleganie najnowszym modelom, frameworkom, umiejętnościom, technikom i zmianom w promptowaniu. Ale jeśli płaci za to utrzymanie tego, co już zbudowałeś, to nie zboczysz z kursu o jeden stopień — możesz zboczyć o pięć, dziesięć, piętnaście. I zauważysz to w każdej sesji: będziesz spalać mnóstwo czasu i tokenów bez najmniejszego postępu, kręcąc się w kółko.
Zamiast tego obserwuj subtelne zmiany, które ułatwiają zwinność i niezależność od konkretnego modelu. Znakomity przykład: Anthropic sprawiło w końcu, że Claude rozpoznaje plik agents.md na równi z claude.md. Dotąd, żeby pracować w Claude i Codex, potrzebowałeś dwóch plików: claude.md i agents.md. Gemini też korzysta z wersji agents.md — a więc jeden taki plik obsłuży kilku dostawców naraz. Możesz wreszcie napisać jeden agents.md, jeden zestaw umiejętności, jeden zestaw reguł i znaleźć sposób, by działały wszędzie. (Informacja dodatkowa: claude.md i agents.md to pliki instrukcji wczytywane automatycznie na starcie sesji przez, odpowiednio, Claude Code i Codex; agents.md stopniowo staje się wspólnym standardem wielu narzędzi.)
Żeby to zabarwić przykładami, przeprowadzę Cię przez dwa prawdziwe przypadki założycielek, z którymi niedawno pracowałem — i przez to, jak ich systemy wyglądały przed i po.
Studium przypadku: Sarah i kilka firm naraz
Pierwsza — nazwijmy ją Sarah — prowadzi nie jedną, a kilka firm. Każda ma własne głosy, własne treści i własne projekty do wykonania. A jej historia wędrówek to klasyka: Claude, potem Gemini, z powrotem Claude, potem Codex i znów Claude. W efekcie: claude.md, agents.md, plik dla Geminiego, a pomiędzy krótki epizod z agentem Hermes, z którego szybko się wycofała, wracając do zwykłych dostawców.
Pierwszy zasadniczy problem: kilka różnych plików rywalizuje o to, by wydawać instrukcje w chwili, gdy otwierasz nową sesję w Claude, Codex czy Geminim. Do tego piętnaście umiejętności, z których tylko trzy faktycznie posuwały biznes. Reszta to rzeczy polecane na YouTube — pobrała je, bo pojedynczo wyglądały znakomicie, ale nigdy nie zrobiła z nich wersji dopasowanej do swojego stosu. Na to wszystko Obsidian z tysiącem czterystoma notatkami, z których może dziesięć procent dotyczy dzisiejszej pracy. Łatwo sobie wyobrazić, że z czasem ten odsetek zgnije do pięciu, do jednego procenta. I wreszcie globalny claude.md.
Jeśli nie wiesz, co to jest: claude.md udziela instrukcji ładowanych w chwili startu sesji. Jeśli uczynisz go globalnym, każda sesja — niezależnie od projektu — odziedziczy większość tych instrukcji, i żeby je nadpisać, musisz pamiętać, że w ogóle tam są. Problem w tym, że zwykle nie pamiętasz. Efekty: sprzeczne sygnały, reguły, których AI tak naprawdę nie słucha, i cała gama innych kłopotów.
A tak wygląda „po”. Przycięliśmy i przejrzeliśmy wszystkie pliki, tworząc jeden ujednolicony agents.md. Pomocna okaże się metafora diagramu Venna z trzema okręgami — po dolożeniu ostatniego (przy założeniu, że używasz trzech dostawców) zobaczysz rzeczy wspólne dla wszystkich: może umiejętność, zestaw reguł, instrukcje, które łatwo odhaczyć. Pojawią się też rzeczy specyficzne dla danego środowiska i dostawcy — część przeterminowana, część aktualna. Celem jest unifikacja: nic nie powinno być przypisane do konkretnego dostawcy, chyba że dana funkcja czy struktura istnieje wyłącznie u niego.
Uproszczenie reszty jest banalne: tworzysz osobne foldery na różne części biznesu, styl życia i tak dalej. Wewnątrz nich możesz mieć zagnieżdżony agents.md — nie jest on ładowany przy starcie nowej sesji; wtedy czytany jest tylko plik zewnętrzny, globalny. Gdy chodzi o optymalizację pod kilka firm, wystarczy jeden folder na każdą linię biznesową. Zewnętrzny agents.md pełni rolę wieży kontroli lotów: wskazuje właściwy katalog. A gdy już w niego wejdziesz, używany model czyta kolejny, zagnieżdżony plik, doprecyzowujący, co chcemy robić — na przykład w obszarze fitnessu: jaka treść, jaka struktura, jaki styl scenariuszy, jaki montaż wideo.
Studium przypadku: Beth i kampanie dla klientów
Druga założycielka — nazwijmy ją Beth — ma zupełnie inny profil. Zajmuje się premierami i kampaniami marketingowymi: jest ekspertką od lejków w GoHighLevel, stron internetowych, webinarów na zimny ruch, reklam na Facebooku i całej reszty. (Informacja dodatkowa: GoHighLevel to popularna wśród agencji platforma marketingowo-sprzedażowa.)
Jej system wyglądał tak: jeden folder na klienta. U części klientów były skille specyficzne dla nich, u części agents.md, u części — zupełnie nic. Po uczciwym przyznaniu się do obejrzenia dziesiątków tutoriali z YouTube: dwa „drugie mózgi”, z których nie używała żadnego — więc musiała polegać na tym prawdziwym. Najgorsze w moich oczach było jednak co innego: dysponowała ogromem wiedzy ukrytej o tym, co czyni ją świetną w zawodzie, i nigdy nie poświęciła czasu, by ją z siebie zrzucić i pozwolić Claude i Codex na niej pracować. Choćby z użyciem agenta Claude Code Guide — subagent specjalizującego się w czytaniu dokumentacji Anthropic i dopasowywaniu warsztatu do modeli Claude. To samo z umiejętnością OpenAI Doc: gdy pracujesz w Codex, może ona sięgnąć po najświeższe dobre praktyki. Wtedy wystarczy powiedzieć: „Oto mój biznes, oto czym się zajmuję i oto mój cel” — a model ułoży z tego sensowny plan porządku środowiska.
Skutek przed zmianami: plątanina kabli. Aktywa przygotowane na premierę u klienta A wyciekały do klienta B i odwrotnie. A tak wygląda „po”: znów jeden ujednolicony agents.md oraz nowy folder „playbooki”, do którego zrobiliśmy pełny zrzut wiedzy z głowy. Godzina dyktowania: jak zaczynam, jak generuję pomysły, jak powstaje pierwsza wersja lejka; jak wygląda ściągnięcie kogoś na zimny webinar; co robimy podczas tego webinaru. Wyobraź sobie zmapowanie każdego kroku — samego mówieniem do dyktafonu. Na tej podstawie powstały dwa proste pliki: launch.md i webinar.md. Zamiast tworzyć skille, każemy AI odwoływać się do tych plików zawsze, gdy zadanie tego wymaga. Co do klientów — zwykły folder „klienci” z podfolderami A, B, C i tak dalej; każdy, jak poprzednio, może mieć zagnieżdżony agents.md, który tłumaczy, czym ten klient różni się od innych, oraz wskazuje właściwe dla niego umiejętności i reguły.
Mam nadzieję, że te dwa proste przykłady pokazują, jak eleganckie może być rozwiązanie: przejść od warsztatu, który Cię hamuje, do takiego, który pozwala skupić się na pracy nad biznesem, a nie w biznesie.
Trzy pytania przed każdym importem
Na koniec zostawiam trzystopniową ramę, która pomoże chronić Twój warsztat — i głowę — oraz świadomie zawęzić pole widzenia do tego, co naprawdę ważne. Gdy zobaczysz następny model czy repo, zamiast natychmiast klikać, pobierać, używać przez dwa dni jak nowej zabawki i wyrzucać do skrzynki po zabawkach na zawsze — zrób to:
Pytanie pierwsze — uniwersalność. „Czy ta rzecz będzie potrzebna albo pomocna przy każdym lub większości moich zadań? Gdybym jej nie miał, robiłbym dzisiejszą robotę gorzej?” Zwykle prowadzi to do kolejnego pytania: „Czy da się ją czymś zastąpić? Czy zamiast pobierać skilla, mogę po prostu wskazać go AI: «jest w nim jedna rzecz, która może Cię usprawnić w X — przejrzyj go i przenieś do mojej konfiguracji tę jedną instrukcję?»” Bo mnóstwo skillów sprowadza się ostatecznie do jednego zdania instrukcji, które potrafi wynieść pracę z AI na wyższy poziom.
Pytanie drugie — zakres. „Czy to się przydaje tylko czasami?” Jeśli tak, to nie element globalny, tylko specyficzne narzędzie, reguła albo zasób, wyjmowany raz na ruski rok.
Pytanie trzecie — utrzymanie. Tu wchodzi cykliczne zadanie z promptem, który pokazałem wyżej. I gwarantuję: im lepsze modele, tym mniej skillów i reguł będziesz potrzebować. Będziesz mieć coraz potężniejszego smoka, którego nie trzeba już trzymać na długiej smyczy. Skoro to wiesz — działaj wyprzedzająco. Wtedy realnie zbierasz korzyści z lepszych modeli, zamiast bez końca walczyć z Claude, Codex czy czymkolwiek innym i nie robić postępu, o który naprawdę Ci chodzi.
Na koniec
Prompt z tego materiału oraz krótki przewodnik, który możesz wkleić wybranemu AI, by pomogło Ci zdecydować, co warto wyczyścić, wycofać i dodać, znajdziesz w opisie. A jeśli takie treści są Ci bliskie i chcesz więcej — w tym bezpośredniego dostępu do mnie oraz spersonalizowanych materiałów wideo w mojej społeczności dla osób, które wcześnie wdrażają AI — zajrzyj do pierwszego linku w opisie. Na co dzień jestem konsultantem AI i wykładowcą; żyję tym dosłownie od rana do wieczora. Jeśli materiał był pomocny, polub go i zostaw komentarz — do zobaczenia w następnym.