
O czym jest ten film
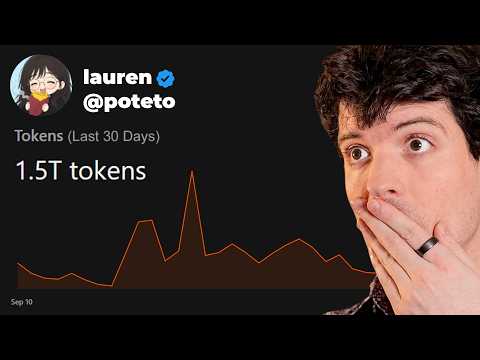
- Wiralowy wpis na X zarzuca Lauren — inżynerce Cursora, twórczyni P-stacka i React Compilera — „przepalanie” 132 mln dol. rocznie na tokenach, bo jej profil Cursora pokazuje 1,5 bln tokenów w 30 dni.
- Theo rozbiera to wyliczenie: kluczowe założenie „8 dol. za milion tokenów” jest mylne około dwudziestokrotnie — jego własny, realny średni koszt to 41 centów za milion.
- Powód: profil Cursora podaje zagregowaną liczbę, a cztery typy tokenów (odczyt i zapis cache, wejście, wyjście) mają drastycznie różne ceny. Odczyty z cache — 20 centów za milion w Opusie — stanowią około połowy rachunku.
- Drugi czynnik: dużym graczom przysługują głębokie rabaty. Cursor, należący dziś do xAI, oddaje Anthropicowi moce obliczeniowe, więc ich umowa jest niemal na pewno wyjątkowa. Szacunek Theo: 15–50 tys. dol. miesięcznie.
- Kontekst biznesowy: tokeny Lauren przekładają się na realne ulepszenia Cursora i Grokbota, a jej zasięgi w social mediach są warte więcej niż firmowe eventy za ponad milion dolarów.
- Trendy efektywności: koszt utrzymania danego poziomu inteligencji spada około 10-krotnie rok do roku, ostatnio nawet 100-krotnie w 6–8 miesięcy (Sonnet 4.5: 56 centów za zadanie, rok później odpowiednik za 0,45 centa).
- Własny test Theo (Skate Bench): O1 z grudnia 2024 uzyskał 67,7 proc. za 11–12 centów na pytanie; rok później Gemini 3 Flash, a potem GLM 5.3 Flash osiągają lepsze wyniki za ułamek ceny — 58x i około 680x taniej.
- Polemika z Zeegiem (Davidem Cramerem z Sentry): teza, że „inteligencja nie tanieje netto”, bo stare modele są wycofywane, benchmarki kłamią, a „zadanie, które rok temu kosztowało 10 centów, kosztuje nadal”.
- Zmiana przepływów pracy: kiedyś „zaznacz kod, Cmd+K, sam zrestartuj serwer”, dziś „wrzuć zrzut ekranu i napisz: napraw” — koszt pojedynczego zapytania to nie koszt całej pracy, bo tę przejął model.
- Praktyczne morały: weryfikuj wiralowe liczby (poradzi sobie z tym każdy dzisiejszy model), odróżniaj dyskusję o faktach od ataków na czyjeś motywacje, a budżet tokenowy licz łącznie z wartością produktu, badań i marketingu.
10 najważniejszych takeaways — z kontekstem zastosowania
1.Liczba tokenów to nie rachunek — poznaj cztery cenniki
Na czym polega: Profil Cursora (i większość publicznych statystyk) pokazuje sumę tokenów bez rozbicia na typy: odczyt z cache, zapis do cache, zwykłe wejście i zwykłe wyjście. Ceny różnią się o dwa rzędy wielkości — w Opusie 5.5 wejście to 5 dol., wyjście 25 dol., ale odczyt z cache tylko 20 centów za milion.
Jak stosować: Zanim oszacujesz koszt jakiegoś workloadu (swojego lub cudzego), rozdziel zużycie na typy i policz każdą stawkę osobno. W API i narzędziach typu Cursor sprawdzaj dane o użyciu z podziałem, a nie jedną liczbę zbiorczą.
Na co uważać: Pomnożenie jednej „średniej” stawki przez sumę tokenów dało w omawianym wpisie błąd dwudziestokrotny — 8 dol. za milion zamiast realnych 41 centów.
2.W długich sesjach agentowych o rachunku decyduje cache
Na czym polega: Przy wielogodzinnych przebiegach agentowych połowa kosztu to odczyty z cache — najtańszy typ tokena. Tokeny wejściowe i wyjściowe, na których zwykle opiera się wyliczenia, potrafią odpowiadać za mniej niż 8 procent rachunku.
Jak stosować: Projektuj zadania tak, żeby maksymalizować trafienia w cache: stabilny kontekst, powtarzalne początki promptów, długie sesje zamiast pojedynczych zapytań od zera.
Na co uważać: Ceny katalogowe wejścia i wyjścia w ogóle nie opisują kosztu pracy agentycznej — każdy szacunek oparty tylko na nich jest do kosza.
3.Cennik API to górna granica, nie realność
Na czym polega: Duzi odbiorcy negocjują głębokie rabaty (w materiale mowa o 90 proc. i więcej), a powiązania biznesowe potrafią obniżyć realny koszt jeszcze mocniej — Cursor wymienia moce obliczeniowe z Anthropicem i przez lata był głównym źródłem jego przychodów.
Jak stosować: Przy analizach kosztów konkurencji albo planach własnych wydatków traktuj ceny publiczne jako najgorszy scenariusz. Własne zużycie wyceniaj po fakturach, nie po cenniku.
Na co uważać: Dramatyczne tezy o „marnowaniu setek milionów”, policzone po cenach katalogowych, mówią więcej o autorze wyliczenia niż o badanej firmie.
4.Cena ustalonego poziomu inteligencji spada 10–100x rocznie — i coraz szybciej
Na czym polega: Ten sam wynik na indeksie inteligencji kosztuje z roku na rok ułamek poprzedniej ceny: zadanie Sonneta 4.5 za 56 centów rok później wykonuje model o tej samej skali za 0,45 centa; w teście Theo spadki sięgały 58x rok do roku i 680x w niecałe dwa lata.
Jak stosować: Planując budżety i wybór narzędzi, zakładaj, że dziś droga inteligencja za 6–12 miesięcy stanie się tania. Nie podpisuj długich zobowiązań po dzisiejszych stawkach i nie odrzucaj strategii „drogiego” AI tylko dlatego, że dziś jest drogie.
Na co uważać: Porównuj ten sam poziom inteligencji, a nie najnowszy model z jego przodkiem — inaczej zmierzysz postęp, nie spadek ceny.
5.Porównuj modele równoważne, nie najnowsze z najstarszym
Na czym polega: Wrażenie, że „nic nie tanieje”, bierze się z ciągłego kupowania najdroższej opcji. To jak narzekanie, że iPhone’y nie tanieją, przy jednoczesnej odmowie kupna zeszłorocznego modelu.
Jak stosować: Gdy rachunek rośnie, przetestuj tańszy wariant albo model o klasę niżej — GLM 5.3 Flash okazał się w testach 29 razy tańszy od GPT-5, a przyjemniejszy w pracy.
Na co uważać: Wycofywanie starych modeli to nie spisek podnoszący ceny — utrzymywanie nieefektywnych wersji, gdy istnieją lepsze i tańsze, po prostu nie ma sensu ekonomicznego.
6.Zanim porównasz koszty, zdefiniuj „zadanie”
Na czym polega: Dawniej „napraw buga” oznaczało: znajdź błąd, zaznacz kod, poproś model o edycję, sam zapisz, sam zrestartuj serwer, sam sprawdź w przeglądarce. Dziś to wrzucenie zrzutu ekranu ze słowem „napraw”. Samo zapytanie może kosztować podobnie, ale człowiek już nie wykonuje całej otoczki.
Jak stosować: Mierz koszt całego przepływu pracy razem z ludzkimi godzinami, nie samego wywołania API. Dopiero wtedy porównanie rok do roku ma sens.
Na co uważać: Teza „rok temu rozwiązywałem to za 10 centów i nadal tyle płacę” zwykle pomija, że współczesny model wykonał przy okazji pracę, którą wcześniej robił człowiek.
7.Wysycone benchmarki to argument za nowymi testami, nie przeciwko tanieniu
Na czym polega: Stare benchmarki przestały rozróżniać modele, bo tanie modele je „nasyciły”. To nie dowód, że pomiary kłamią, tylko że potrzebujemy trudniejszych i nowszych testów.
Jak stosować: Do decyzji zakupowych używaj własnych zadań produkcyjnych — mały, firmowy benchmark na realnych problemach powie więcej niż publiczny indeks.
Na co uważać: „Benchmarki są niewiarygodne” bywa wymówką do odrzucenia niewygodnych danych o spadku cen — zwłaszcza gdy padaje z ust kogoś, kto chwilę wcześniej sam na benchmarkach się powoływał.
8.Wiralowe liczby weryfikuj u modelu, zanim je udostępnisz
Na czym polega: Nawet najprostszy dzisiejszy model potrafi wykryć, że wyliczenie „132 mln dol. rocznie” opiera się na błędnej stawce i pomija rabaty oraz strukturę tokenów.
Jak stosować: Zobaczyłeś pewny siebie wpis z liczbami? Zrób zrzut ekranu, wrzuć do Claude’a albo Codexa i poproś o sprawdzenie rachunku oraz ukrytych założeń. Dwie minuty pracy.
Na co uważać: Najniebezpieczniejsze są wpisy „racjonalnie brzmiące”, bez żadnych liczb — ton pewności łatwo pomylić z kompetencją.
9.Kto atakuje motywacje zamiast argumentów, nie jest źródłem informacji
Na czym polega: Zamiast odnosić się do danych, niektórzy odpowiadają: „laby ci płacą”, „to marketing”, „chcą to znormalizować”. Nigdy nie padnie „masz rację” — padnie cokolwiek innego.
Jak stosować: Oceniaj komentatorów po tym, czy odpowiadają na merytoryczne zarzuty. Sam trzymaj się faktów i publicznie przyznawaj się do błędów — to buduje wiarygodność szybciej niż nieomylność.
Na co uważać: Uprzejmy, spokojny ton nie jest dowodem racji — można być miłym i kompletnie się mylić, a jednocześnie wyglądać na równego rozmówcy, który słusznie się unosi.
10.Budżet tokenowy licz łącznie: produkt, badania, marketing
Na czym polega: Wydatki Lauren — rzędu 15–50 tys. dol. miesięcznie według szacunków — kupują jednocześnie ulepszenia dwóch produktów, badania nad granicami pracy agentowej i zasięgi, o jakie firmy próbują w eventach za ponad milion dolarów.
Jak stosować: W firmie oceniaj wydatki na tokeny razem z wartością: PR-u i poprawek, przyspieszenia prac inżynierskich, informacji zwrotnej z produktu oraz efektu wizerunkowego.
Na co uważać: Nie każda tak uzasadniona inwestycja się broni — najpierw sprawdź, czy tokeny faktycznie przekładają się na rezultaty, a nie tylko na licznik na profilu.
Redakcyjne tłumaczenie
Skąd się wzięło 132 miliony
Zapewne słyszeliście już o Lauren, znanej też jako Potato, twórczyni P-stacka. Na koncie ma sporo innych świetnych rzeczy, jak React Compiler. Uważam, że jest znakomita. Niedawno przeszła z Mety do Cursora i błyskawicznie zrobiła furorę w świecie agentowego programowania, bo pracuje na własnych zasadach. Dziś rano, gdy zaglądem na X, trafiłem na wpis, który bierze na celownik Lauren i ludzi jej pokroju za rzekome marnowanie 132 milionów dolarów rocznie na tokeny.
Sto trzydzieści dwa miliony dolarów. Rocznie. Nie wiem, jak u was, ale sam sporo siedzę w Cursorze i nie powiedziałbym, że postępy aplikacji z ostatnich miesięcy są warte aż tyle. Chyba że ktoś wycenia GPU w czterdzieści kilka milionów sztuka — bo właśnie tyle ich za takie pieniądze można by kupić. To bardzo dużo kasy. Wszystkie dane pochodzą z profilu Lauren na stronie Cursora: w ostatnich 30 dniach zużyła 1,5 biliona tokenów. Tak, biliona, nie miliarda. Ja też bynajmniej nie żałuję tokenów i nawet mi się nie zbliżyć do 100 miliardów. Skoro tak, to jakim cudem ona zużywa piętnaście razy więcej niż ktoś, kto wręcz próbuje je przepalać? I co właściwie robi z tokenami rzekomo wartymi 132 miliony dolarów? Może te liczby są zmyślone? Może wdrażają rzeczy, o których nie wiemy? Może robi to dla memów? Co tu się dzieje?
Jak się domyślacie, mam na ten temat sporo do powiedzenia — i zapewne przewidzieliście, że większość tych liczb kompletnie się nie klei. Nie twierdzę przy tym, że skala jej zużycia nie jest szalona, bo jest. Ale to, co Lauren robi, jest o wiele bardziej pionierskie, niż Twitter jej uznaje. A ponieważ za pracę uznaję prostowanie takich dezinformacji, trzeba was przeciągnąć przez kolejne wyjaśnienie, jak naprawdę wydają tokeny OpenAI, Anthropic, Cursor, xAI, Meta i cała ta brać maksująca liczniki — oraz dokąd to zmierza. Muszę też wyjaśnić, dlaczego to, co napisał tu Zeeg — że ludzie pracujący w labach nie pojmują, jak ktokolwiek może tyle wydawać na tokeny — jest naprawdę głupim wpisem.
Przerwa na sponsora: Depot
Zanim przejdziemy do rzeczy głupich i złych — coś świetnego, czyli dzisiejszy sponsor. Nie wiem, jak u was, ale ja ostatnio odpalam znacznie więcej agentów, a to pociąga za sobą sporo dodatkowego tarcia: więcej buildów, więcej czekania na CI, więcej ograniczeń przez procesor, RAM i łącze. Przynajmniej dopóki nie przeniosłem tej roboty do Depot. Chłopaki z Depot są od przyspieszania agentom i całym przepływom deweloperskim. Wszystko, co zbudowali, było już użyteczne dla programistów chcących szybko dowozić zmiany, ale z agentami, którzy uderzają w te same wąskie gardła, robi się to o niebo przydatniejsze. Kiedy sami czekaliście na CI, spowalniało was to trochę. Gdy agenci składają dziesiątki pull requestów dziennie, liczy się każda sekunda — a oni nie odzyskają wam sekund, tylko godziny, o ile nie więcej. Można ich użyć jako bezproblemowego zamiennika GitHub Actions, ale robi się naprawdę ciekawie, gdy przejdziecie na ich pipeline’y CI — co, zgadnijcie, wasze agenty ogarną bez mrugnięcia. To pozwala zrównoleglić pracę i więcej jej współdzielić, więc agenci testują swój kod dużo, dużo szybciej.
Po kolei: Depot CI to w pełni programowalny silnik, którym agenty budują szybszy, zrównoleglony CI; działa bez GitHuba, więc jego awarie was nie dotkną. Przy monorepo mnóstwo daje Depot Cache — współpracują praktycznie ze wszystkimi narzędziami: TurboRepo i Nx w TypeScripcie, Bazel czy Gradle gdzie indziej. Jeśli używacie Dockera, mam nadzieję, że Depot już macie, bo ich cache — współdzielony między tobą, zespołem i CI — sprawia, że szansa na budowę obrazu od zera jest bliska zeru, a buildy przyspieszają do dziesięciokrotnie. Wszystko trafia do rejestru Depot, który ogarnia obrazy i artefakty potrzebne wam i waszym agentom. A jeśli chcecie iść na całego, wypuścili właśnie Depot Code: serwer Gita bez dysków, trzymający wszystko w blob storage — szybciej i bliżej waszego CI, więc kroki, które trwały minuty, zaczynają trwać sekundy. Użytkownicy raportują buildy i CI szybsze 10–20 razy. Link w opisie: soydev.link/depot.
Prawdziwa lekcja tego materiału
Gdybyście poprosili swojego agenta o streszczenie tego filmu, powiedziałby pewnie coś w stylu: „Theo wskazuje błędy w wyliczeniach Petera i pokazuje, że modele będą z czasem tanieć”. I mniej więcej to jest plan. Subtelniejsza lekcja, którą chcę wam zostawić, dotyczy czegoś innego: rozpoznawania osób, które w przestrzeni dev-AI mówią rzeczy brzmiące mądrze i rozsądnie, a przy konfrontacji z liczbami okazują się całkowicie w błędzie. Szczególnie frustrują mnie ludzie, którzy z wielką ochotą publikują wielkie, napompowane, nieprawdziwe wyliczenia, bo chcą ponarzekać — i chcę was nauczyć ich omijać. Bo mnóstwo osób dało się nabrać na to, co napisał Peter i czym podjął Zeeg. To wszystko jest rażące. Nie żywię Peterowi ani Zeegowi złej woli, ale szczerze uważam, że nie powinniście słuchać niczego, co którykolwiek z nich mówi o AI — bo wyraźnie nie znają się na rzeczy. Zmienię zdanie, jeśli przestaną tak agresywnie kłamać i być uparcie w błędzie w internecie. Ale skoro większość ich wypowiedzi o AI jest faktycznie nieprawdziwa, nie wiem, po co wygrzebywać się głęboko w poszukiwaniu wyjątków.
(Informacja dodatkowa: Zeeg to pseudonim Davida Cramera, założyciela Sentry — znanego narzędzia do monitorowania błędów.)
Demontaż wyliczenia Petera: cztery cenniki tokenów
Przejdźmy więc przez wszystkie błędy rzeczowe. Start: „1,5 biliona tokenów w ostatnich 30 dniach” — prawda. Te pierwsze dwa zdania są prawdziwe. Dalej: „przyjmijmy średnią stawkę 8 dolarów za milion tokenów. Wychodzi 384 tys. dolarów dziennie, czyli 11 milionów w ciągu 30 dni, a rocznie 132 miliony”. Po pierwsze przypomnijcie sobie, że nasza bohaterka pracuje w xAI, więc niemal na pewno jeździ na modelach tańszych niż Opus, Fable czy Astra — sporo pewnie na Groku. Rozbierzmy więc na części te 8 dolarów za milion.
Licznik tokenów z profilu Cursora to liczba zagregowana: 1,5 biliona bez rozbicia na cztery typy — odczyt z cache, zapis do cache, zwykłe wejście i zwykłe wyjście. A każdy z nich wyceniony jest zupełnie inaczej. Model pokroju Opusa 5.5 kosztuje 5 dolarów za milion na wejściu i 25 dolarów za milion na wyjściu; uśrednicie te dwie liczby, wyjdzie wam 12–15 dolarów. I teraz pytanie do was: prawie wyłącznie pracuję na Opusie 5.5. Ile, waszym zdaniem, wynosi mój średni koszt miliona tokenów po zsumowaniu wszystkich typów? Pomyślcie chwilę. Lauren, która dużo korzysta z tańszego Groka, została wyceniona na 8 dolarów za milion. Ile wychodzi mnie? Otóż 41 centów. Peter pomylił się dwudziestokrotnie. Otwiera swój wywód liczbą mylną o półtora rzędu wielkości. Albo ktoś kłamał, albo nie rozumiał, co liczy — a boli to tym bardziej, że Peter to inteligentny człowiek i nie wiem, po co to opublikował. I dopiero się rozkręcamy.
Skąd ta przepaść? Bo odczyt z cache w Opusie nie kosztuje standardowych 5 dolarów za milion, tylko 20 centów. I mimo to około połowa mojego rachunku to właśnie odczyty z cache; druga połowa to zapisy. Tokeny wejściowe i wyjściowe — te, na których Peter oprął całą kalkulację — odpowiadają za mniej niż 8 procent moich wydatków. Uśrednił więc dwie skrajne stawki, które razem odpowiadają za mniej niż jedną dziesiątą kosztów, i uznał, że tyle kosztuje całość. Ale to dopiero początek.
Rabaty, inżynierowie i pytanie o marketing
Peter trochę ratuje sytuację: dobra, zakładamy, że Cursor ma jakąś niewiarygodną umowę z Anthropicem i 90 procent rabatu — to „tylko” 38 tys. dziennie, czyli 1,1 miliona miesięcznie. I porównuje to z kosztami zatrudnienia: te rzekome 13 milionów rocznie na inferencję to podobno 26 inżynierów na poziomie staff po 500 tysięcy dolarów każdego. I tu powiem szczerze, Peterze: nie wiem, ilu inżynierów staff chciałbym zatrudnić bez porządnego budżetu na tokeny, bo szczerze wierzę, że 26 takich ludzi z zerowymi tokenami byłoby wyraźnie mniej produktywnych niż sama Lauren z tokenami bez limitu. Twierdziłbym, że wręcz komicznie mniej.
Potem dorzuca: dobra, może moje wyliczenie jest dziesięciokrotnie zawyżone albo jeżdżą na własnych GPU po 80 centów — i tak wychodzi 100 tys. dolarów miesięcznie. Zauważcie: wliczył w to ogromne rabaty i wciąż wyszło mu dwa razy więcej, niż płacę ja — zwyczajny klient końcowy. Pomyłka totalna. Jedyna prawdziwa teza w całym tym pakiecie to że Cursor ma pewnie faktycznie niewiarygodną stawkę u Anthropic. Cursor należy dziś do xAI, a xAI oddaje Anthropicowi w dzierżawę sporą część mocy obliczeniowej, bo Anthropic potrzebuje GPU bardziej niż xAI. Do tego przez lata zdecydowana większość przychodów Anthropic pochodziła z Cursora. Umowa jest więc niemal na pewno wyjątkowa.
(Informacja dodatkowa: transkrypt notorycznie zapisuje firmę jako „SpaceX AI” — chodzi o xAI, koncern, do którego w opisywanym świecie należy Cursor.)
Gdybym miał strzelać, ile realnie kosztuje to, co robi Lauren — znów: przy uproszczeniu, że w ogóle ma sens rozciągać jedną stawkę na wszystkie typy tokenów, a nie ma, z tysiąca powodów — to górna granica wyszłaby mi raczej 20 centów za milion. Peter mówi: 80 centów, czyli 100 tys. miesięcznie. Ja przy 20 centach wychodzę z 25 tysięcy miesięcznie. I tu mam do was uczciwe pytanie: ile, waszym zdaniem, firmy są w stanie zapłacić za uwagę taką, jaką Lauren przyciąga teraz na X i w całym świecie dev-AI? Podpowiem: znacznie więcej niż 25 tysięcy dolarów miesięcznie. Znam firmy, które organizują eventy odbierające mniej uwagi niż jeden losowy tweet Lauren. Niektóre z tych eventów kosztują ponad milion dolarów — i wyciągają z nich mniej niż z dwóch jej wpisów. A to nawet nie uwzględnia faktu, że przepalane tokeny realnie poprawiają produkty. Cursor w końcu działa: gdy Lauren do nich trafiła, aplikacja rozpadała się na oczy — superwolna, pełna błędów. Jej wejście posprzątało kupę bugów i mocno przyspieszyło całość. A ważniejszy jest Grokbot, szybko robiący się najciekawszym produktem z domu xAI. Lauren składa tysiące pull requestów miesięcznie, nieustannie coś poprawia w obu produktach. A wszystko to kosztuje — przy rozsądnych szacunkach — jakieś 25, w czarnym scenariuszu 50 tysięcy dolarów miesięcznie.
Dwa fakty na dokładkę. Po pierwsze: na tokeny z Anthropic dostają dodatkowy rabat. Po drugie: Lauren robi bardzo długie, głębokie przebiegi agentowe, więc prawdopodobnie trafia w cache jeszcze częściej niż ja. Wszystko razem — nie zdziwiłbym się, gdyby jej realna stawka przybliżała się do 10 centów za milion według tej bezużytecznej zbiorczej liczby, która i tak nie mówi nam niczego. Co w tej samej absurdalnej metodologii dałoby najwyżej 15 tysięcy miesięcznie.
I teraz kilka słów o mojej odpowiedzi, bo mam kilka rzeczy do powiedzenia. Te 132 miliony rocznie, od których Peter zaczął, po prostu nie istnieją. Nawet przy pełnych, dzisiejszych cenach katalogowych czarny scenariusz to raczej 3 miliony rocznie. I to wydaje mi się zawyżone — raczej maksymalnie milion, pewnie koło 800 tysięcy. A jeśli utrzymają się trendy tanienia inferencji, w perspektywie roku cała ta masa tokenów może kosztować 1000 dolarów rocznie. Posłuchajcie.
Trendy efektywności: inteligencja tanieje coraz szybciej
Ostatnie ostrzeżenie przed wybuchem granatu analitycznego — musimy przejść do trendów, konkretnie trendów efektywności.
Ten wykres pokazuje, jak z czasem spada koszt utrzymania danego poziomu inteligencji. Jak można się domyślić, nowe, inteligentne modele debiutują dość drogo. Mierzony jest koszt zadania w indeksie inteligencji Artificial Analysis — czyli ile kosztowało wykonanie przeciętnego zadania testowego. Gdy dwa lata temu wyszedł Sonnet 4.5, był frontierem: pierwszym modelem, który przekroczył 20 punktów w indeksie, po 56 centów za zadanie. Był wrzesień 2025. Rok później ten sam wynik osiągają modele… których nie widzę, bo linia na wykresie akurat się urwała. Właśnie z takich powodów przestałem używać Artificial Analysis do poważnych rzeczy. No dobrze: GPT-6 Luna Low osiąga wynik Sonneta 4.5 niemal rok później za 0,45 centa za zadanie. Z 56 centów do niecałego pół centa — stukrotny spadek w rok. Albo weźmy okolice 30 punktów: Sonnet 4.6 Max pierwszy przekroczył ten próg za 2,50 dolara, a niecały rok później GPT-6 Luna High robi to samo za 3 centy. Z dwóch i pół dolara do trzech centów — prawie stukrotny spadek w jakieś osiem miesięcy. Widzicie, dokąd to zmierza? Inteligencja nie tylko tanieje — tanieje coraz szybciej. Kiedyś zejście o rząd wielkości zajmowało rok. Dziś stukrotny spadek robi się w pół roku.
(Informacja dodatkowa: Artificial Analysis to niezależny serwis porównujący modele AI; jego „indeks inteligencji” agreguje wyniki wielu benchmarków.)
Zeeg i „ludzie z labów tego nie rozumieją”
I tutaj muszę zająć się Zeegiem. Cytuję dosłownie jego odpowiedź Peterowi: „To jest właśnie to, czego ludzie w labach często nie rozumieją. Jak zaczniecie sami płacić za swoje tokeni albo prowadzić firmę, która musi — dopiero wtedy zrozumiecie, jak głupio brzmi to, co mówicie”. Nie. Po prostu nie.
Dla tych, którzy nie śledzą moich ostatnich materiałów: to ten sam człowiek, który pisał, że lepiej trzymać się modeli pokroju GPT-5.6 Soul, Sonneta czy Opusa 5.0, bo oszczędności się opłacają, a te wielkie, najnowocześniejsze modele podobno nigdy nie są warte swojej ceny. Musiałem wtedy nagrywać cały film o tym, dlaczego jednak warto używać najinteligentniejszych modeli. A to jest jego nowa teza — ta, od której wybuchnąłem i poszedłem liczyć.
Odpisałem mu tak: pierwsze komputery kosztowały miliony dolarów. Ja osobiście uważam za całkiem fajne to, że ludzie tacy jak Lauren pchają granice, ignorując koszt. Średnio koszt danego poziomu inteligencji spada około dziesięciokrotnie rok do roku, a ostatnio to się jeszcze przyspiesza — bywa, że o 4,5-krotnie w skali miesiąca. Wyniki powyżej 10 punktów kosztowały w styczniu 2025 26 centów, dziś — 1,5 centa. Modele z wynikami w okolicach 50 punktów, wyceniane przy debiucie na 6 dolarów, dwa i pół miesiąca później mają odpowiednik dwudziestokrotnie tańszy. Rozumiecie, jak szybko to się nakręca? To nie tylko przyspiesza w tym, jak szybko modele się uczą — przyspiesza w tym, jak szybko tanieje ustalony poziom inteligencji.
Na to pada odpowiedź: „Prawda, ale tylko na benchmarkach. W praktyce nie dostajesz netto tańszej inteligencji”. No właśnie dlatego, że lubimy używać tej sprytniejszej. Nie można narzekać, że iPhone’y nie tanieją, skoro odmawiasz kupna zeszłorocznego modelu. Rzeczy tanieją — my po prostu z nich więcej korzystamy. Mój czat słusznie zauważa, że wygląda, jakbyś nawet nie przeczytał, co napisałem. I w drugą stronę można to samo powiedzieć, bo gdy odpisał mi kolejnym wywodem, miałem dość. Nie dałem rady dalej.
„Inteligencja nie tanieje netto” — kontrargumenty
Przykład, który podałem w odpowiedzi: najinteligentniejszym modelem zeszłego roku był GPT-5 High i było to powszechnie przyjęte — może nie cenili go aż tak wysoko jak ja, ale wszyscy zgadzali się, że to najlepszy model tamtego czasu. Tymczasem GLM 5.3 Flash i DeepSeek 4.1 Flash dorównują mu albo go przewyższają we wszystkich benchmarkach. A co ważniejsze — ja wolę je od niego. Nigdy nie wybrałbym GPT-5, O1 ani żadnego modelu z zeszłego roku zamiast GLM 5.3 Flash, bo z tym Flashem po prostu przyjemnie się pracuje. Dobrze znosi długie zadania agentowe: poprosisz o coś — robi; poprosisz o coś innego — robi. Zeszłoroczne modele nie były tylko głupsze. Gorzej się z nimi współpracowało, więc chciało się sięgać po nie rzadziej — i sięgało rzadziej.
W jego wpisie pada też teza, że stare modele są wycofywane, więc rzekomo nie ma „prawdziwych”, regularnych spadków cen. Słucham? Kto miałby w waszych oczach dalej hostować supernieefektywną wersję modelu, kiedy ktoś zbudował już wersję lepszą i tańszą? Że koszt utrzymania infrastruktury nie spada sam z siebie, więc… co? Przepraszam, że tak wybucham. Naprawdę mnie to dobija, gdy miliarderzy-technofile, z którymi jestem po drodze — tacy jak David — są tak rażąco w błędzie. A najgorsze jest to, że większość jego zdań nie jest wprost nieprawdziwych. Ale ani jedno nie jest istotne. Dobrze się złożyło, że nie obejrzał mojego ostatniego materiału o jego wypowiedziach, bo nie rozmawiałby ze mną potem tak uprzejmie. Choć najbardziej boli mnie to, że jego wpis zebrał prawie tyle polubień co mój.
Powodem, dla którego tu wybucham, nie jest to, że David mówi głupoty — tylko że ludzie chcą go słuchać i wierzyć. Słyszą te bzdury i kiwają głowami: „no, brzmi sensownie”. A nie brzmi. To po prostu nieprawda. Jeśli jesteś jedną z tych siedemnastu osób, to jesteś po prostu źle poinformowany — i to nie jest zarzut, po to tu jesteś; jeśli lajkujesz takie wpisy i oglądasz moje materiały, to najwyraźniej próbujesz to zrozumieć i szanuję cię za to. Ale niemal wszyscy pozostali kliknęli, bo nie chcą uznać, dokąd zmierzamy. Wolą mówić: AI zostanie na zawsze superdrogie, nie ma to sensu, trzeba używać tańszych modeli, trzeba samemu pisać kod. I lajkują rzeczy nieprawdziwe, bo poprawiają im nastrój.
A będzie tylko „gorzej”. Bo 4.1 Flash i 5.3 Flash — odpowiednio DeepSeeka i GLM-a — nie tylko są przyjemniejsze w użyciu, są też komicznie tańsze. Policzylem to, bo ktoś narzekał, że modele nie tanieją, a chciałem wiedzieć, jak bardzo się myli. Porównałem surowe ceny tokenów GPT-5 z V4 Flash — to jeszcze nie było nawet 4.1 Flash — a docelowo z GLM 5.3. Wejście: dwadzieścia jeden razy taniej. Wyjście: pięćdziesiąt pięć razy taniej. Nawet jeśli założymy trzykrotny wzrost liczby tokenów, netto wychodzi dwudziestokrotna oszczędność. Wskazałem też, że GLM 5.3 Flash jest przyjemniejszy w użyciu i 29 razy tańszy od GPT-5 w przebiegach testowych.
Benchmarki, sprzeczności i „10 centów, które rzekomo się nie zmieniają”
Na to odpowiedź: „Dostajesz lepszą inteligencję za podobny koszt, a nie tańszą inteligencję ogólnie”. I dalej: „Stare stawki znikają, bo nie ma infrastruktury do ich obsługi albo nie pokrywa kosztów. A te dziesięciokrotnie lepsze liczby to tylko benchmarki — które, jak wszyscy wiemy, są niewiarygodne”. Zgadzę się, że benchmarki nie są już szczególnie wiarygodne, ale nie z powodu, który on sugeruje. One są po prostu albo wysycone, albo głupie. Wiecie, dlaczego kiedyś je lubiliśmy? Bo zeszłoroczne modele nie były dość inteligentne, żeby je nasycić — więc bardzo dużo mówiły. To, że dziś tanie modele saturują testy, nad którymi roczne modele się męczyły, nie znaczy, że test jest zły. Znaczy, że potrzebujemy lepszych, nowszych benchmarków. A potem pada zdanie, że jednoprogresywny zysk to rzekomo „dziesięciokrotna poprawa”. Dzięki, S. Johnie. Próbowałem być wyrozumiały, ale twierdzenie, że „więcej inteligencji za ten sam koszt” nie oznacza, iż „ta sama inteligencja jest tańsza”, to naprawdę szaleństwo. On się sam sobie zaprzecza. I właśnie o to chodzi: dla doomerów negujących dev-AI sprzeczności nie mają znaczenia. Fakty nie mają znaczenia. Liczby nie mają znaczenia. Użycie nie ma znaczenia. Postęp nie ma znaczenia. Liczą się wyłącznie słowa pasujące do ich przekonań. Więc jeśli ktoś napisze wywód — choćby wygenerowany na kolanie przez AI — a nagłówek poprawi im humor, chętnie podadzą go dalej światu.
Jego kolejny zarzut: „Nie mówię, że nie tanieje, ale ludzie cytujący te liczby nie uwzględniają praktycznego tempa poprawy i kosztów AI w zastosowaniach. Jeśli miałem problem, który model umiał rozwiązać rok temu za 10 centów, to pewnie nadal płacę podobnie. I nie stało się trzydzieści razy taniej. Są też problemy, z którymi modele wciąż się męczą — one nie stały się trzydzieści razy bardziej niezawodne. Liczby nie przekładają się na rezultaty”.
To być może najgorszy fragment. Ostatnio zrobiłem zabawny eksperyment: podpiąłem GPT-4o pod OpenCode, żeby zaktualizował stronę. Nie ogarnął wywoływania narzędzi. Wypluł zepsuty HTML do logu rozmowy i przestał odpowiadać, bo nie wiedział, co zrobić z historią. Uważam, że każdy model wydany w tym roku ma co najmniej trzydzieści razy większą szansę rozwiązać zadanie w środowisku narzędziowym niż coś w stylu 4o. Szczerze myślę, że takich ludzi trzeba by zmusić do pracy na modelu sprzed roku, żeby pamiętali, jak było źle. GPT-6 Luna jest sto razy tańszy od GPT-5 i obiektywnie inteligentniejszy oraz lepszy pod każdym względem, jaki przychodzi mi do głowy. GPT-6.1 Soul jest dziesięć razy inteligentniejszy od GPT-5 — i wciąż tańszy niż piątka była. „Mój problem za 10 centów kosztuje nadal” — powiedziałem wprost: to nieprawda. Tyle samo kosztowałby tylko pod warunkiem, że pozwolilibyście współczesnemu modelowi robić więcej niż kiedyś — najpewniej tę pracę, którą wcześniej wykonywaliście ręcznie, jak odpalanie serwera deweloperskiego i sprawdzanie efektu w przeglądarce.
Przyznam się tu do własnej wpadki. Pamiętam, jak wyśmiewałem Windsurf za dodanie modelowi możliwości uruchamiania komend. Mówiłem: „to tryb dla zupełnych początkujących, dla ludzi, którzy nie umieją odpalić komendy deweloperskiej; po co mi to, skoro mogę wskazać agentowi plik i edytować go przez Command K?”. Nie rozumiałem, po co prosić model o uruchomienie komendy, skoro można ją po prostu uruchomić samemu. Strasznie się myliłem. Nie widziałem przyszłości, w której modele używają narzędzi i powłoki, żeby wykonywać swoją pracę. On najwyraźniej o tamtych czasach zapomniał — choć nie były wcale odległe.
Skate Bench: co da porównanie o rok–dwa wstecz
Wyzwał mnie, żebym znalazł zadanie sprzed trzech lat, które modele wykonywały równie dokładnie jak dziś. Rzucam pytanie na czat: podacie jakieś zadanie, które modele sprzed trzech lat robiły bezbłędnie? „Brzydkie aplikacje todo”? Trzy lata temu? Nie — żaden model nie budował wtedy aplikacji todo od zera. Tak przywykliśmy do tego, co AI potrafi dziś, że nie umiemy sobie przypomnieć, co potrafiło trzy lata temu. Można było przygotować środowisko, podać główny plik i kazać wprowadzać zmiany — ale nie dało się po prostu powiedzieć „zrób brzydką apkę todo”. Trzeba było wszystko ustawić za model, a potem pozwolić mu edytować plik. Nawet słynnej „aplikacji todo z GPT-2” nie było.
Komuś na czacie udał się lepszy przykład: Skate Bench. Szczerze mówiąc, to nie jest idealny przykład — polega na wymyślaniu przez modele nazw trików skateboardowych i ma swoje wzloty oraz upadki — ale policzyłem go, bo taki już jestem. Odpaliłem Skate Bench na O1. Dla niepamiętających: O1 to pierwszy w historii model rozumujący. OpenAI odkryło wtedy, że pozwolenie modelowi „pokręcić się w kółko” przed odpowiedzią podnosi jej jakość. Model wyszedł w grudniu 2024. Kosztował 15 dolarów za milion na wejściu i 60 na wyjściu — drożej niż Fable. Odczyt z cache był zaledwie o połowę tańszy: 7,50 dolara za milion, podczas gdy dziś normą jest 90–95 procent zniżki, nie pięćdziesiąt. Przy dzisiejszych standardach było by to więc najwyżej półtora dolara za milion w czarnym scenariuszu. I nie zaczynajmy o O1 Pro, który kosztował 150 dolarów za milion wejścia i 600 za milion wyjścia. Mogłem go zmiażdżyć wersją Pro, ale wziąłem zwykłe O1.
Wynik: 67,7 proc. skuteczności i 12 centów za zadanie. Dokładnie rok później — a jest to de facto dziś, bo O1 wyszedł 17 grudnia 2024, a Gemini 3 Flash 17 grudnia 2025 — model osiąga wyższy wynik nie za jedną dziesiątą, ale prawie jedną setną ceny: 58 razy taniej rok do roku. I tu zrozumiałem, że sam się myliłem — sądziłem, że to stabilne 10x. Nie jest. To bliisko stukrotnego spadku rok do roku przy danym poziomie inteligencji. Kazałem agentom liczyć dalej: co najtańszego daje zbliżony wynik? GLM 5.3 Flash — zabawne, że znowu on — uzyskał 70,8 proc., czyli więcej niż O1, po 0,016 dolara za zadanie, czyli 0,00016 dolara na pytanie. Sześćset osiemdziesiąt razy taniej w niecałe dwa lata. Jak inteligencja ma nie tanieć? Nie tylko tanieje — tanieje coraz szybciej. Kto twierdzi inaczej, po prostu się myli, przepraszam. Liczby mówią same za siebie. A ja też się pomyliłem, i to mocno: wierzyłem, że będzie sufit, jeśli chodzi o inteligencję modeli, i podłoga, jeśli chodzi o cenę. Nie mogłem bardziej się nie mylić. W tym tempie dojdziemy do punktu, w którym komputer, na którym odpalacie agentów — nie ten, gdzie liczy inferencja, tylko maszyna wirtualna, na której agent woła basha — będzie droższy od samej inferencji.
Wracając do Zeega: „Tak, inteligencja tanieje, ale w praktyce nie znaczy to, że zadania tanieją w tym samym tempie, bo pomiary w benchmarkach nie przekładają się na realne rezultaty”. Różnica jest taka: jeśli zadaniem było „napraw tego buga”, to kiedyś testowałeś aplikację, znajdowałeś błąd, szedłeś do pliku w kodzie, otwierałeś go, zaznaczałeś właściwe miejsce, klikałeś Command K, kazałeś Sonnetowi 3.5 poprawić kod, sam zapisywałeś plik, sam restartowałeś serwer deweloperski, otwierałeś przeglądarkę i sprawdzałeś, czy działa. Dziś to samo zadanie to wrzucenie modelowi zrzutu ekranu z błędem i jednego słowa: „napraw”. Tak, w takim ujęciu zadanie nie staniało — ale ja już nie wykonuję tej roboty. Zamknięcie zgłoszenia w Jirze kosztuje tyle samo, tylko że tym razem nie ja odrobiłem pracę. Gdybym dalej używał Cursora po staremu — zaznaczanie tekstu i instrukcje — byłoby pewnie taniej. Ale żyjemy w prawdziwym świecie, w którym aplikacje starają się zdjąć z człowieka inżynierski wysiłek, i nikt już tak nie pracuje.
I tu osiągnąłem poziom frustracji, przy którym zrozumiałem, że muszę nagrać film. On podał horyzont trzech lat, co uznałem za szaleństwo — nikt nie powinien porównywać do stanu sprzed trzech lat. Wziąłem więc dwa. Trzy lata temu nie było modeli rozumujących. Wywołania narzędzi nie istniały. Porównywanie w tej skali nie miało sensu, bo zadania modeli sprowadzały się do marnej autokomplety. O1 wyszło w grudniu 2024, ceny podałem wyżej. Naprawdę miałem trudność ze znalezieniem zadań ze świata rzeczywistego, które O1 potrafi ukończyć — wybrałem więc nazywanie trików deskorolkowych. Koszt: około 11 centów na pytanie. Flash z grudnia zeszłego roku osiągnął wyższy wynik za 0,2 centa na pytanie. Nie wiem, z czym się tu jeszcze wykłócasz, człowieku. To jest oczywiste. Spróbuj zrobić w O1 jakąkolwiek prawdziwą pracę z kodem, potem przesiądź się na GLM 5.3 Flash i powiedz mi szczerze, który wolisz. Wolisz ten, który jest ponad dziesięciokrotnie tańszy.
Dlaczego w ogóle o tym mówię
I najtrudniejsza część: David bardzo starannie dobrał słowa, żeby samemu nie brzmieć gniewnie ani wzburzone, a jednocześnie tak mnie sprowokować, żebym ja zabrzmiał. To fatalne, bo wygląda jak starcie dwóch równych — jedna strona zachowuje się jak burak, druga jest uprzejma, tylko że kompletnie się myli. Musicie zrozumieć: to nie jest przypadek typu „każdy ma swoje zdanie”. To nie są dwa ujęcia tej samej sprawy. To jest ktoś, kto wkłada w to zdecydowanie za dużo czasu i energii. Śmiejcie się ze mnie, ile wlecie, że jestem przesadnie w to wciągnięty — ale znam się na tym. Dużo z tymi modelami pracuję. Zbudowałem masę benchmarków. Obsesyjnie to oceniam. Mam terabajt własnej historii rozmów z modelami w bazie ClickHouse postawionej w mojej domowej sieci, żeby to wszystko audytować.
Doceniam was, bo kiedy po południu przerabiałem tę wymianę, czułem się, jakbym zgubił kontakt z rzeczywistością. Zakończyłem słowami: „Nie rozumiem, z czym się mnie czepiasz. To jest oczywiście prawda. Gdybyście zrobili tymi modelami jakąkolwiek prawdziwą pracę z kodem, byście rozumieli”. Na to padła odpowiedź: „No dobrze. Możemy się zgodzić, że sugerowanie, jakoby inteligencja taniała dziesięciokrotnie rocznie, jest głupim stwierdzeniem. Możesz wykonać to samo ćwiczenie na benchmarkach — i nie znajdziesz podobnej różnicy cen w zastosowaniach praktycznych. Przykro mi, że tak się stawiam. Wiem, że jesteś bystry i ogromnie cię szanuję, więc tym bardziej dezorientuje mnie ta twoja teza”. A przecież rok temu przepływ pracy wyglądał tak: zaznacz tekst w edytorze, Command K, czytaj kod ręcznie. Dziś przepływ wygląda tak: „Hej Claude, chcę zrobić X. Ogarnij”. Poprosiłem go o listę prawdziwych zadań, do których używał AI przed dwunastoma miesiącami — zbudowałbym z nich benchmark i pokazał, że faktycznie jest dziesięć razy taniej. Odpowiedział kolejnymi esejami. Tak, jestem zirytowany.
Mój problem nie polega na tym, że część ludzi mówi o tym głupoty. Mój problem polega na tym, że te głupoty regularnie zdobywają ogromne zasięgi, bo ludzie chcą wierzyć. Chcą ignorować AI i powtarzać: „to są laby marnujące tokeny, bo mogą, i próbujące naciągnąć nas wszystkich na przepalanie kasy”. Nie. To tanieje do punktu, w którym laboratoria błyskawicznie tracą marże. Jeśli nie cierpicie OpenAI i Anthropic, powinniście być tu razem ze mną. Powinniście krzyczeć głośniej niż ja o tym, jak szybko tanieje inferencja i jak OpenAI z Anthropicem zostaną bez marży, gdy wszystko spadnie na samo dno.
Ile to będzie kosztować jutro
W mojej wersji liczb jej zużycie wyceniłem na jakieś 100 tysięcy dolarów miesięcznie. Po zaledwie kilku miesiącach dalszych ulepszeń — gdyby zamiast sięgać po coraz inteligentniejsze modele trzymała się równoważnych, tańszych — koszt mógłby spaść do 3 tysięcy. A jeśli trendy się utrzymają, do 100 dolarów miesięcznie za rok. Ale tego nie zrobimy, bo ciągnie nas zawsze coś mocniejszego. Chcemy używać najinteligentniejszych modeli, ulepszać przepływy pracy, rozwiązywać zadania inaczej — z mniejszym udziałem człowieka — albo brać się za problemy trudniejsze, wcześniej niemożliwe.
I ostatnia rzecz: nikt nie twierdzi, że to normalne. Widziałem sporo osób powtarzających, że ludzie pokroju Lauren próbują „znormalizować” wydawanie milionów dolarów miesięcznie na tokeny. Nie próbują. Lauren nie udaje przeciętnego człowieka. Jest bardzo nietypowa — dziwną, jedyną w swoim rodzaju jednostką — i właśnie dlatego zawsze wydawała mi się fascynująca. To fenomenalna inżynierka. I dobrze, że nikt teraz nie kwestionuje jej kompetencji, bo wybuchnąłbym tak, że cancel spadłby na mnie do końca życia. To jedna z najlepszych inżynerek, jakie znam — i to na długo przed tą całą erą AI. Okazało się, że jest też znakomita w inżynierii agentowej; powiedziałbym, że należy do ścisłego czubka — ułamka promila — inżynierów agentowych. Mierzenie jej pracy jako „dolarów włożonych w oprogramowanie” jest redukcyjne i błędne. Jej wydatki trzeba widzieć łącznie: produkt i inżynieria, badania, praca etatowa nad P-stackiem, marketing, badania produktowe i ulepszanie. Czy to warte 350 tysięcy dolarów dziennie? Raczej nie. Czy warte milion–dwa miesięcznie? Bez dyskusji. Tyle to nie kosztuje — ale gdyby naprawdę chciała wydawać dwa–trzy miliony miesięcznie, na miejscu CEO Cursora nie zastanawiałbym się ani sekundy. Zapytałbym, czy nie chce więcej. Lauren bada bowiem, co się stanie, gdy zignoruje się koszt inteligencji. Nie robi tego po to, żeby Cursor zakładał, iż każda firma wyda 10 milionów rocznie na tokeny. Robi to po to, że te 10 milionów w tokenach za rok–dwa będzie kosztować 10 tysięcy.
I oczywiście Lauren sama się odezwała: stara się być maksymalnie wymagającą użytkowniczką Grokbota i Cursora właśnie po to, żeby dawać dobrą informację zwrotną, wprowadzać zmiany i poprawiać doświadczenie zwykłych użytkowników. Widziałem to na żywo we wspólnych Slackach i wiadomościach prywatnych. Lauren to w przestrzeni pełnej ludzi, którzy sami przyznają, że nie wiedzą, co robią, rzadki ptak. Skoro tylu inżynierów agentowych po prostu sypie tokenami w rzeczy, których nie rozumie, rozumiem chęć krytykowania takich osób. Lauren do nich nie należy. Jeśli chcecie kogoś zaatakować za marnowanie tokenów — mnie. Jestem znacznie wygodniejszym celem. Przepalam pół miliona na tokenach przy przepisywaniu Typecriptu, czysto dla zabawy. Lauren faktycznie przesuwa granice. Kierujcie frustrację na tych, którzy na nią zasłużyli — na przykład na mnie — a pozwólcie Lauren wymyślać przyszłość, bo po to tu jest.
Jak nie dać się nabrać na liczby
I proszę, na miłość boską: kiedy widzicie ludzi podających liczby ewidentnie błędne — albo tylko podejrzanie wyglądające — zróbcie zrzut ekranu, wrzućcie go Claude’owi albo Codexowi i poproście o weryfikację. Nawet najgłupsze dzisiejsze modele pewnie wytłumaczą wam, że żadna z liczb krążących w tej sprawie nie ma sensu. A prawdziwa lekcja, którą chcę wam zostawić, to umiejętność zauważania ludzi podszywających się pod analityków, którym bardziej zależy na rozpaleniu emocji niż na przekazaniu informacji.
I jeszcze jedno: obserwujcie, kiedy ktoś atakuje motywacje rozmówcy zamiast próbować zrozumieć, co mówi. Ja robię wszystko, żeby samemu tego nie robić. Obchodzi mnie informacja, a kiedy bywam dla kogoś ostry, to nie dlatego, że podejrzewam, iż ktoś go opłacił — mówię po prostu, że to, co powiedział, jest głupie. Ludzie, przed którymi was ostrzegam, robią odwrotnie. Nigdy nie odnoszą się do argumentów. Omijają je i mówią co innego: „no tak, laby ci płacą”, „to marketing”, „próbują to znormalizować”, „używają benchmarków, żeby liczby wyglądały lepiej”. Powiedzą cokolwiek, byle nie: „masz rację”. To nie są dobre źródła informacji.
I przykro mi, że muszę ciągnąć te granice, ale doszło do punktu, w którym muszę publicznie wytknąć sprawę dobremu znajomemu, Davidowi Cramerowi, i powiedzieć: nie słuchajcie niczego, co mówi o AI — choć dwa tygodnie temu zasiadałem z nim w panelu o tej tematyce. Bo szczerze uważam, że sposób, w jaki o tych sprawach mówi, realnie szkodzi branży, w której działamy. Jeśli nie możemy rozmawiać o faktach, nie mamy o czym rozmawiać. A niestety ten poziom błędów rzeczowych zdegradował dyskusję do poziomu podłogi. Zeeg — czyli Cramer, założyciel Sentry, od dłuższego czasu także sponsor tego kanału i mój dobry znajomy — oraz Peter, z którym na początku nie mogliśmy się znieść, a dziś jest między nami porządek i jesteśmy w miarę po drodze. Nienawidzę wytykać znajomych. Wytykam ich właśnie dlatego, że gorzej byłoby robić to głupszym ludziom — a wiem, że Zeeg i Peter są dość inteligentni, żeby posłuchać i przestać to robić. Nienawidzę materiałów-dram, naprawdę. Celowo wybieram ludzi, których znam, którym ufam i z którymi jestem po drodze, bo myślę, że realnie mogą to u siebie naprawić. Ale dopóki publicznie nie przyznają, jak bardzo się mylili — tak jak ja robię to od zawsze. Ile razy żartowałem z tego, że strasznie myliłem się co do sufitu inteligencji? Że nie pojąłem, jak potężna okaże się windsurfowa idea pozwalania agentowi na uruchamianie komend? Że sądziłem, iż przestanie tanieć, a tymczasem tanieje coraz bardziej i coraz szybciej? Że nie wierzyłem, że Anthropic ogarnie uczenie ze wzmocnieniem — a dziś mają najlepsze modele RL na świecie? Myliłem się wiele razy i chętnie będę o tym krzyczeć publicznie, bo zależy mi, żebyście dostali ode mnie rzetelne informacje. I jestem pewien, że sekcja komentarzy właśnie to potwierdzi.
Boję się zobaczyć ten materiał po publikacji, ale powiedziałem, co miałem do powiedzenia. Mam nadzieję, że teraz lepiej rozumiecie te mechanizmy i że macie w zanadrzu kilka sygnałów pozwalających rozpoznać ludzi, którzy w internecie_grubo_ się mylą. Idę zająć się czymkolwiek innym. Do następnego razu — trzymajcie się, nerdzi.