O czym jest ten film
- Problem: typowa organizacja utrzymuje kilkadziesiąt repozytoriów (sklep, API płatności, panel administracyjny…), a agent musi często działać w kilku z nich jednocześnie.
- Standardowe rozwiązania zawodzą: duplikowanie skillów i konfiguracji w każdym repo wymaga wiecznej synchronizacji, a katalog użytkownika jest niewidoczny i szybko się dezaktualizuje.
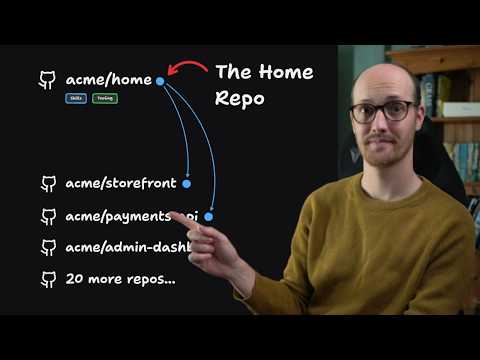
- Proponowane rozwiązanie to tzw. home repo — jedno repozytorium, w którym mieszkają wszystkie skille, pliki sterujące, wiki i własne narzędzia.
- Agent zawsze startuje w tym centralnym repozytorium i stamtąd sięga do wszystkich pozostałych, sprowadzając potrzebny kontekst.
- Nawigacja do innych repo to zwykłe ścieżki wpisane w AGENTS.md/CLAUDE.md — nic więcej.
- Na świeżym komputerze agent sam klonuje brakujące repozytoria, a równoległe sesje obsługują drzewa robocze (git worktree).
- Układ spokojnie obsłuży 20–40 repozytoriów; przy setkach Matt zaleca stopniowe odsłanianie treści — grupowanie repo w sekcje.
- Monorepo byłoby idealne, ale często jest niewykonalne (mieszanka repo publicznych i prywatnych, polityka firmy) — wtedy home repo jest właściwą odpowiedzią.
- Repozytorium domowe pozwala śmielej rozbudowywać narzędzia: integracje z Gmailem, Slackiem, Discordem, YouTubem, GitHubem czy Kalendarzem Google rosną w jednym miejscu.
- Matt udostępnia artykuł z gotowym promptem, który przeprowadza przez wdrożenie wzorca we własnym środowisku.
10 najważniejszych takeaways — z kontekstem zastosowania
1.Agent zawsze startuje w repozytorium domowym
Na czym polega: Zamiast uruchamiać sesje w poszczególnych repozytoriach, tworzysz jedno centralne — z\Plugin skillami, plikami sterującymi i narzędziami — i to w nim zawsze odpalasz agenta. Stamtąd sięga on do wszystkich pozostałych repo.
Jak stosować: Załóż puste repozytorium, przenieś do niego skille, konfigurację i instrukcje, a w pliku AGENTS.md wskaż ścieżki do repozytoriów roboczych. Każdą nową sesję agenta zaczynaj właśnie tam.
Na co uważać: Zmienia się nawyk pracy — łatwo „zapomnieć” i odpalić agenta w starym katalogu; warto na początku zrobić alias lub wrapper, który zawsze startuje w właściwym miejscu.
2.Koniec z duplikowaniem skillów między repozytoriami
Na czym polega: Tradycyjne kopiowanie skillów, narzędzi i plików sterujących do każdego repo oznacza ręczne utrzymywanie trzydziestu czy czterdziestu kopii w zgodzie — to najczęstsza przyczyna porażki w środowiskach wielorepozytoryjnych.
Jak stosować: Skille trzymaj wyłącznie w repozytorium domowym. Wtedy każda edycja rozchodzi się natychmiast na wszystkie sesje, a ustawienia z settings.json obejmują całą organizację za jednym zamachem.
Na co uważać: Migracja istniejących, rozproszonych skillów do centrali wymaga porządku — zrób inwentaryzację, zanim zaczniesz przenosić, żeby nie zgubić lokalnych wariantów, które ktoś po cichu zmodyfikował.
3.Katalog użytkownika to nie miejsce na standardy zespołu
Na czym polega: Umieszczenie wspólnych skillów w katalogu domowym użytkownika wydaje się wygodne (dostęp z każdego repo), ale takie pliki są niewidoczne — nikt ich nie aktualizuje i szybko zaczynają odstawać od wersji zespołowej. Poza tym katalog użytkownika powinien zostać przestrzenią na osobiste preferencje, a nie na narzucony standard.
Jak stosować: To, co zespołowe i wersjonowane — do repo; to, co osobiste (skróty, indywidualne upodobania) — może zostać u użytkownika.
Na co uważać: Nie przenoś na siłę wszystkiego do centrali — wyraźnie oddziel konfigurację osobistą od zespołowej, inaczej ludzie zaczną omijać wzorzec.
4.Ścieżka w AGENTS.md wystarcza jako nawigacja
Na czym polega: Powiązanie repozytorium domowego z resztą projektu nie wymaga żadnej infrastruktury — wystarczy zwykła ścieżka do danego repo wpisana w pliku z instrukcjami.
Jak stosować: Prowadź w AGENTS.md listę repozytoriów, których dotykacie na co dzień, wraz z krótkim opisem, do czego każde służy. Dopisanie nowego repo to jedna edycja pliku.
Na co uważać: Lista szybko się starzeje — jeśli repo zmieni nazwę albo zostanie zarchiwizowane, zmyłka na ścieżce będzie kosztować agentowi czas; przeglądaj wpisy przy okazji większych porządków.
5.Świeża maszyna? Agent sam klonuje i zakłada drzewa robocze
Na czym polega: Na nowym komputerze agent sprawdza, czy wskazane repozytorium istnieje pod daną ścieżką — jeśli nie, sam je klonuje. Gdy równolegle pracuje kilka agentów, każdy dostaje własne drzewo robocze (git worktree) w obrębie tego samego repo, więc nie wchodzą sobie w drogę.
Jak stosować: Opisz ten mechanizm w instrukcjach: „jeśli repo nie istnieje, sklonuj; jeśli pracujesz równolegle z innym agentem, użyj worktree”. W praktyce daje to konfigurację bez konfigurowania.
Na co uważać: Drzewa robocze zostawiają ślady — od czasu do czasu trzeba je po sobie sprzątać, inaczej katalog zacznie puchnąć.
6.Przy setkach repozytoriów włącz stopniowe odsłanianie treści
Na czym polega: Płaska lista linków działa do około 20–40 repozytoriów. Powyżej tego plik instrukcji robi się nieczytelny dla agenta i człowieka. Rozwiązaniem jest tzw. progressive disclosure — stopniowe odsłanianie treści.
Jak stosować: Zamiast surowej listy repo, pogrupuj je w sekcje (frontend, backend, narzędzia wewnętrzne) i linkuj do konkretnych repo dopiero z poziomu danej sekcji. Agent trafi we właściwe miejsce zwykłą logiką systemu plików.
Na co uważać: Nie przesadzaj z głębokością zagnieżdżenia — każda dodatkowa warstwa to dodatkowy krok, który agent musi wykonać, zanim znajdzie to, czego szuka.
7.Monorepo, jeśli możesz; home repo, jeśli nie możesz
Na czym polega: Monorepo (wszystko w jednym repozytorium) pozostałoby ideałem, ale często jest niewykonalne — np. gdy część kodu musi być publiczna, a część prywatna, albo gdy decyzje blokuje polityka wewnątrz firmy. Wtedy repozytorium domowe daje większość korzyści monorepo bez łączenia kodu.
Jak stosować: Najpierw sprawdź uczciwie, czy da się scalić wszystko w jedno repo. Jeśli tak — rób monorepo. Jeśli nie — sięgnij po home repo jako najbliższą alternatywę.
Na co uważać: Nie traktuj home repo jako wymówki do wiecznego odkładania konsolidacji — jeśli granice między repozytoriami są czysto historyczne, warto je kiedyś posprzątać.
8.Prywatne skille trzymaj w repo, nie w publicznych paczkach
Na czym polega: Matt wyróżnia skille prywatne — wyjątkowo wartościowe i wrażliwe dla biznesu, których celowo nie publikuje. Umieszczenie ich w repozytorium domowym sprawia, że są dostępne w każdej sesji, a jednocześnie pozostają pod kontrolą dostępu.
Jak stosować: Jeśli organizacja ma listę skillów do rozprowadzenia, dodaj je właśnie w centralnym repo, pod zwykłymi uprawnieniami dostępu Gita.
Na co uważać: W repozytorium domowym wylądują też integracje z kluczami API — pilnuj, kto ma dostęp, i stosuj tę samą dyscyplinę bezpieczeństwa co przy kodzie produkcyjnym.
9.Repozytorium domowe to rama na własne narzędzia
Na czym polega: Własne narzędzia — integracje z Gmailem, Slackiem, Discordem, YouTubem, GitHubem, kalendarzem, raporty HTML — to według Matta element absolutnie kluczowy. Dzięki centralizacji mogą rosnąć organicznie w jednym miejscu i budować ekosystem, który łączy wszystkie części firmy: kod, dane i operacje.
Jak stosować: Zbuduj proste polecenie typu „help”, które wypisuje dostępne integracje. Potem każ agentowi łączyć kroki: „znajdź wiadomość na Discordzie, popraw błąd w repo kursu, a na koniec nanieś zmianę w kursie przez dedykowany skill”.
Na co uważać: Każda integracja to nowy zakres uprawnień dla agenta — wdrażaj je pojedynczo i testuj, co narzędzie może zrobić, zanim dasz mu klucz produkcyjny.
10.Wdróż wzorzec gotowym promptem
Na czym polega: Matt opisał wzorzec w artykule „The Home Repo Pattern”, do którego dołączył prompt do wdrożenia. Prompt przepytuje cię o twój setup, przegląda repozytoria, o które dbasz, i krok po kroku przenosi elementy do nowej centrali.
Jak stosować: Uruchom prompt w swoim środowisku, odpowiadaj szczerze na pytania o strukturę repozytoriów i pozwól agentowi przygotować migrację.
Na co uważać: To nie jest tryb „przyciśnij i zapomnij” — przeglądaj każdą proponowaną zmianę przed zatwierdzeniem, zwłaszcza tam, gdzie przenosisz istniejące skille i ustawienia.
Redakcyjne tłumaczenie
Wzorzec, który uważałem za zbyt oczywisty, żeby o nim pisać
Od jakiegoś czasu korzystam z pewnej techniki, która wydawała mi się za nudna i za prosta na osobny materiał. Aż w tym tygodniu, podczas spotkania z grupą kursantów, pokazałem ją w praktyce — i ludzie zareagowali: „Wow, to naprawdę fajne. Nie sądziłem, że może być tak prosto”. Wstawiłem o tym posta na Twitterze i zrobiło się głośno. Skoro tak, to znak, że warto o tym opowiedzieć szerszej publiczności.
Bo ta technika rozwiązuje konkretny problem: jak pracować z agentami w wielu repozytoriach jednocześnie. Nakreślmy sytuację.
Organizacja pełna osobnych repozytoriów
Wyobraź sobie organizację taką jak większość — mnóstwo repozytoriów, z których każde ma własne zadanie. Jedno to sklep internetowy, drugie API płatności, trzecie panel administracyjny, a do tego jeszcze dwadzieścia innych, do których od czasu do czasu trzeba zajrzeć.
Gdy zmiany dotyczą tylko jednego repo, nie ma dramatu: uruchamiasz agenta w kodzie sklepu i tyle. Nie stanowi też problemu sytuacja, w której w trakcie pracy nad sklepem okazuje się, że trzeba coś poprawić w API płatności — agent może po prostu operować w kilku katalogach naraz. W efekcie z jednej sesji wychodzą dwa pull requesty: jeden w repo sklepu, drugi w repo API. To działa i nie ma co tego ruszać.
Prawdziwy kłopot: skille, pliki sterujące i narzędzia
Trudność zaczyna się od danych — od plików sterujących i wszystkiego tego, co agent powinien mieć pod ręką w każdej sesji. Zwykle kończy się tak, że skille, narzędzia, AGENTS.md, może jeszcze linki do wiki, są zdublowane w wielu repozytoriach. Dzięki temu sesja uruchomiona w sklepie ma dostęp do tych samych umiejętności i narzędzi co sesja w API płatności. Ale to prawdziwa męka, bo wszystko to trzeba utrzymywać w zgodzie — w trzydziestu, czterdziestu repozytoriach.
Można by przenieść skille i narzędzia na komputery pracowników, do ich katalogu domowego — wtedy byłyby dostępne z każdego repo. Tylko że katalog użytkownika jest niewidoczny: nikt go nie aktualizuje, więc szybko zacznie odstawać od wspólnego standardu. Jest i głębszy powód — katalog użytkownika traktuję jako przestrzeń, w której każdy konfiguruje narzędzia pod siebie, a nie pod wymagania zespołu.
Wniosek? W układach wielorepozytoryjnych ludzie mają wrażenie, że nie mają dobrego wyboru. Dlatego proponuję rozwiązanie, które nazywam repozytorium domowym (home repo).
Rozwiązanie: repozytorium domowe
Od dłuższego czasu używam jednego repozytorium, które jest domem dla wszystkiego: wszystkich moich skillów, plików sterujących, wiki i sporej porcji autorskich narzędzi. Obowiązuje jedna zasada — agenta zawsze uruchamiam właśnie tam. A ponieważ to zwykłe repo, agent działający w nim może sięgnąć do sklepu, do API płatności, do dowolnej innej części kodu: operować w wielu repozytoriach naraz i pobierać cały kontekst, którego potrzebuje.
(Informacja dodatkowa: nagranie pokazuje przykład Claude Code, agenta kodującego firmy Anthropic — stąd nazwy plików takie jak CLAUDE.md czy settings.json.)
Co jest w środku
Pewnie myślisz: no dobrze, pokaż wreszcie to swoje repo. Proszę bardzo. Najważniejsze są dwie rzeczy. Pierwsza: plik CLAUDE.md (do niego zaraz wrócimy). Druga: katalog ze skillami na samej górze. To skille prywatne — celowo niepublikowane, bo są bardzo dobre i bardzo wrażliwe dla mojej firmy. Umieszczenie ich w repozytorium domowym sprawia, że są dostępne w każdej sesji. Jeśli wasza organizacja ma listę skillów do rozprowadzenia — to właśnie tutaj jest ich miejsce.
To także wersjonowana konfiguracja: sekcje w settings.json natychmiast rozciągają się na całą organizację. Natomiast całą nawigację porządkuje wspomniany plik z instrukcjami — CLAUDE.md, a w waszym przypadku może AGENTS.md.
(Informacja dodatkowa: AGENTS.md i CLAUDE.md to pliki ze stałymi instrukcjami dla agenta, wczytywane na początku każdej sesji — coś w rodzaju README pisanej dla maszyny.)
Znajdują się w nim wskaźniki do repozytoriów, których dotykam na co dzień. Zmiany w skillach lądują w repo „skills”. Aktizacje menedżera wideo kursowych — mojego repo z największym ruchem commitów — trafiają tam. Podobnie sprawy projektu CO5 i rzeczy związane z repozytorium kursu AI. Jak wyglądają te powiązania z repozytorium domowego do pozostałych? Banalnie: to zwykła ścieżka wpisana w AGENTS.md.
Świeży komputer i równoległe sesje
Na świeżo postawionym komputerze agent ogarnia resztę sam: jeśli repozytorium (u mnie Sandcastle) nie istnieje pod wskazaną ścieżką, zostaje sklonowane. A gdy naraz pracuje kilka agentów, każdy dostaje własne drzewo robocze w obrębie tego samego repo.
(Informacja dodatkowa: mowa o git worktree — dodatkowym drzewie roboczym, które pozwala mieć kilka niezależnych wersji tego samego repozytorium obok siebie, tak by równoległe procesy nie wchodziły sobie w drogę.)
W praktyce konfiguracja sprowadza się do zera: działa samo. Zostaje jedynie okazjonalne sprzątanie starych drzew po drodze. Dopisanie kolejnego repo do listy to jedna edycja AGENTS.md.
Skala: dwadzieścia repozytoriów tak, czterysta już nie
Ten układ spokojnie wystarcza na dwadzieścia, trzydzieści, czterdzieści repozytoriów. Przy czterystu by już nie zaniósł — wtedy warto w AGENTS.md zastosować tzw. stopniowe odsłanianie treści (progressive disclosure): zamiast surowej listy repo, pogrupować je w sekcje — „tu repozytoria frontendowe, tu backendowe, tu wewnętrzne narzędzia” — i dopiero z poziomu sekcji linkować do konkretnych projektów. Agent i tak trafi we właściwe miejsce, kierując się zwykłą logiką systemu plików.
Monorepo, jeśli się da. Home repo, jeśli się nie da
I przy okazji wyznam: kocham monorepo. Gdyby to wszystko mogło żyć w jednym repozytorium, zrobiłbym tak bez wahania. Pracowałem w Vercelu jako DevRel odpowiedzialny za Turborepo — to mój żywioł.
(Informacja dodatkowa: Turborepo to rozwijane przez Vercel narzędzie do zarządzania monorepo; DevRel to rola łącząca społeczność programistów z firmą.)
Tylko że monorepo nie zawsze jest możliwe — zwłaszcza gdy część repo musi być publiczna, a część prywatna. Więc mówię tak: jeśli możecie zebrać wszystko w jednym repozytorium — świetnie, róbcie to. Jeśli nie możecie — a najpewniej nie możecie, choćby z powodów polityki wewnątrz firmy — repozytorium domowe jest właściwą drogą.
Wiki i narzędzia, czyli to, co przemilczałem
Jest jeszcze jedna rzecz, którą celowo zepchnąłem na dalszy plan: od wdrożenia repozytorium domowego mogę pozwalać sobie na znacznie śmielsze narzędzia. Nazywam tę centralę swoją osobistą wiki, bo to ogromna baza wiedzy wrażliwej dla firmy — katalog pełen plików Markdown w stylu „wiki dla modeli językowych” Andreja Karpathy’ego, zawierający rzeczy, które moja publiczność uważa za ciekawe.
(Informacja dodatkowa: Andrej Karpathy — badacz AI, dawny lider zespołów w OpenAI i Tesla — popularyzował pomysł budowania osobistych baz wiedzy w Markdown, pisanych tak, żeby były wygodne dla modeli językowych.)
Jak tę wiki generuję i utrzymuję aktualną — opowiem w osobnym filmie, bo temat wzbudza prawdziwą obsesję. Ważne jest co innego: mogę ją odpytywać i wyciągać z niej bardzo bogate dane, które zasilają tworzenie kursów i treści. A dzięki repozytorium domowemu mamy oczywiste miejsce, w którym ta wiki mieszka.
Druga przemilczana sprawa: narzędzia. Są absolutnie kluczowe — chodzi o własne polecenia, którymi agent sięga do systemów, na których opiera się firma. Gdy uruchomię u siebie komendę wiki help, widać, ile tego urosło: integracje z Gmailem, Slackiem, Discordem, YouTubem, GitHubem, Kalendarzem Google, z AI Hero, z Cold Turkey (służącym mi do blokowania rozpraszaczy); dalej publikowanie jednorazowych raportów HTML czy dopisywanie notatek do Butter. To wszystko narosło organicznie w obrębie osobistej wiki i zbudowało cały ekosystem — a mogłem na nim budować właśnie dlatego, że wszystko mieści się w jednym, stałym miejscu.
Dzięki temu potrafię robić rzeczy w rodzaju: „znajdź tę wiadomość na Discordzie; wejdź do repo kursu i popraw tam błąd, korzystając z istniejących skillów; a na koniec weź skill CVM z menedżera wideo kursowych i nanieś poprawkę bezpośrednio w kursie”. Mówiąc krócej: repozytorium domowe staje się narzędziem, które spina wszystkie części firmy. Nie tylko kod — daje też agentowi dostęp do bogatych źródeł danych i rozbudowanej narzędziówki, dzięki którym po prostu pracuje lepiej.
Jak to poskładać u siebie
Napisałem artykuł „The Home Repo Pattern” — a w nim prompt, który przeprowadzi cię przez wdrożenie. Dokładnie cię przepyta o twój setup, przejrzyje repozytoria, o które musisz dbać, i zacznie przenosić rzeczy do nowej centrali. Link znajdziesz w opisie filmu.
A jeśli podoba ci się to, co publikuję, zajrzyj na mój samodzielny kurs AI coding crash course. To dobre wprowadzenie do agentów — zwłaszcza jeśli jeszcze ich nie próbowałeś albo czujesz, że w tym całym pędzącym świecie zostajesz w tyle.
To by było tyle. Wzorzec, który uważałem za zbyt banalny na osobny materiał — a gdy już go opisałem, okazało się, że rozwiązuje całą koplę problemów, z którymi ludzie naprawdę się zmagają. Używajcie, wdrażajcie — i cieszcie się nowym domem. Do zobaczenia następnym razem.