O czym jest ten film
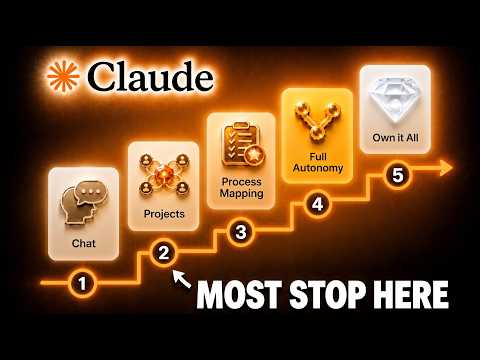
- Autor wyróżnia pięć warstw opanowania Claude; obserwował, jak setki osób z jego społeczności przechodziły dokładnie tę samą drogę.
- Fundamentem jest dobrze zbudowany prompt: cel z kontekstem, definicja „gotowe”, sposób samokontroli modelu, wyłączenia z zakresu i barierki ochronne.
- Popularne porady o promptowaniu zawodzą: rozpisywanie kroków, zwięzłość kosztem „dlaczego” oraz pomijanie tego, czego model robić nie ma.
- Projekty w Claude przechowują kontekst raz — pliki, styl marki, dane na żywo przez MCP — żeby nie wtłukiwać ich przy każdej rozmowie od nowa.
- Skille nie są instrukcjami obsługi zadania: buduje się je z listy własnych poprawek zebranych po pierwszym przebiegu roboty.
- Typowe błędy AI (np. schematyczne otwarcia tekstów) warto zlecić gotowym, publicznym skillom — w własnym skillu zostaje tylko to, co specyficzne dla twojego zadania.
- Zadania harmonogramowane łączą prompt, skilla i barierki; uruchamia je czas albo zdarzenie (np. nowy lead w CRM), a działają w chmurze lub na twoim komputerze.
- Nawet przy pełnej automatyzacji sprawy wysokiego ryzyka — pieniądze, reklamacje, kwestie prawne, pierwsza wysyłka w twoim imieniu — zostają pod twoją kontrolą.
- Piąta warstwa, „agentic OS”, wynosi cały kontekst, skille i pamięć do folderu z plikami Markdown, niezależnego od ekosystemu Anthropic.
- Autor uczciwie zaznacza, że warstwa piąta nie jest dla wszystkich: jedna firma i kilka projektów — wystarczą cztery warstwy.
10 najważniejszych takeaways — z kontekstem zastosowania
1.Przekaż całe zadanie, nie listę kroków
Na czym polega: Dawniej każono rozpisywać w prompcie pojedyncze kroki („krok pierwszy: wyszukaj, krok drugi: wypisz”). Własny przewodnik Anthropic mówi dziś, że model radzi sobie najlepiej, gdy dostanie z góry całą robotę i sam ułoży sobie szczegóły. Wymuszona sekwencja zamyka go w jednym sposobie myślenia.
Jak stosować: W prompcie opisuj cel, efekt końcowy i ograniczenia, a nie kolejność czynności. Plan działania zostaw modelowi — przy złożonych zadaniach często znajdzie lepszą drogę niż twoja.
Na co uważać: „Całe zadanie” nie znaczy „ogólnik”. Bez kontekstu i definicji „gotowe” model i tak będzie zgadywał — tylko gorzej.
2.Zawsze podawaj „dlaczego”
Na czym polega: Sekcja celu i kontekstu to miejsce, w którym model podejmuje drobne decyzje i przyjmuje założenia. Gdy zna powód, założenia wychodzą lepsze — jak u sprytnego pracownika, który zna sens zadania, a nie samo polecenie.
Jak stosować: Dołącz do promptu dwa–trzy zdania o celu biznesowym: po co to komu, kto jest odbiorcą, co się zmieni po wykonaniu.
Na co uważać: Moda na „krótkie prompty” bywa myląca — zwięzłość nie może iść w parze z wyciętym uzasadnieniem.
3.Wypisz, czego model robić nie ma
Na czym polega: Modele Claude 5 mają tendencję do robienia więcej, nie mniej, niż się poprosi. Dlatego lista wyłączeń („poza zakresem”) i zakazów („czego nie ruszać”) ma taką samą wagę jak samo określenie celu.
Jak stosować: Każdy prompt zamykaj wyraźnymi ograniczeniami: „nie publikuj”, „nie zmieniaj istniejących plików”, „nie dokładaj sekcji, o które nie prosiłem”.
Na co uważać: Pominięte zakazy model nadrobi własną inwencją — poprawi, przeredaguje albo rozbuduje coś, czego ruszać nie chciałeś.
4.Zapisz w prompcie sposób samokontroli
Na czym polega: Prawie nikt nie określa, jak model ma zweryfikować własną pracę. Walidacja to danie mu powodu i metody potwierdzenia, że poszedł dobrą drogą — w przykładzie z filmu każde wykryte pytanie klienta musi prowadzić do rzeczywistego wyniku wyszukiwania, który da się udowodnić.
Jak stosować: Jedno zdanie na końcu promptu: „Zanim oddasz wynik, sprawdź, czy [warunek], i pokaż dowód sprawdzenia”.
Na co uważać: Kryterium musi być obiektywne (dowód, link, test). Bez tego model po prostu oświadczy, że wszystko się zgadza.
5.Jeden projekt na jeden zestaw kontekstu, nie na jedno zadanie
Na czym polega: Projekt w Claude przechowuje wejścia (pliki, instrukcje, styl marki, dane z MCP) i wyjścia (szkice, artefakty, pulpity). Reguła autora: projekt wyznacza wspólny kontekst, a nie pojedyncza czynność. Test: czy te dwa zadania potrzebują tych samych plików?
Jak stosować: Grupuj zadania wokół wspólnych plików — copywriting dla dwóch firm to dwa osobne projekty, bo zmienia się głos marki i dokumenty.
Na co uważać: W projekcie trzymaj „kim jesteś”, a nie „jak wykonać to konkretne zadanie” — instrukcje wykonania należą do skilla.
6.Podłączaj pliki przez MCP zamiast wgrywać kopie
Na czym polega: Wgrany plik to kopia zapisana w chwili wgrania — wystarczy poprawić oryginał i już jest nieaktualny. Dokument Google połączony przez MCP jest czytany w aktualnej wersji za każdym razem; jedna poprawka briefu stylu marki trafia do wszystkich projektów i wszystkich osób w zespole.
Jak stosować: Briefy marki i wspólne dokumenty prowadź w narzędziu współdzielonym (np. Dokumenty Google) i podłącz przez MCP; wgrywaj tylko pliki naprawdę statyczne.
Na co uważać: Przy wielu klientach pilnuj, które źródła są wspólne, a które muszą być odseparowane — wygodne współdzielenie w zespole bywa ryzykiem przy danych klientów.
7.Buduj skille z listy poprawek, nie od zera
Na czym polega: Wykonaj zadanie raz bez skilla, popraw wynik do pożądanego efektu i każ modelowi spisać wszystkie poprawki. Potem posortuj listę: fakty o tobie i firmie wracają do kontekstu projektu; typowe błędy AI (np. otwarcia w stylu „to nie X, lecz Y”) załatwią gotowe publiczne skille, jak „Stop Slop”; reszta — specyficzna dla twojej roboty — tworzy skilla.
Jak stosować: Każde nowe, powtarzalne zadanie przechodź ścieżką: pierwszy przebieg → poprawki → segregacja → skill.
Na co uważać: Nie wrzucaj do skilla wszystkiego — instrukcja dłubana z danych firmy gorzej się utrzymuje i nie przenosi między projektami.
8.Dokładaj przykłady i testuj skilla „z nim i bez”
Na czym polega: Dwie realne strony cytowane w odpowiedziach AI wystarczą, by model wyprowadził zasady sukcesu. Ostatni krok to porównanie tego samego zadania ze skillom i bez — wbudowaną funkcją ewaluacji w skillu „skill creator” od Anthropic. Skill bez testów może w praktyce nic nie wnosić.
Jak stosować: Trzymaj stały zestaw zadań testowych i listę kryteriów; przed wdrożeniem skilla zestaw oba przebiegi obok siebie.
Na co uważać: Przykłady muszą pochodzić z twojej pracy — wzorce z cudzych kontekstów łatwo przeradzają się w reguły, które do niczego nie pasują.
9.Zadanie harmonogramowane: krótki brief, wyzwalacz, barierki
Na czym polega: Brief to gotowe prompty z warstwy pierwszej plus wskazany skill, miejsce zapisu wyniku i wyraźne „czego nie wolno”. Start wyznacza czas (np. poniedziałek 9:00) albo zdarzenie: pull request w GitHubie czy wywołanie API — na przykład gdy nowy lead spada do CRM-a. Domyślnie zadanie działa w chmurze, więc laptop może być zamknięty; opcja „wymagaj tego komputera” ogranicza je do czasu, gdy maszyna pracuje.
Jak stosować: Zacznij od czterech linijek: znajdź okazję w danych tygodnia, napisz szkic z skillom, zapisz w folderze szkiców, niczego nie publikuj.
Na co uważać: Praca w chmurze wymaga całego kontekstu w repozytorium, a sprawy ryzykowne — pieniądze, reklamacje, prawo, pierwszy mail w twoim imieniu — zawsze przechodzą przez twoją zgodę.
10.Przy wielu klientach rozważ własny „agentic OS”
Na czym polega: W aplikacji Claude kontekst, skille i zadania żyją w jednym ekosystemie — zmiana narzędzia lub dołączenie kolejnego klienta oznacza ręczne kopiowanie wszystkiego. Agentic OS to folder na twoich zasadach: podfoldery „ty”, „marka”, „procesy” (skille z briefami i testami walidacji), pamięć zapisywana w trakcie pracy, osobne dane każdego klienta przy jednym egzemplarzu każdego skilla. Zwykły Markdown otwiera się w Claude Code, Codex i Cursor.
Jak stosować: Migruj stopniowo: najpierw struktura folderów, potem skille jako pliki, na końcu system pamięci zapisujący decyzje i poprawki do wyznaczonego katalogu.
Na co uważać: To nie jest system operacyjny ani nowa aplikacja — a przy jednym biznesie i kilku projektach ta warstwa bywa zbędna. Nie przebudowuj na zapas.
Redakcyjne tłumaczenie
Możesz znać wszystkie funkcje i dalej robić całą robotę sam
Możesz obejrzeć na YouTube każdy istniejący poradnik o Claude — i mimo to wciąż kończyć z najcięższą częścią roboty na swojej głowie. Poznasz wszystkie funkcje, ale żadnego zadania tak naprawdę nie przekażesz dalej. A sedno jest inne: w tym samym czasie co zawsze, przy wsparciu AI, załatwiać znacznie więcej. Widziałem, jak setki osób z mojej społeczności dochodziły do tego poziomu — i za każdym razem droga wiodła przez te same pięć warstw.
Warstwa 1. Czat — fundament, z którego się nie wyrasta
Pierwsza warstwa zaczyna się w oknie czatu. Większość traktuje czat jako poziom dla początkujących — coś, z czego dorasta się do projektów i agentów. Tymczasem jest dokładnie odwrotnie: każda kolejna warstwa stoi na tych fundamentach. Jeśli tu popełniasz błędy, nigdy porządnie nie dojdziesz do warstwy piątej.
Wszystko zaczyna się od dobrze napisanego promptu. Ma pięć elementów:
- cel i kontekst zadania,
- definicję „gotowe” — jak ma wyglądać ukończona praca,
- sposób, w jaki model ma sprawdzać własną pracę,
- wyłączenia — co nie wchodzi w grę w tym zadaniu,
- barierki: czego model nie może ruszać.
Sporo z porad o pisaniu promptów, krążących sprzed kilku miesięcy, co najmniej jeden z tych punktów traktuje błędnie.
Pierwszy błąd to rozpisywanie kroków. Każono wyliczać pojedyncze czynności: „krok pierwszy, wyszukaj to; krok drugi, wypisz tamto”. Tymczasem własny przewodnik Anthropic mówi dziś, że model radzi sobie najlepiej, gdy dostanie z góry całe zadanie i sam ułoży sobie szczegóły. Rozpisane kroki wydają się pomocne, ale przynoszą skutek odwrotny: zamykają model w jednym sposobie myślenia i działania.
Drugi błąd: krótkie prompty bez uzasadnienia, bez „dlaczego”. To właśnie w sekcji celu i kontekstu model podejmuje drobne decyzje i przyjmuje założenia. Jeśli wie, po co czegoś potrzebujesz, chętniej podejmie lepsze założenia tam, gdzie trzeba. Dokładnie tak samo sprytny pracownik: da lepsze rezultaty, gdy wyjaśnisz mu, po co firma w ogóle robi dane zadanie.
Trzeci błąd: mówienie wyłącznie o tym, czego chcemy. Modele Claude 5 mają tendencję do robienia więcej, nie mniej, niż się poprosi. Dlatego wyliczenie, co jest poza zakresem i czego nie wolno ruszać, waży tyle samo, co samo określenie celu. Bez wyraźnych zakazów model będzie „pomagał” w rzeczach, o które nikt nie prosił.
I wreszcie rzecz, której prawie nikt nie pisze: walidacja. Chodzi o danie Claude’owi powodu i sposobu, żeby sprawdził własną pracę i potwierdził, że poszedł dobrą drogą. Weźmy przykład: chcesz, by twoja strona była cytowana w Google i w odpowiedziach ChatGPT. Celem zadania jest znalezienie pytań, które twoi klienci zadają w ChatGPT, a na które twoje treści nie odpowiadają. Walidacja: każde takie pytanie musi prowadzić do rzeczywistego, dającego się udowodnić wyniku.
(Informacja dodatkowa: „AI search” to wyszukiwanie w czatach AI — użytkownicy zamiast w Google pytają ChatGPT czy Perplexity, a strony walczą o cytowania w tych odpowiedziach.)
Warstwa 2. Projekt — kontekst podajesz raz
Samo okno czatu nie przechowuje nic, co da się użyć ponownie. Model może przeszukać wyłącznie własną pamięć, więc wciąż wtłaczamy w narzędzie te same informacje od nowa — a każda taka powtórka zżera czas na bieżąco.
Lekarstwem jest projekt. Projekt to wejścia i wyjścia: to, co wgrasz raz, każdy czat wewnątrz projektu dostaje już jako punkt wyjścia. Wejściami mogą być pliki, instrukcje do określonych zadań, głos marki, identyfikacja wizualna, a nawet dane na żywo z podłączonych aplikacji — na przykład przez MCP albo API. Wyjściami są szkice, pliki, a nawet interaktywne pulpity — wszystko jako artefakty w Claude.
(Informacja dodatkowa: MCP (Model Context Protocol) to otwarty standard łączenia modeli z zewnętrznymi danymi i narzędziami — dzięki niemu Claude czyta np. aktualne dokumenty albo dane z aplikacji analitycznych.)
Wróćmy do przykładu z widocznością w wyszukiwaniu AI. Trzymasz w projekcie pliki firmowe i opis twojego stylu pisania, a projekt na bieżąco czyta twoje pozycje z rankspot.ai, Data for SEO czy Ahrefs — to są wejścia. Wyjściem może być choćby interaktywny pulpit z rankingami. Konsekwencja: nie musisz już podawać kontekstu za każdym razem. Dawny, rozbudowany prompt z celem i kontekstem skraca się do jednej linijki — „znajdź okazje z tego tygodnia” — bo model wie z plików, że to projekt SEO, więc szuka stron, które tracą ruch, i pytań, w których ChatGPT cytuje konkurenta zamiast ciebie. Kontekst realnie pracuje w tym podstawowym prompcie.
Przy zakładaniu projektów moja reguła jest taka: jeden projekt na jeden zestaw kontekstu, nie na jedno zadanie. Test, który warto sobie zadać: czy te dwa zadania potrzebują tych samych plików? Jeśli tak — mogą mieszkać w jednym projekcie. Gdy zmienia się głos marki albo klient, a wraz z nimi zestaw plików — projekt dzielimy. Dlatego mam osobne projekty copywriterskie, po jednym na każdą firmę.
Żeby oszczędzić jeszcze więcej czasu, korzystaj z plików podłączonych przez MCP zamiast wgranych plików czy CSV. Wgrany plik to kopia — wystarczy, że poprawisz oryginał, i już jest nieaktualny. Podłączony Dokument Google jest czytany w świeżej wersji za każdym razem. Aktualizujesz raz brief głosu marki i każdy projekt ma nową wersję. Tak samo wygląda praca zespołowa: udostępniasz dokument z uprawnieniami dla wszystkich i każda osoba, w każdej rozmowie, pracuje na najnowszej wersji.
Jest jednak granica: projekt powinien przechowywać szeroki kontekst — kim jesteś, co ci odpowiada — a nie to, jak chcesz wykonane konkretne zadanie. Na to jest coś innego.
Warstwa 3. Skille — jak zrobić robotę, nie kim jesteś
Wbrew temu, co mówiono wcześniej, umiejętność (ang. skill) nie jest instrukcją obsługi zadania. Podział wygląda tak: kontekst mówi modelowi, kim jesteś; skill mówi mu, jak zrobić daną robotę — a właściwie jak jej nie robić. Wszystko, co dotyczy „kto” i „co”, zostaje w projekcie; wszystko, co dotyczy „jak”, trafia do skilla, który dzięki temu służy w wielu projektach. To właśnie dlatego wydzielamy go osobno.
Kiedyś budowałem skille od zera. Dziś robi się to zupełnie inaczej: skill ma zawierać wyłącznie te poprawki, których Claude nie zdoła zrobić dobrze sam z siebie. Schemat jest prosty. Zrób zadanie raz bez skilla. Poprawiaj wynik, aż będzie taki, jak chcesz. Każ modelowi prowadzić listę wszystkich wprowadzonych poprawek. Dopiero z tej listy budujemy skilla.
Najpierw listę trzeba posortować, bo nie każda poprawka należy do skilla. Część to kontekst projektu — wszystko, co mówi o tobie lub twojej firmie, wraca do projektu. Część to typowe błędy AI jako takie, na przykład otwieranie tekstów schematem „to nie X, lecz Y”. Za to nie musisz odpowiadać: są gotowe, publiczne skille, na przykład do humanizowania treści czy „Stop Slop”, które już to załatwiają. To, co zostanie po tym rozdziale — poprawki specyficzne dla twojego konkretnego zadania — tworzy właściwego skilla.
Potem dokładamy przykłady. W przypadku widoczności w AI możesz podać dwie swoje strony, które są cytowane w odpowiedziach AI; model porówna je z resztą i wyprowadzi zasady, jak ten efekt powtórzyć. Zrobi to, zestawiając wykonanie zadania bez przykładu z wykonaniem bez reguł skilla.
Ostatnia część brzmi tak banalnie, że aż głupio ją wypowiadać — a jednak prawie nikt tego nie robi: sprawdź skilla w praktyce, z nim i bez niego. To samo zadanie, te same prompty startowe, dwa przebiegi obok siebie — w wbudowanej funkcji testów (eval) skilla „skill creator” od Anthropic. Zobaczysz zestawienie jeden do jednego: jak model wypadł przy liście kryteriów ze skillom i bez. Bo skill bez testów może w praktyce nie robić niczego.
Od tej pory robotę dostajesz wykonaną po twojemu — za każdym razem, zgodnie z procedurą zapisaną w skillu. Ale to wciąż ty otwierasz czat i o nią prosisz. Czas na większą samodzielność.
Przy okazji: wszystko, co dotychczas opisałem, to trzy pierwsze etapy naszego nowego kursu w Agentic Academy, „Scale Your Output with AI”. W kursie buduję każdą warstwę na prawdziwych zadaniach, które wykonuję w swojej firmie tydzień po tygodniu, i od razu przykładamy je do waszych problemów, żeby było widać, jak warstwy układają się w konkretnym scenariuszu. Link znajdziecie w opisie filmu.
Warstwa 4. Zadania harmonogramowane — robotę ma robić bez ciebie
Celem tej warstwy jest, żeby zadanie działało bez nas. Wystarczy dołożyć krótki brief i utworzyć zadanie harmonogramowane. Brief to dosłownie prompty, które i tak napisałaś lub napisałeś w warstwie pierwszej, plus skill potrzebny do roboty, plus — bardzo ważne, gdy nikt nie patrzy — informacja, gdzie zapisać wynik i czego nie wolno ruszać. W przypadku widoczności w AI wystarczą cztery linijki: znajdź najlepszą okazję w danych z tego tygodnia; napisz szkic strony z użyciem skilla; zapisz jako szkic do folderu; niczego nie publikuj. Słowem: barierki.
W aplikacji Claude były to kiedyś dwie osobne rzeczy — zadania harmonogramowane w aplikacji i rutyny w Claude Code. Ostatnio złączono je w jednej zakładce „scheduled”, więc całość konfiguruje się w jednym miejscu. Zostają dwie decyzje, które mają znaczenie: co uruchamia zadanie i gdzie ono działa.
Co uruchamia, czyli wyzwalacz. Może być czasowy — „w każdy poniedziałek o 9:00”. Może być zdarzeniowy: wydarzenie w GitHubie, na przykład nowy pull request albo zgłoszenie, albo wywołanie API z twojego własnego narzędzia. Możesz więc zmusić zadanie do startu konkretnym wydarzeniem: nowy lead spada do CRM-a, system to wykrywa i od razu uruchamia zaplanowane zadanie. Dzięki temu reagujesz natychmiast, a nie czekasz do następnej pełnej godziny na szkic follow-upa, który i tak miał napisać AI.
Gdzie działa. Domyślnie w chmurze: laptop może być zamknięty, a zadanie i tak się wykona — z dostępem do podłączonych narzędzi, z możliwością uruchamiania skryptów, edycji plików i pracy na wszystkim, co jest w repozytorium. Trzeba tylko wskazać repozytorium na GitHubie i zadbać, by cały kontekst był tam dostępny. Jeśli zadanie potrzebuje folderów z twojego komputera, zaznaczasz opcję „wymagaj tego komputera” — wtedy ruszy tylko przy włączonej maszynie. (Konfigurację takiego repozytorium z kontekstem, do pracy z dala od komputera, pokazujemy w kursie.)
Samodzielność nie znaczy, że przestajesz widzieć, co się dzieje. Musisz wybrać, w których punktach wchodzisz — zależnie od ryzyka zadania. Są rzeczy, których nigdy nie oddaję: wszystko, co dotyczy pieniędzy, reklamacji, spraw prawnych i wszystko, co ma wyjść po raz pierwszy w moim imieniu. Większość moich maili na przykład nie zostanie wysłana bez mojej zgody. Radzę traktować to samo.
Gdy te cztery warstwy złożymy w całość, zadanie wykonuje się za nas — we właściwym standardzie i czeka na przegląd, kiedy nas nawet nie ma przy laptopie. Zostaje pytanie, gdzie to wszystko mieszka. Czas na warstwę piątą.
Warstwa 5. Agentic OS — wszystko w folderze, który należy do ciebie
Rozejrzyjmy się: twój kontekst siedzi w projekcie Claude, twoje skille są przypięte do konta jako pliki do pobrania, zadania harmonogramowane też żyją w aplikacji. Jeśli za rok pojawi się coś lepszego niż Claude — a kto dziś wie, co przyniesie przyszłość — wszystko będziesz przebudowywać ręcznie. A w chwili, gdy zaczniesz pracować dla więcej niż jednej firmy albo dla kilku klientów, każdy z nich potrzebuje własnej kopii wszystkiego.
Ostatnia warstwa wynosi to wszystko z aplikacji i składa w jednym folderze, do którego ty masz klucze. Nazwa brzmi górnolotnie: agentic operating system, w skrócie agentic OS. Termin krąży ostatnio wszędzie i rozumiem, że wielu osób razi słowo „system operacyjny” — słusznie, bo technicznie to żaden system operacyjny. To nie nowa aplikacja i nie zamiennik programu Claude, w którym już pracujesz. Nadal działamy w tym samym oknie — otwieramy zakładkę kodu i wskazujemy właściwy folder. Różnica jest taka, że teraz można użyć dowolnego interfejsu, dowolnego modelu, dowolnego narzędzia. Agentic OS to po prostu to, co leży pod spodem: pliki, z których twoje AI czyta.
Architektura jest prosta i zawiera sporo tego, o czym już rozmawialiśmy. Ustandaryzowana struktura: folder o tobie i o tym, jak pracujesz; folder marki — głos, pozycjonowanie, do kogo sprzedajesz; folder procesów, czyli skille, po jednym na każde zadanie, każdy z własnym briefem i własnymi testami walidacji. Do tego przetestowany system pamięci, który można podłączyć w wielu miejscach. I najważniejsze: obsługa wielu klientów. Każdy klient dostaje własny folder z własnym głosem, danymi i zasadami, ale wspólne elementy nadal się dzieli — istnieje tylko jedna kopia każdego skilla, więc poprawka znaleziona u jednego klienta trafia do wszystkich pozostałych. A ponieważ wszystko to zwykły Markdown, ten sam folder otwiera się w Claude Code, Codex i Cursor i działa dokładnie tak samo. Nie zostajesz więc uzależniony od ekosystemu Anthropic.
(Informacja dodatkowa: Claude Code, Codex i Cursor to środowiska do pracy z AI na plikach i kodzie; otworzenie tego samego folderu w każdym z nich oznacza, że cała konfiguracja jest przenośna.)
Najpotężniejszy element to pamięć — i tu różnica względem aplikacji jest największa. Pamięć w projekcie Claude zostaje w tym jednym projekcie, w tej jednej aplikacji. W agentic OS pamięć zapisuje się w trakcie pracy do folderu, który sam wskażesz. Decyzja albo poprawka z zeszłego tygodnia wciąż tam leży i jest dostępna w kontekście — w każdym narzędziu, w którym otworzysz folder. Pamięć jest trzymana osobno dla każdego klienta, więc nic nie przecieka między nimi. A skoro to twoje pliki, możesz je przeczytać i naprawić wszystko, co się nie zgadza. Własny system pamięci zbudowaliśmy, testując inne rozwiązania — po prostu wpina się go w naszego agentic OS.
Szczerze mówiąc, mnóstwo osób nigdy nie dochodzi do tej warstwy — i nigdy jej nie potrzebuje. Jeśli prowadzisz jeden biznes, kilka projektów to załatwia, a praca w Claude ci odpowiada, po prostu zatrzymaj się na warstwie czwartej: zautomatyzuj, oszczędź czas i osiągnij cel, czyli rób więcej w tym samym wymiarze godzin.
Puenta: te same godziny, nieporównywalnie więcej zrobione
I to są wszystkie pięć warstw. Jeśli zastosujesz je porządnie, możesz skończyć jak dwie osoby z mojej społeczności, które na zeszłotygodniowym spotkaniu na żywo powiedziały mniej więcej tak: pracują tyle samo godzin co zawsze — bo wszyscy jesteśmy uzależnieni od ciągłej pracy — ale przy tych narzędziach, warstwach i procesach załatwiają dziś wielokrotnie więcej niż kiedykolwiek wcześniej. Dzięki za obejrzenie. Do zobaczenia następnym razem.