O czym jest ten film
- Autor wraca do niedawnego materiału o Gemini 4 Carbon i przyznaje, że był w nim zbyt łagodny.
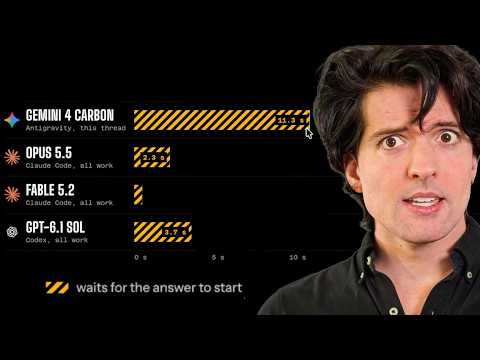
- Audyt własnych, rzeczywistych zadań pokazał, że model jest konsekwentnie pięć razy wolniejszy od całej konkurencji.
- Główna przyczyna to ponad 11 sekund od przyjęcia żądania do pierwszego tokenu — koszt powtarzany przy każdym kroku agenta.
- Publiczne benchmarki nie wychwytują problemu, bo mierzą pojedyncze żądania, a nie wieloetapowe zadania agentowe.
- Cache działa loteryjnie: w około 30% przypadków model nie odczytuje własnego, świeżo zapisanego cache’u; średnio czyta ten sam plik 8–16 razy.
- Od 1 grudnia cena modelu ma się podwoić.
- Analogiczny problem z opóźnieniami autor opisał kiedyś u Microsoft Azure z modelami OpenAI — po jego głośnej interwencji został naprawiony.
- Poza techniką pojawia się osobista krytyka Varuna z DeepMind (wcześniej Windsurf) za zbywającą, publiczną odpowiedź i za sposób odejścia z własnej firmy.
- Hosting na Vertexie bywa nieużywalny, a wpisany w nazwę modelu poziom wysiłku rozumowania psuje klientom analitykę.
- Konkluzja: obecnie nie ma powodu, by dobrowolnie wybierać Gemini; subskrypcja Claude za 20 dolarów daje więcej.
10 najważniejszych takeaways — z kontekstem zastosowania
1.W pracy agentowej decyduje czas do pierwszego tokenu, nie tempo generowania
Na czym polega: Model może generować tokeny przyzwoicie, a i tak być pięciokrotnie wolniejszy, bo ponad 11 sekund marnuje, zanim cokolwiek zacznie. W narzędziach agentowych każdą turę ten koszt obciąża od nowa.
Jak stosować: W logach mierz osobno dwie liczby — czas do pierwszego tokenu i czas samego generowania — a potem przemnóż pierwszą z nich przez liczbę tur w typowym zadaniu, zanim ocenisz model.
Na co uważać: Publiczne benchmarki zwykle pokazują pojedyncze żądania, więc narzut wielokrokowych tur pozostaje w nich niewidoczny.
2.Testuj model na własnym, wieloetapowym zadaniu — nie na rankingu
Na czym polega: Skala problemu Gemini wyszła dopiero w audycie rzeczywistych wątków; w zestawieniach pojedynczych żądań model wypadał po prostu „wolno”.
Jak stosować: Przed decyzją o wyborze modelu odpal kilka typowych zadań ze swojego repozytorium w trybie agentowym i porównaj czasy całkowite — od startu do ukończenia.
Na co uważać: Wyniki z subskrypcji i z API (np. Vertex) potrafią się istotnie różnić; sprawdzaj ten kanał, z którego realnie będziesz korzystać.
3.Audytuj własne logi zamiast ufać wrażeniom
Na czym polega: Autor odpala wątki i wraca po ich zakończeniu, więc długo nie widział, że jeden model wyraźnie wyhamowuje całą pracę. Prawda wyszła dopiero z danych.
Jak stosować: Co jakiś czas porównuj w historii użycia sumaryczny czas trwania zadań dla poszczególnych modeli — to lepsza metryka niż subiektywne „czu się okay”.
Na co uważać: Pojedynczy udany test łatwo daje złudzenie, że model się sprawdza, zwłaszcza gdy pracujesz na kilku modelach równolegle.
4.Waliduj skuteczność cache u dostawcy
Na czym polega: Według autora zapis do cache i odczyt z niego w Gemini nie trafiają w około 30% przypadków (model czyta starszy wpis albo wcale), a dodatkowo wielokrotnie wczytuje te same pliki.
Jak stosować: Monitoruj wskaźnik trafień w cache i koszt powtórzonych prefillów; jeśli spada poniżej oczekiwań, rozważ zmianę dostawcy albo reorganizację promptów.
Na co uważać: Niska skuteczność cache potrafi zamienić nominalnie tani model w najdroższy w rzeczywistym rachunku.
5.Porównuj koszt ukończonego zadania, nie cenę tokena
Na czym polega: Gemini 4 Carbon ma podwoić cenę od 1 grudnia, a dodatkowe tury i powtórzone wczytywanie plików dalej mnożą rachunek.
Jak stosować: Przelicz koszt typowego zadania od początku do końca (tokeny × liczba tur × cena) dla kilku modeli — dopiero to porównanie mówi, co się opłaca.
Na co uważać: Dopłaty w subskrypcjach potrafią maskować rzeczywisty koszt; przy API doliczaj też nieudane odczyty cache.
6.Dodawaj timeouty i zasady przerwania dla wolnych wywołań
Na czym polega: Autor dodał do instrukcji agentów zasadę „nie czekajcie na Carbon, przerwijcie i wracajcie do roboty” — bez tego wyniki pomiaru byłyby jeszcze gorsze, a wątki wciąż by się blokowały.
Jak stosować: W systemach agentowych konfiguruj limity czasu i priorytety tak, by jeden powolny model (np. w roli sędziego) nie wstrzymywał całego łańcucha zadań.
Na co uważać: Przerwane wywołanie może zostawić zadanie w stanie pośrednim — zadbaj o mechanizm ponawiania.
7.Standaryzuj metadane modeli po swojej stronie
Na czym polega: Google wpisuje poziom wysiłku rozumowania w sam identyfikator modelu, zamiast w osobne pole, jak pozostali dostawcy — co psuje klientom analitykę i automatyzację.
Jak stosować: Zbuduj własną warstwę pośrednią, która normalizuje nazwy, wersje i parametry modeli, żeby zmiany u dostawcy nie wywróciły raportów.
Na co uważać: Nieoczywiste identyfikatory utrudniają porównania kosztów i testy A/B między modelami.
8.Oceniaj model na czterech osiach naraz
Na czym polega: Jedyna zaleta Gemini wskazana przez autora — rzadsze flagowanie przy zadaniach z bezpieczeństwa — nie równoważy gorszej jakości, wyższego kosztu, niższej prędkości i niestabilnej infrastruktury.
Jak stosować: Przy wyborze modelu sprawdzaj równocześnie: jakość wyników, czas ukończenia zadania, koszt zadania i niezawodność hostingu. Decyzja po jednej osi to zakład, nie analiza.
Na co uważać: Model wybrany pod jedną cechę (np. mniejszą skłonność do blokowania zapytań) może kosztować zespół więcej w straconym czasie, niż zaoszczędzi.
9.Reakcja dostawcy na krytykę mówi więcej niż slajdy
Na czym polega: Odpowiedź „zawsze jest kompromis między opóźnieniem a kosztem” padła przy modelu najdroższym, najwolniejszym i najmniej wygodnym w zestawieniu — co autor odczytuje jako przyznanie się do przegrywania na każdej osi.
Jak stosować: Wybierając dostawcę, sprawdź, jak szybko i konkretnie reaguje na zgłoszenia błędów; to lepszy predyktor dalszej współpracy niż materiały marketingowe.
Na co uważać: Uprzejmy support to nie to samo co realne naprawy — patrz na faktyczne zmiany w produkcie i SLA.
10.Miej przetestowaną alternatywę na zawołanie
Na czym polega: Autor kończy radą, by zamiast Gemini wziąć subskrypcję Claude za 20 dolarów — wychodzi z niej więcej inferencji i więcej zrobionej pracy.
Jak stosować: Jeśli siedzisz na jednym modelu, zrób próbny miesiąc na alternatywie i porównaj czasy oraz koszty na identycznych zadaniach.
Na co uważać: Migracja „na hurra” bywa kosztowna — testuj równolegle, zanim odpuścisz dotychczasowe narzędzia.
Redakcyjne tłumaczenie
Wstęp: muszę się poprawić
Jak zapewne zauważyliście, właśnie opublikowałem film o Gemini 4 Carbon. I choć planowałem być dla tego modelu naprawdę krytyczny, jakoś pogodziłem się z nim — nie dlatego, że świetnie pisze kod albo dobrze radzi sobie z 3D, ale dlatego, że poza tym nie wyglądał na narzędzie, które będzie mnie zbytnio ograniczać. To miało dla mnie realną wartość. W każdym innym względzie nie znalazłem powodu, żeby go używać. Postarałem się pokazać fakty: ile kosztuje, jak szybki jest naprawdę, jak wygląda w prawdziwych projektach. I nie byłem wystarczająco ostry. Trochę mnie to boli, bo — jak wspominałem — lubię pracować z ludźmi z DeepMind. Są ze mną szczery, są świetni i naprawdę próbują naprawiać problemy.
I właśnie dlatego powstaje ten film: bo myliłem się co do skali różnicy w prędkości. Wspomniałem, że Gemini 4 Carbon w wariancie Low jest wolniejszy niż praktycznie każdy model w historii. Nie wiedziałem, że jest pięć razy wolniejszy.
Jak wielu z was wie, rzadko śledzę swoje wątki na żywo — odpalam je i wracam, gdy skończą. Tym razem poświęciłem czas, żeby przeanalizować własne, rzeczywiste użycie wszystkich modeli. W porównywalnej pracy Gemini był konsekwentnie pięć razy wolniejszy od wszystkiego innego. Ile byście nie myśleli, że jest źle — jest gorzej. Wyładuję się tu z całą siłą, bo to pokazuje coś fundamentalnego: Google ma kompletnie gdzieś ludzi korzystających z ich inferencji. Dopóki tego nie naprawią, nie powinniście traktować tej firmy poważnie. Nie lubię być tak surowy, ale czuję odpowiedzialność — bo tu zawaliłem. I, uczciwie mówiąc, mam wrażenie, że nikt inny też nie mówi o tym szczerze. Ludzie serio uważają modele Gemini za rozsądną alternatywę. Nie potrafię szanować kogoś, kto dziś wybiera Gemini, bo jest aż tak zły. Przepraszam moich znajomych tam: mam nadzieję, że użyjecie tego filmu jako dźwigni — zarówno do naprawienia tych rzeczy, jak i na rozmowach o pracę w firmach, którym naprawdę na tym zależy. Bo ja mam tego serdecznie dość. Szczegóły bałaganu po stronie hostingu Gemini wyłożę po krótkim słowie od sponsora.
Sponsor odcinka: Infinite Red
Kiedyś zbudowanie aplikacji mobilnej wymagało całego, wyspecjalizowanego zespołu, a nawet dwóch — jednego na iOS, drugiego na Androida. Zrobienie tego dobrze było naprawdę trudne. Nawet ze znakomitymi narzędziami takimi jak React Native czekało na was tyle pułapek, że trafienie graniczyło z cudem. Wierzcie mi, mam doświadczenie: budowałem mnóstwo aplikacji — z React Native i bez niego. Liczba pułapek, w które można wpaść nawet jako ekspert, jest po prostu obrzydliwa. Wasze agenty mogą być świetne, ale wpadną w nie szybciej i narobią więcej szkód. Byłem tam. Było brutalnie.
Infinite Red to jedni z liderów rynku pod względem wiedzy o React Native, ale nie zamykają się w nim: chętnie sięgną po Swifta, Kotlina, Objective-C czy Javę, jeśli to da najlepszą wydajność. Od lat pomagają firmom ustawiać bazy kodu pod sukces w React Native — a te same praktyki świetnie służą agentom. Jeśli kod jest na tyle idiotoodporny, że inżynier mniej obeznany z natywnym developmentem pisze w nim dobrze, to agent ogarnia go jeszcze lepiej. Możecie zatrudnić drogie, wyspecjalizowane zespoły mobilne — albo zrobić to, co zrobiły „małe biznesy” typu Microsoft, Domino’s czy Realtor.com. Zaraz, to przecież wielkie firmy. No właśnie: robienie dobrych aplikacji mobilnych jest na tyle trudne, że nawet giganci zdają się na Infinite Red. Niezależnie od tego, czy chcecie zlecić development na zewnątrz, podciągnąć swój zespół webowy, czy po prostu upewnić się, że agenty piszą dobry kod — warto z nimi porozmawiać.
Nie da się tego modelu bronić
Przepraszam z góry za moją szczerość — obecną i tę przeszłą. Nie potrafię poważnie traktować opinii inżynierskiej nikogo, kto uważa, że ten model nadaje się do prawdziwej pracy — z jednym wyjątkiem: przy zadaniach z cyberbezpieczeństwa rzadziej was oflaguje. Poza tym dosłownie nie ma powodu, żeby go teraz używać. Straciłem szacunek do kilku inżynierów, po których spodziewałem się więcej, a którzy publicznie twierdzą, że nadaje się do codziennej roboty. Sam jestem częściowo winny: nie sądziłem, że przepaść jest tak wielka i że używanie go będzie tak męczące. Do tego kwestia abonamentu — jest obrzydliwie drogo, zwłaszcza że od 1 grudnia cena idzie w górę dwukrotnie. Tak, za trzy tygodnie ten model podrożeje o sto procent.
Skala problemu
O czym w ogóle mówię? Mam w Google wielu znajomych, którzy bardzo dobrze znoszą moje wybuchy, naprawiają, co się da, i realnie poprawiają sytuację. Wiem na pewno, że obecnie całą ekipą walczą z problemami prędkości, o które marudzę. Ale musicie zrozumieć, jak jest źle.
W poprzednim filmie pokazałem, że gdy nie ustawiacie maksymalnego wysiłku rozumowania — a nie powinniście, to zły pomysł — Gemini 4 Carbon jest zdecydowanie najwolniejszym współczesnym modelem. Nie ma konfiguracji, w której Opus kończy zadanie dłużej niż Gemini 4 Carbon. Fable 5 na poziomie XH jest odrobinę wolniejszy od Carbona na poziomie high, ale na poziomie high jest szybszy niż cokolwiek, co Carbon w ogóle ukończył.
I taki obraz jest błędny oraz wprowadza w błąd, ponieważ liczy się czas od oficjalnego przyjęcia żądania przez serwery Google do nadejścia odpowiedzi — a większość testów na Artificial Analysis to nie zadania agentowe, tylko pojedyncze żądania. (Informacja dodatkowa: Artificial Analysis to serwis porównujący modele AI pod kątem szybkości, cen i jakości, opierający się głównie na jednoetapowych pomiarach.) Gdy wchodzicie w wielokrokowe tury — czyli, niespodzianka, w sposób działania dosłownie każdego narzędzia do kodowania z agentami — ten obraz rozsypuje się błyskawicznie.
Po analizie własnych danych okazało się, że w codziennej pracy Gemini 4 Carbon był konsekwentnie pięć razy wolniejszy. Ale ta liczna jest zaniżona. Dziewięć razy u mnie Carbon występował jako sędzia. (Informacja dodatkowa: „sędzia” to model oceniający wyniki innych modeli — popularny wzorzec nazywany LLM-as-a-judge.) Po pierwszych trzech podejściach coś się zmieniło: zaczęły się masowo pojawiać komunikaty „stopped by the parent” — zatrzymane przez proces nadrzędny. Wiecie dlaczego? Był tak wolny, że zaktualizowałem skillę moich agentów — czyli instrukcję, którą dostają — o zasadę: „wygląda na to, że Carbon jest bardzo powolny; jeśli na nim czekacie, a macie pracę do poprawienia, nie czekajcie — przerwijcie i wracajcie do roboty”. Gdybym tego nie zrobił, liczby byłyby gorsze. Przypadkowo dałem mu tu przewagę. Więc nie tylko jest znacznie gorzej, niż pokazałem w pierwszym filmie — jest znacznie gorzej, niż pokazuję teraz. Nie wiem, o ile, bo nie zamierzam tyle spowalniać własnej pracy, żeby to rzetelnie zmierzyć. Nigdy nie dowiem się, ile czasu zajmuje ręczne karmienie żółwia całą główką sałaty, bo jestem zajętym człowiekiem i nie zamierzam przy tym siedzieć. To szaleństwo. Jest tak źle.
Krok po kroku: 11 sekund ciszy przed startem
Robi się znacznie gorzej, gdy zobaczycie przyczyny. Pomyślicie: „to pewnie tempo generowania tokenów (TPS), nie dają mu dość mocy obliczeniowej, może źle równolegli wywołania narzędzi”. To wszystko prawda. I wszystko to razem daje jakieś 30–50% spowolnienia. Pięciokrotnego spowolnienia nie da się wytłumaczyć wywołaniami narzędzi. Dobrze — da się, jeśli robi się je skandalicznie źle. Oni nie robią ich aż tak źle; są blisko. Prawdziwy problem zaczyna się, zanim żądanie w ogóle dotrze do modelu. Ten model konsekwentnie potrzebuje ponad 11 sekund od przyjęcia żądania przez serwer do rozpoczęcia czegokolwiek. Jedenastu sekund.
Przejdźmy przez to razem w czasie rzeczywistym. Po prostu tu posiedzę i wspólnie zaznamy zen z Gemini 4 Carbon. (pauza) Wciąż leci. (pauza) Dobra, dwa z trzech skończone. Fable w tym demie odpalił wolne wywołanie narzędzia, ale i tak zdążył. I teraz Gemini też skończył. To było jedno zadanie — jeden krok, nie pełna tura. Dołóżcie do tego fakt, że Gemini potrzebuje więcej kroków, żeby skończyć pracę, i te dodatkowe 11 sekund co 20 sekund kumulują się przy każdym żądaniu. Wynik jest nie tylko żenujący — jest po prostu nieużywalny.
I im bardziej próbowałem używać Gemini do prawdziwej pracy, tym wyraźniej widziałem, że nie tylko źle oceniłem inteligencję tego modelu — własną przeceniłem jeszcze bardziej, bo czułem się kompletnym idiotą, że w ogóle wybrałem narzędzie tak męczące w obsłudze.
To już się kiedyś zdarzyło — przypadek Azure
Pomyślicie pewnie, tak jak mój czat: jak to, nikt tego nie zauważył? Jak do tego doszło? Widziałem to już raz. Ta mała firma robiąca trochę rzeczy z AI — kojarzycie — Microsoft. Azure miał podobny problem z modelami OpenAI: zwykle pierwszy token dostawaliście w 10–15 sekund, ale zdarzały się okresy po 100–200 sekund. Efekt: najbardziej zawodny, nieużywalny złom świata. Tak u nich wybuchnąłem, że odezwali się do mnie ludzie z zarządu — i w końcu naprawili. Tak, ten incydent za milion dolarów; mam o nim osobny film i jestem z niego dumny. I dlatego jestem tu dziś. Różnica jest taka, że teraz nie mam nic do stracenia, bo nikt nie lubi Gemini. Tamtego razem na szali stał milion dolarów, a teraz robię to z czystej pasji.
Przepraszam, DeepMind — ale Varun nie
Po co ten drugi film o Gemini? Jak mówiłem, jest mnóstwo ludzi w DeepMind, których naprawdę cenię; spośród wszystkich labów to im najbardziej zależy na moich uwagach i najchętniej coś naprawiają. Znoszą też moje wybuchy. Dlatego przepraszam znajomych za ten materiał. Mam nadzieję, że będzie użyteczny — jako dźwignia na wewnętrznych spotkaniach do uporania się z tymi wstydami, a jeśli to nie zadziała (uczciwie mówiąc: może nie zadziałać), jako najlepszy list polecający, gdy znajdziecie sobie pracę w prawdziwym labie. Bo na tym etapie nie nazwę DeepMind prawdziwym labem, skoro nie tworzą technologii, której da się realnie używać.
I choć szanuję większość ludzi, z którymi rozmawiam w DeepMind, teraz zejdę na personalia, bo nie szanuję Varuna. (Informacja dodatkowa: Varun — współzałożyciel Windsurfa, edytora kodu z AI. Theo zarzuca mu tutaj, że odchodząc do DeepMind zabrał technologię, zostawiając zbudowany przez siebie zespół z niczym.) To gość, który ukradł miliard dolarów własnemu zespołowi po to, żeby rzucić firmę, którą założył, i przejść do DeepMind z całą technologią. Nigdy nie widziałem czegoś takiego — a widziałem ludzi, którym naprawdę zależy na zespole, którzy stracili dużo pieniędzy, żeby postąpić wobec niego uczciwie, którzy mogli zostać osobiście wykupieni za wielkie pieniądze, a odmówili, bo chcieli, żeby ich ludzie też wygrali. U mnie udziały w t3 tools and code są rozdzielone po równo ze Markiem, a Julius jest tuż za nami. Jedyni, którzy na Windsurfie zarobili cokolwiek, to on i jego dwaj kumple. Odpuścili 130-osobową firmę, którą zbudowali — zostawili ją na pastwę losu — a sami wzięli swoje. Powiem wprost: schodzę na personalia, bo chcę sprawdzić, czy Varun zniesie presję. Chcę, żeby wiedział, że uważam go za człowieka bez kręgosłupa. Że uważam go za złego lidera. Że sposób, w jaki zareagował na moje zgłoszenie, jest nie do przyjęcia.
Po pierwsze: odparł, że to „wielki komplement”, zamiast uznać opisane problemy — dla kontrastu: absolutnie wszyscy inni w DeepMind podeszli do tego fenomenalnie. Przez ostatnie dwa dni bez przerwy pisali do mnie, prosząc o uwagi i próbując z całych sił poprawić modele i narzędzia. A on: emoji ze śmiechem i jakiś irytujący, choć przydatny komentarz — bo wybuchłem o tym, że ich CLI za każdym razem eksponuje mój adres e-mail. Poprosiłem, żeby zrobili z tego opcję konfiguracji. Odpowiedź: „Świetnie”.
Mniej więcej wtedy zacząłem kopać głębiej w kwestii prędkości, bo używałem tego coraz więcej i coraz bardziej mnie to wkurzało. Jeszcze nie wiedziałem dokładnie, co jest przyczyną, ale przyjąłem pewne założenie — akurat analizowałem, jak Gemini obsługuje wywołania narzędzi, i okazało się, że robi je równolegle (sądziłem, że nie, a jednak), więc nie rozumiałem, skąd ta powolność. Poleciłem film, który kiedyś nagrałem o przejściu OpenAI na websockety w inferencji Codexa. Powód — o którym już mówiłem, obejrzyjcie tamten materiał — w skrócie: model potrzebuje całej historii rozmowy. Przy każdym kolejnym kroku trzeba było wysyłać ją w całości, co dawało ogromne opóźnienia: wysyłka, parsowanie, dopasowanie do cache, wstępne przetworzenie kontekstu (prefill) i załadowanie — od nowa przy każdym wywołaniu narzędzia. To była góra narzutu. I to jeden z powodów, dla których Codex kiedyś był tak wyraźnie szybszy od Claude’a: postawili przed inferencją warstwę łączącą się websocketem, wysyłającą mniej danych i trzymającą połączenie „ciepłe”. Działało świetnie. Nie wiem, jak Anthropic dogonił ich bez websocketów, ale dogonił — i to już jest dobre. Sądzę, że sporo z tego to zmiany w cache’u.
Wtedy Varun odpisał: czas na odpowiedź; czas do pierwszego tokenu jest po prostu wysoki, bo prefill nie jest tani; to nie tylko kwestia transportu sieciowego. Tu ma rację — to prawda. I dalej: pozwól, że to oszacuję, ale nie jestem pewien, czy rozwiązałoby to problem od ręki. Muszę mu to oddać: pewnie nie rozwiązałoby. Ale byłem wystarczająco zirytowany, żeby kopać dalej. I wtedy znalazłem te dużo, dużo bardziej szalone liczby.
Liczby, które mówią wszystko
Gemini 4 Carbon potrzebuje więcej czasu na rozpoczęcie odpowiedzi niż 61 Soul na jej zakończenie — w większości scenariuszy. Obłęd. Do tego te zabawne akcenty, jak choćby to, że średnio wczytuje jeden plik 8–16 razy. Kapitalne. Nie mam wrażenia, że rozumiecie, jak daleko w tyle są. To nie jest pierwszy, drugi i trzeci zawodnik. To pierwszy i drugi — a potem ktoś z zupełnie innej szkoły. Dwóch najlepszych studentów na roku i dziecko, które cztery razy powtarzało zerówkę, po czym rzuciło szkołę. Tak jest źle. I to mimo że ten kontekst jest już w cache’u!
Mówię to od dawna i poruszyłem w poprzednim filmie o Gemini: oni są beznadziejnie fatalni w obsłudze cache’u. Jako jedyny lab, u którego zapisujecie coś do cache, potem czytacie z cache — i w 30% przypadków nie odczytuje tego, co przed chwilą zapisaliście. Przeczyta z czegoś: może z cache’u sprzed pół godziny, może nie uda się wcale. Tak jest źle. I to jest cena za to, że spróbowałem realnie użyć tego modelu — bo pierwszy raz od ponad półtora roku znalazłem coś, co Gemini robi dobrze, i miałem powód, żeby wziąć go do codziennej pracy. Przez ostatnią dobę prób, czułem, że tracę rozum.
Odpowiedź „u nas tego nie widać”
Problem z Google nie kończy się na tym, że modele Gemini są męczące we współpracy. Cała reszta kruszy się pod ciężarem firmy, która nie wie, co robi. To szaleństwo. I nie zgadniecie, kto odpowiedział na ten tweet. Podpowiem: ktoś, kogo nie lubię. Cytat: „Nie tego widzimy na naszych obciążeniach”. Radzę ci, Varun: pisz do mnie prywatnie. Nie podoba mi się, jak angażujesz się ze mną publicznie — to źle wygląda na nas obu. Najlepsze, co możesz teraz zrobić, to przyjąć do wiadomości, że wiem, co robię — bo wiem, że ty wiesz. Jesteś ewidentnie bardzo inteligentny, znasz się na swojej robocie. Po prostu jesteś złym liderem. Więc w przyszłości pisz do mnie prywatnie, najlepiej z co najmniej jeszcze jedną osobą w rozmowie, żebyś poczuł lekki wstyd, gdy powiesz coś głupiego. Może ktoś z ekipy Gemini — na przykład Phillip, z którym miałem mnóstwo naprawdę dobrych rozmów; jest sporo innych ludzi w tych dyskusjach, naprawdę zaangażowanych, którym zależy. Gdyby to oni dowodzili, byłoby dobrze.
I chętnie przekażę wam wszystko, co uruchamiałem: każdy prompt, każde środowisko, dosłownie wszystko — jeśli to pomoże to naprawić. Bo chcę, żebyście to naprawili. Chcę następnego gracza w tym wyścigu. Chcę używać Gemini 4 Carbon do tych rzeczy, w których jest dobry, i chcę, żeby kolejny model też był dobry. Ale na ten moment model nie jest na tyle dobry, żeby go używać. A nawet gdyby był — koszt nie jest na tyle dobry, żeby płacić. A nawet gdyby był — prędkość jest tak niska, że będziecie nieszczęśliwi. Każdy aspekt używania tego modelu to piekło. Wszystkie. No dobrze, jeden jest nieco lżejszy: mówi mniej oklepanych formułek w stylu GPT niż same modele GPT. I to jest cała lista. Nie potrafię poważnie traktować nikogo, kto w tej chwili wybiera Gemini. Jest tak ewidentnie zły, że nawet przy najlepszych chęciach doprowadza mnie do coraz większej wściekłości.
API rozjechane z resztą świata
Trafiła mi się sugestia, że subskrypcje są wolniejsze, a API szybsze. Zabawnie: ktoś inny w odpowiedziach właśnie wykazał odwrotnie. Hosting Gemini 4 Carbon na Vertexie jest nieużywalny. W praktyce trzeba łamać regulamin i korzystać z endpointów Antigravity. (Informacja dodatkowa: Antigravity to środowisko programistyczne od Google; „endpointy Antigravity” to punkty dostępowe jego API, formalnie przeznaczone dla tego produktu.) Do tego poziom wysiłku rozumowania wpisują w sam identyfikator modelu, zamiast w osobne pole, jak robią dosłownie wszyscy inni — co psuje nam całą analitykę. Czuję, że Google nie wie, gdzie w tej chwili jest reszta świata. Uderza mnie to, że Meta wydaje nowy model Muse i on po prostu pasuje do wszystkiego, co robię. To zwykły model, z własnymi dziwactwami i zaletami — wtykacie go w narzędzia, przełączacie się i działa. Jedyny minus: Muse Wonderful nie ma w API i trzeba go używać przez subskrypcję. W ciągu jednego dnia używania Gemini przeżywam więcej dziwactw niż ze wszystkim, co Meta kiedykolwiek wydała. A produktami Meta jestem od czasów liceum, jeszcze na Facebooku.
Mam tego naprawdę dość. Powiem szczerze: nawet nagrywanie tego filmu jest mi przykre — ale bardziej przykre jest to, że poprzednim zdecydowanie wprowadziłem część ludzi w błąd, sugerując, że model Gemini może w końcu nadawać się do użycia. Nie nadaje. I nawet gdyby był dwa razy inteligentniejszy, używalny stałby się dopiero wtedy, gdyby był na tyle sprytny, żeby postawić go na ich wewnętrznej infrastrukturze i naprawić im całą tę zepsutą maszynerię. Dopóki tego nie zrobią — powtarzam po raz kolejny — poznacie, że Google w końcu stworzył świetny model, dopiero kiedy ich produkty i infrastruktura przestaną się rozsypywać. Bo dziś to pogorzelisko. I wiedziałem, że jest źle. Ale nie uświadomiłem sobie, jak bardzo, dopóki nie policzyłem, ile czasu Carbon — w prawdziwych zadaniach, nie w pojedynczym kroku, ale w całej turze — spędza na czekanie na rozpoczęcie odpowiedzi. Ten model czeka na start odpowiedzi dłużej, niż Opus i Soul zajmuje odpowiadanie — prawie łącznie. Nie używajcie tego modelu. Może kiedyś w końcu się tym zajmą i przestaną udawać, że to drobiazg z prefillem.
Ostatni „verunizm” i finał
Na koniec jeszcze jedna wypowiedź Varuna: „Patrzymy, jak to zoptymalizować. Zawsze jest kompromis między opóźnieniem a kosztem, ale powinniśmy robić to lepiej.” Tego rodzaju odpowiedź brzmi dobrze — dopóki nie zauważysz, że model na zrzucie ekranu jest w nim najdroższy, najgorszy, najwolniejszy i najmęczniejszy w obsłudze. To w praktyce przyznanie się, że nie są w stanie dotrzymać kroku na żadnej osi. To już nie jest „Gemini jest o 5–10% gorszy w niektórych rzeczach”. Jest o rząd wielkości gorszy w praktycznie każdym scenariuszu. I mam dość udawania inaczej.
Zakończę znakomitym komentarzem z czatu — dzięki, a_lack_of_hygiene: „Przyjaciele nie pozwalają przyjaciołom używać Gemini.” Wyczerpałem temat. Wracam do niekorzystania z Gemini, chyba że nagrywam recenzję — i może kiedyś to w końcu zacznie działać jak trzeba. Do tego czasu, serio: kupcie sobie Claude’a za 20 dolarów. Wyjdzie z tego więcej inferencji, więcej wartości, więcej zrobionej roboty. Nie ma ani jednego powodu, żeby teraz dobrowolnie sięgać po model Gemini — do czegokolwiek. Po prostu się zasmucicie. A jeśli jakoś się nie zasmucicie, zacznijcie szukać nowej pracy, bo ten świat nie jest już dla was w branży deweloperskiej.
Zwariuję. Idę robić dosłownie cokolwiek innego. Mam nadzieję, że podobał wam się ten wybuch złości.